GPU服务器增加显卡后,训练不一定按卡数同比加速。本文将帮助你把验收拆成硬件清单、互联拓扑、集合通信和真实训练四层,区分“能看到多张卡”“通信正常”和“任务确实更快”,避免用一张理论带宽表替代业务测试。
NVLink是NVIDIA的一类高速互联技术,但是否支持、连接哪些设备和采用何种拓扑,都要落实到具体平台。购买Hostease或其他服务商的GPU资源时,应先索取准确型号、板卡形态、互联结构与可测试范围,不要仅依据“A100服务器”或“多GPU”名称推断能力。本文提供核验方法,不给出未经实测的加速倍数。
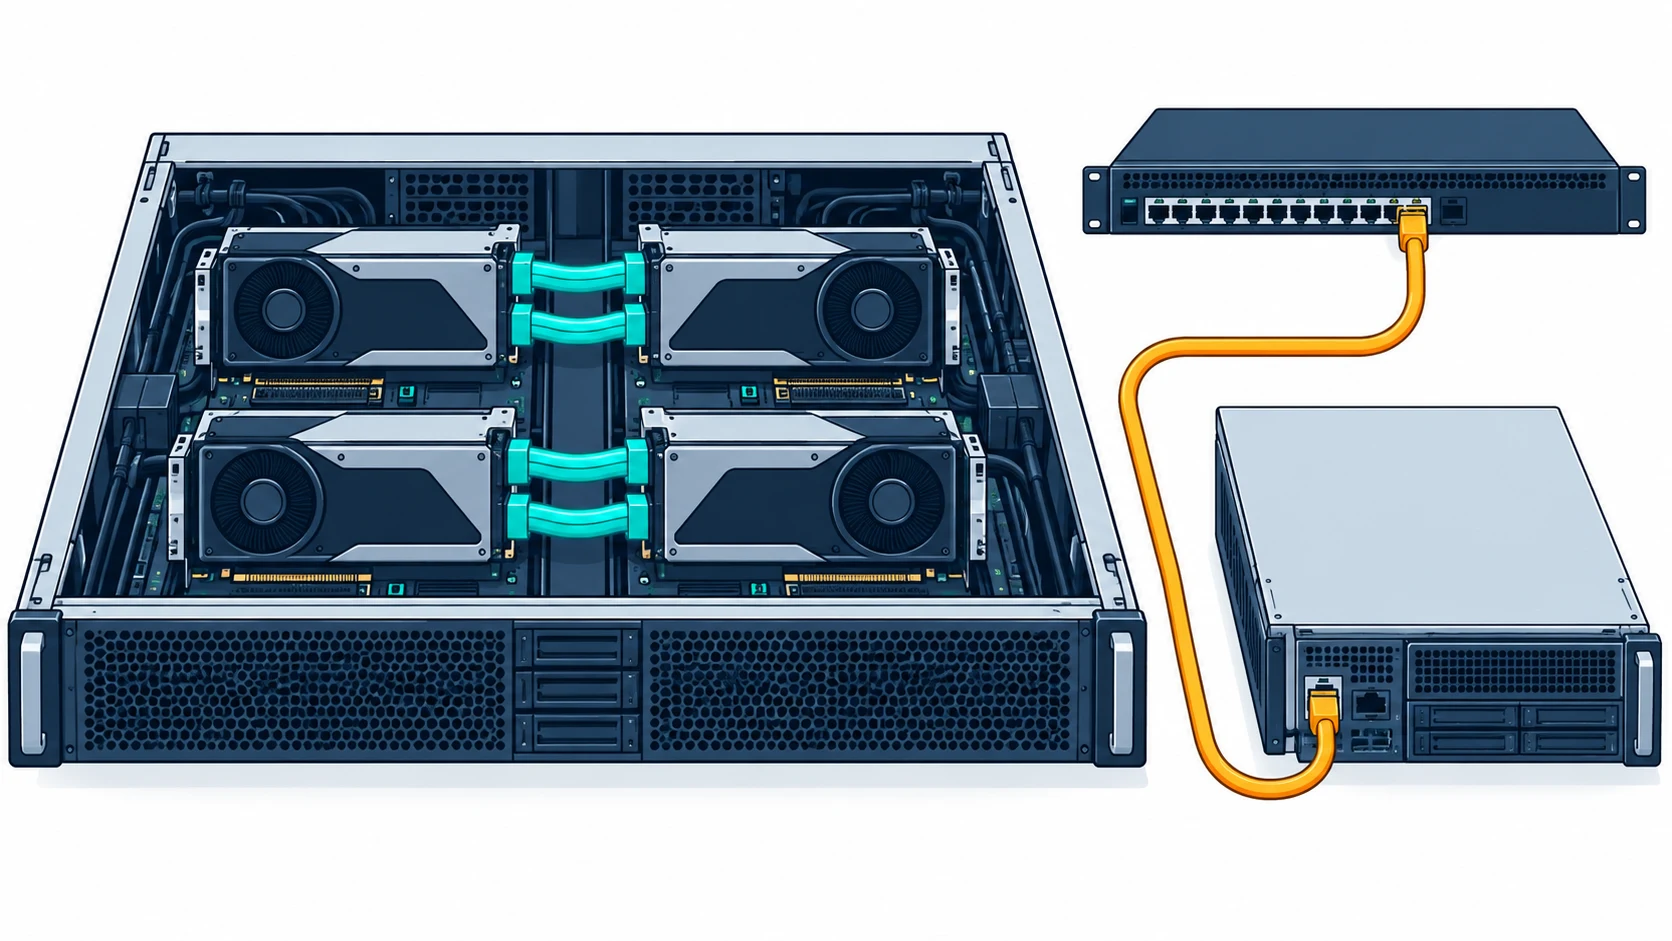
先把验收对象写清楚
记录GPU完整型号、数量、显存规格、驱动和软件环境,同时注明是否为虚拟化或资源切分环境。后者可能影响可见拓扑与管理功能;工具输出不支持某项指标时,应保留原始状态并向平台确认,不能把缺失值记成零。服务器端的CPU、内存和数据盘也应纳入清单,否则数据装载瓶颈可能被误认成卡间互联问题。
若还在比较承载平台,可以参考海外服务器比较维度整理交付条件,再增加GPU专属字段。通用云服务器是按需提供计算资源的运行环境,并不天然具备特定GPU或NVLink连接;实际资源应以合同、交付信息和机器核验共同确认。
GPU服务器NVLink拓扑与训练扩展验收要点
官方验收基础与能力边界。拓扑核验参考NVIDIA nvidia-smi文档:nvidia-smi topo -m输出卡间连接矩阵,NV#表示由相应数量NVLink组成的连接,PIX/PHB/SYS等标记区分PCIe交换、主桥和跨NUMA路径;NCCL Tests(all_reduce、all_gather、reduce_scatter、broadcast等)验证集合通信可用性与不同规模下的稳定性。拓扑输出描述可见连接,通信测试验证该测试条件下的结果;即使两者符合预期,不能直接等同于训练整体性能达标,最终验收结论必须用真实训练负载另行验证。
NVLink支持取决于具体型号与板卡形态。是否具备NVLink要落到具体SKU与物理形态判断:SXM基板一体化互连,或PCIe卡加桥接器,桥接器覆盖卡数与配对方式各不相同,不能只看A100/H100家族名称推断;RTX 3090规格列有NVLink支持,不能笼统宣称“消费卡一律没有NVLink”。一切以官方规格表与实物桥接器为准。
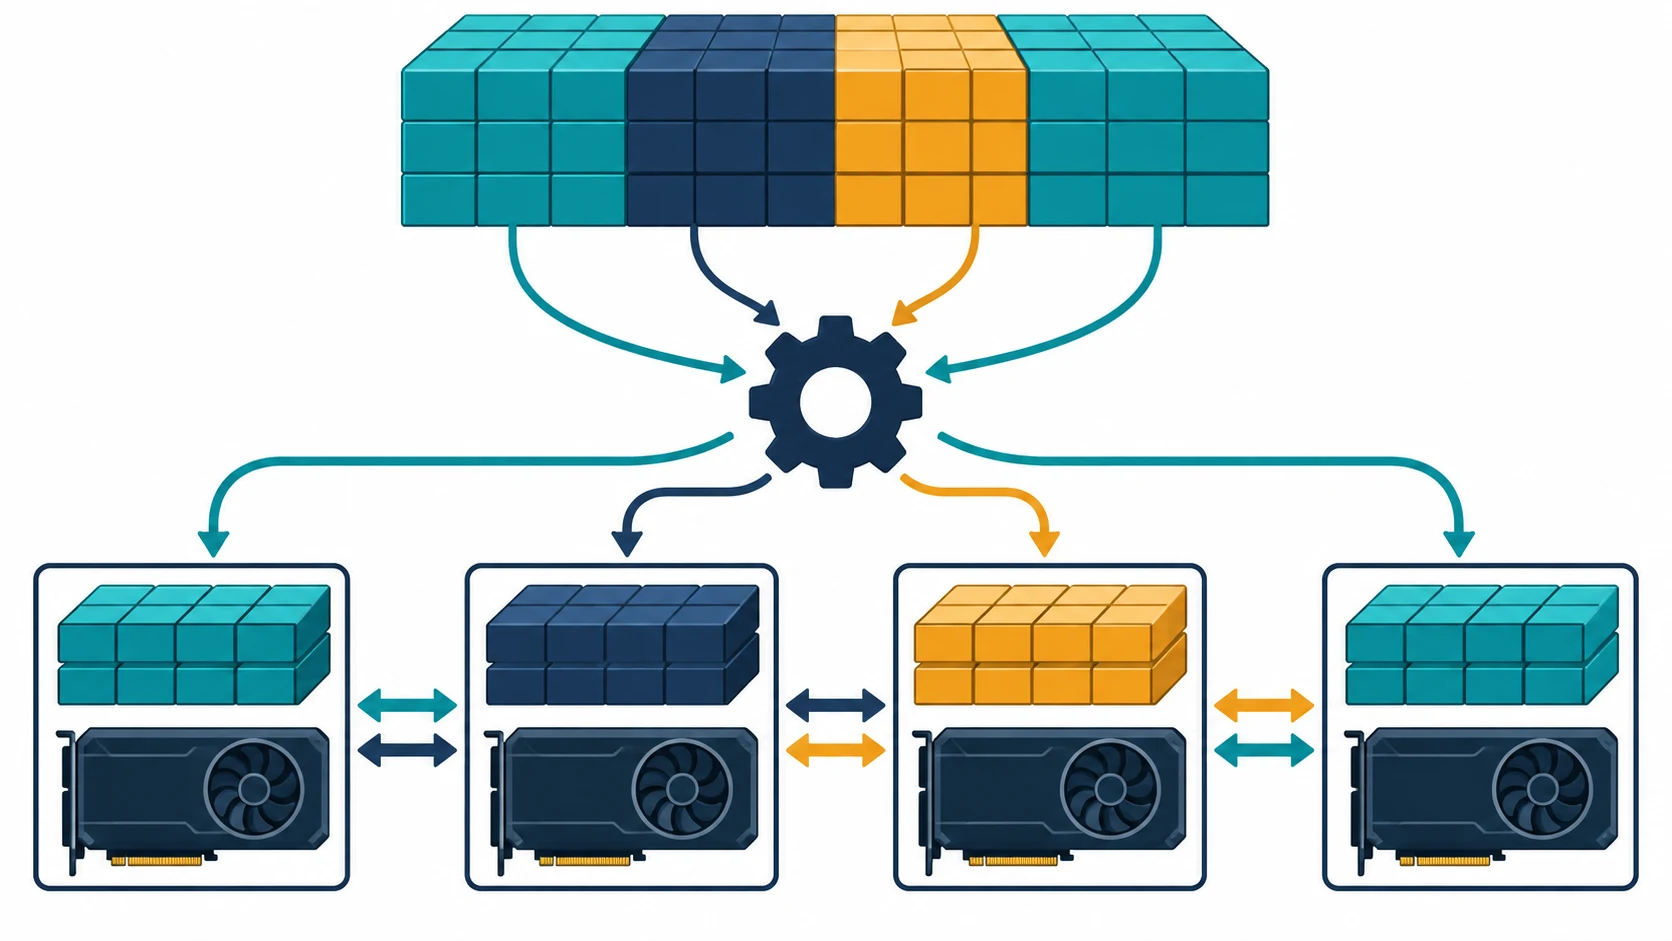
显存不会自动无损池化。具备NVLink不等于把多卡显存合并成一块大显存;跨卡使用显存必须依赖框架侧的模型并行、张量并行、流水并行等切分策略,并伴随通信与同步开销,实际可用容量与效率取决于具体实现,需在框架配置中显式启用并以实测为准。
PCIe与跨节点网络分层验收。PCIe拓扑下GPU间P2P访问不一定都经过CPU内存拷贝,是否可用取决于驱动、拓扑与NCCL等工具的实测结果,须逐台确认;单机内NVLink与跨节点网络(IB/RoCE等)属于两个不同层面,协议、指标与瓶颈不同,不能混为一谈、互相替代。
公平测试与报告口径。对比测试须固定模型结构、数值精度、batch设置、数据装载方式与软件栈版本(驱动、CUDA、NCCL、框架);报告吞吐、每步步时、显存占用、通信时间占比,并区分弱扩展(规模与全局batch同增)与强扩展(固定问题规模)两类场景,分别给出扩展效率与衰减趋势。
先做通信测试,再解释训练结果
集合通信是多张卡协同交换或汇总数据,例如AllReduce把各卡的数据做归约并分发结果。测试时应覆盖实际任务可能使用的消息规模,保留完整命令、版本、卡数和输出。不要只截取最大消息的一行带宽,也不要把不同操作或不同进程布局混在同一比较表中。通信正确性检查与性能数值都需要保存,出现错误时先排查环境。
测试工具需要按其官方说明编译或安装,确认使用的是预期CUDA和NCCL版本。共享服务器上应先获得测试窗口并限制资源范围,避免影响其他训练任务。若准备新环境,可对照服务器上线检查步骤完成登录、存储和恢复入口验证,再安装训练软件;通用部署文章不能替代GPU驱动的版本兼容说明。
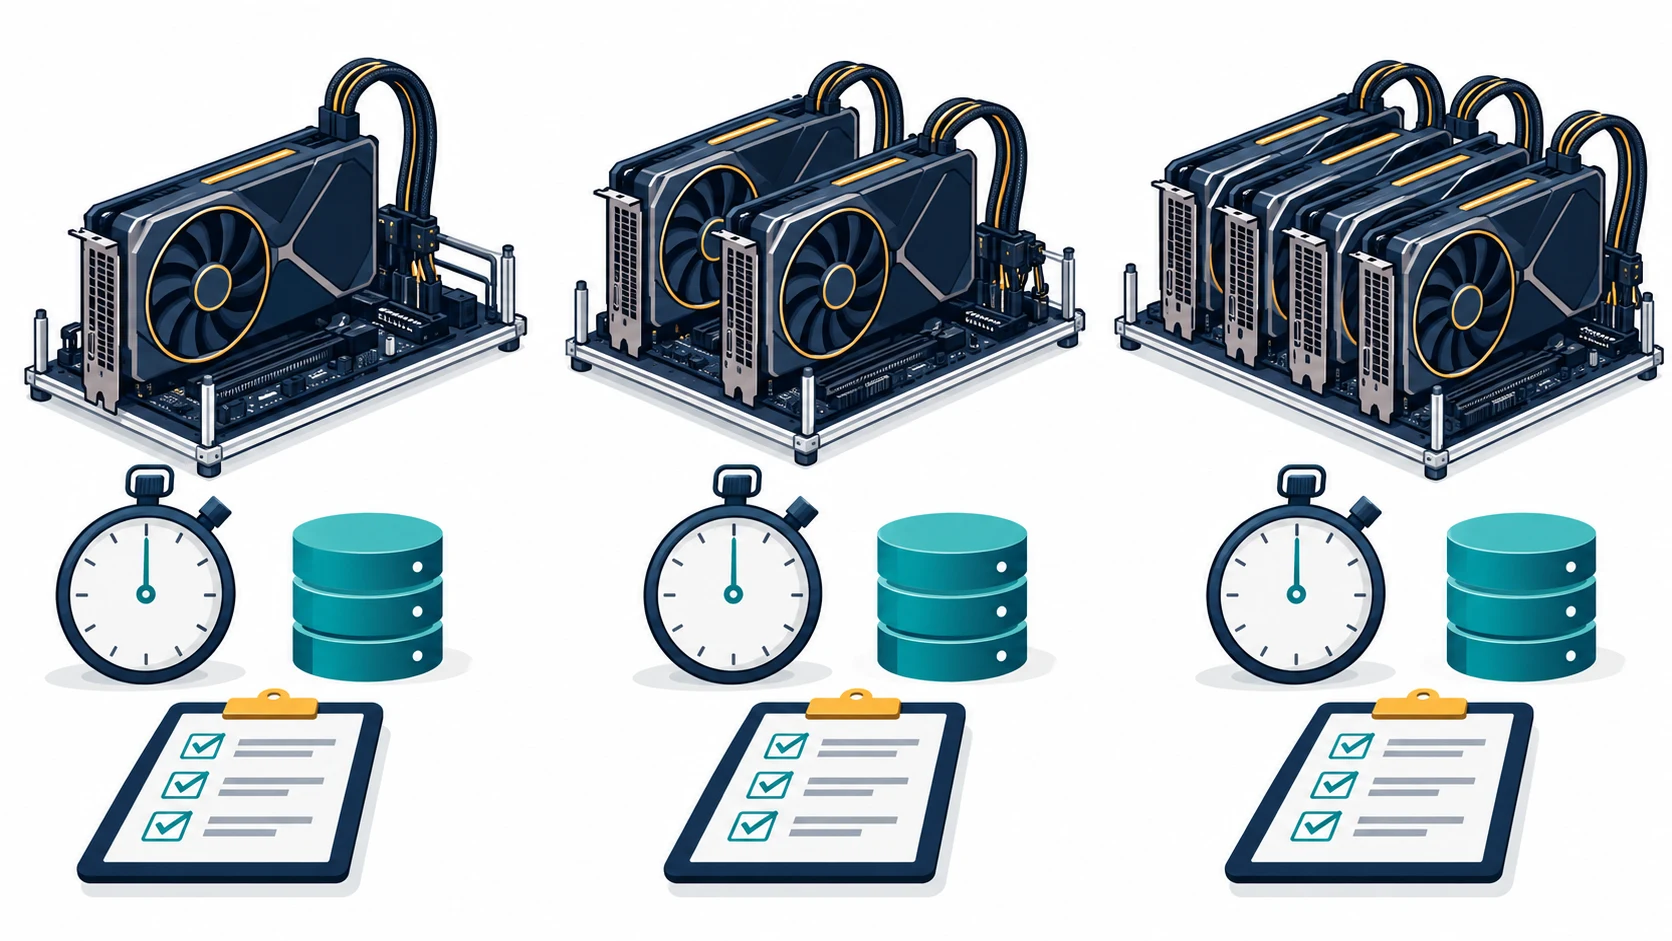
真实训练需要公平的比较基线
固定模型、数据集、精度和训练目标,并记录预热与测量区间。固定全局batch时,增加卡数会减少每卡工作量,通信开销可能更明显;固定每卡batch时,全局batch随卡数增加,吞吐提升并不自动代表达到同一训练质量所需时间更短。报告中应明确采用哪种口径,并记录优化器、梯度累积和并行策略是否变化。
单卡装不下模型时,不能构造一个不存在的单卡速度来计算加速比。可以报告多卡方案能够运行,以及在可比较的多卡配置之间测得的步时和成本。显存用量也不只是参数大小,还包括梯度、优化器状态、激活和框架预留;能启动并不代表长期运行不会出现内存不足。
通信很快而训练很慢时怎么办
沿时间线检查数据读取、预处理、主机到设备传输、计算与同步。某张卡持续等待时,检查数据分配和负载是否均衡;所有卡同时等待时,继续看存储、CPU和外部依赖。多节点任务还需独立核对网卡、交换网络与通信配置,不能由单机NVLink测试推断跨节点表现。
远端数据集下载慢还可能与解析或网络路径有关,可参考DNS解析检查方法定位下载阶段,但不要把外网下载性能写成GPU计算性能。正式测量应说明数据是否已预先放在本地,缓存状态是否一致,避免首轮下载改变结果。
为什么两次测试不能只比较最高值?
功耗限制、温度、后台任务和数据缓存都可能改变一次测试结果。应重复相同条件的测量,报告中位数或合理的区间,并保留异常轮次的原因。不要为了获得更好成绩,在其中一组降低精度或缩短输入长度;如果这些变化属于优化方案,就单独列出配置差异和正确性验证。测试结论应注明适用模型与工作负载,不能从一个小模型的结果推断所有训练任务。
交付报告应回答哪些问题
报告应让另一位工程师复现:拿到什么硬件,看到什么拓扑,通信测试是否正确,真实训练达到什么指标,哪些条件仍未验证。对于采购,可结合服务器选型清单补充费用、支持和恢复条件,以实际完成任务的成本比较方案,不把卡数或理论峰值作为唯一依据。
如果你需要验收新GPU服务器,可以考虑先保存型号和拓扑输出,再跑一组可复现的通信测试,最后运行真实训练。将硬件连接、框架分片和业务结果分别记录,确认每一层证据后再决定扩容。