GPU服务器NVLink验收:先看拓扑,再测通信与训练扩展
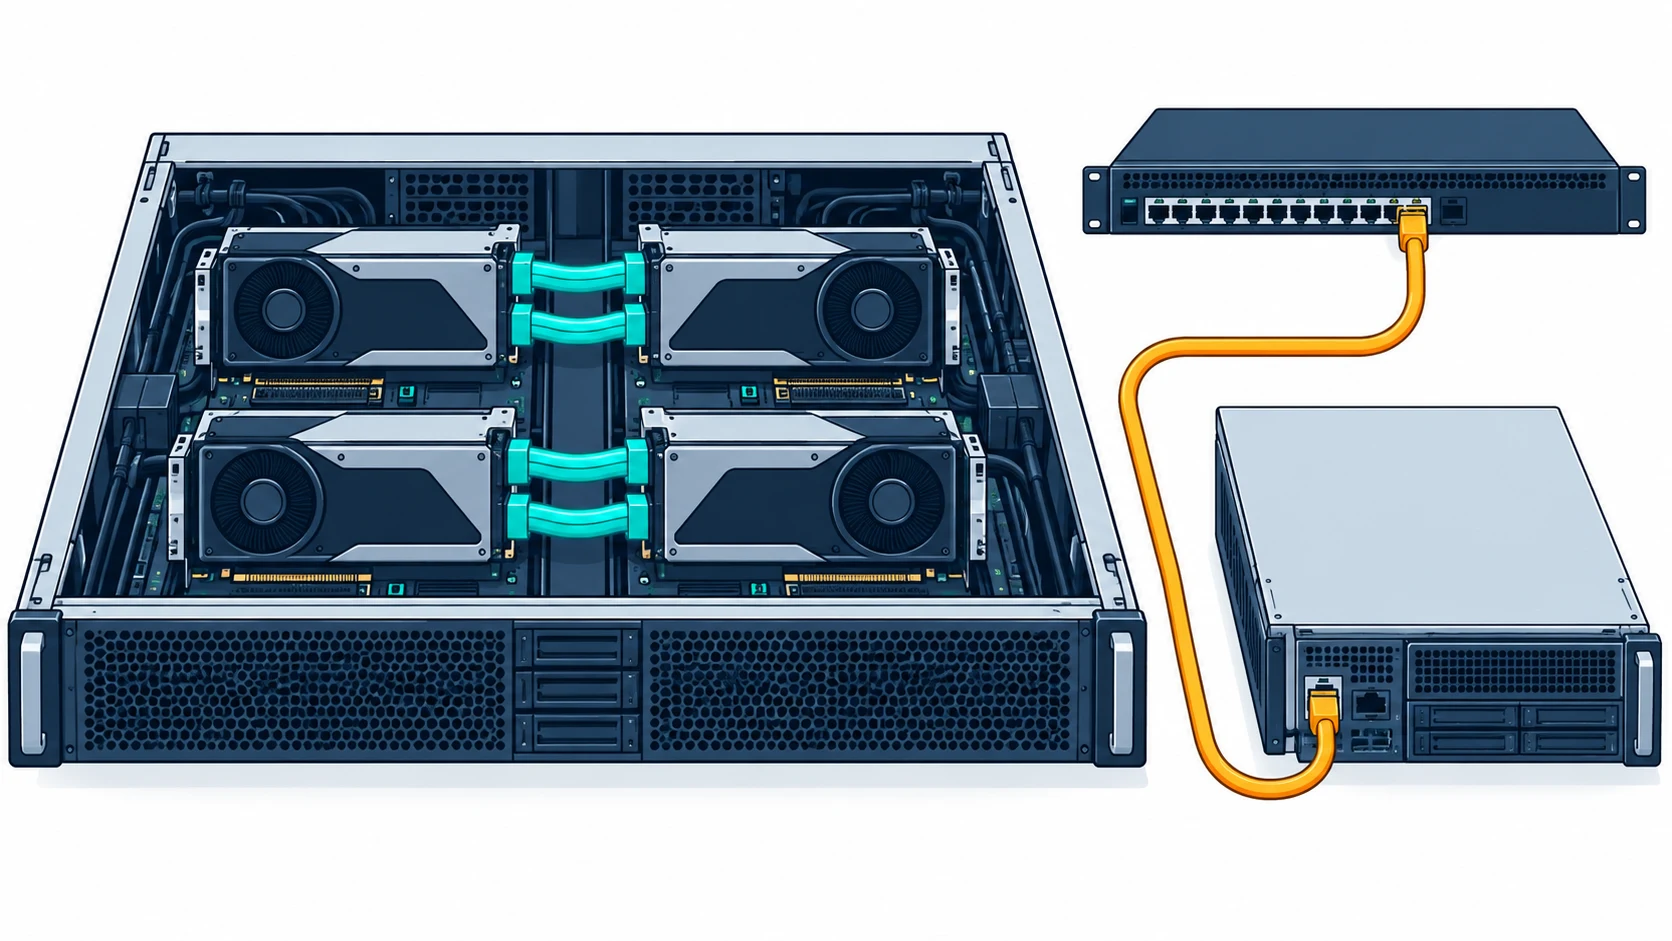
核对GPU具体型号与互联拓扑,用NCCL测试和真实训练分层验收,区分硬件NVLink、框架显存分片与跨节点网络,避免把多卡数量当成加速保证。
核对GPU具体型号与互联拓扑,用NCCL测试和真实训练分层验收,区分硬件NVLink、框架显存分片与跨节点网络,避免把多卡数量当成加速保证。
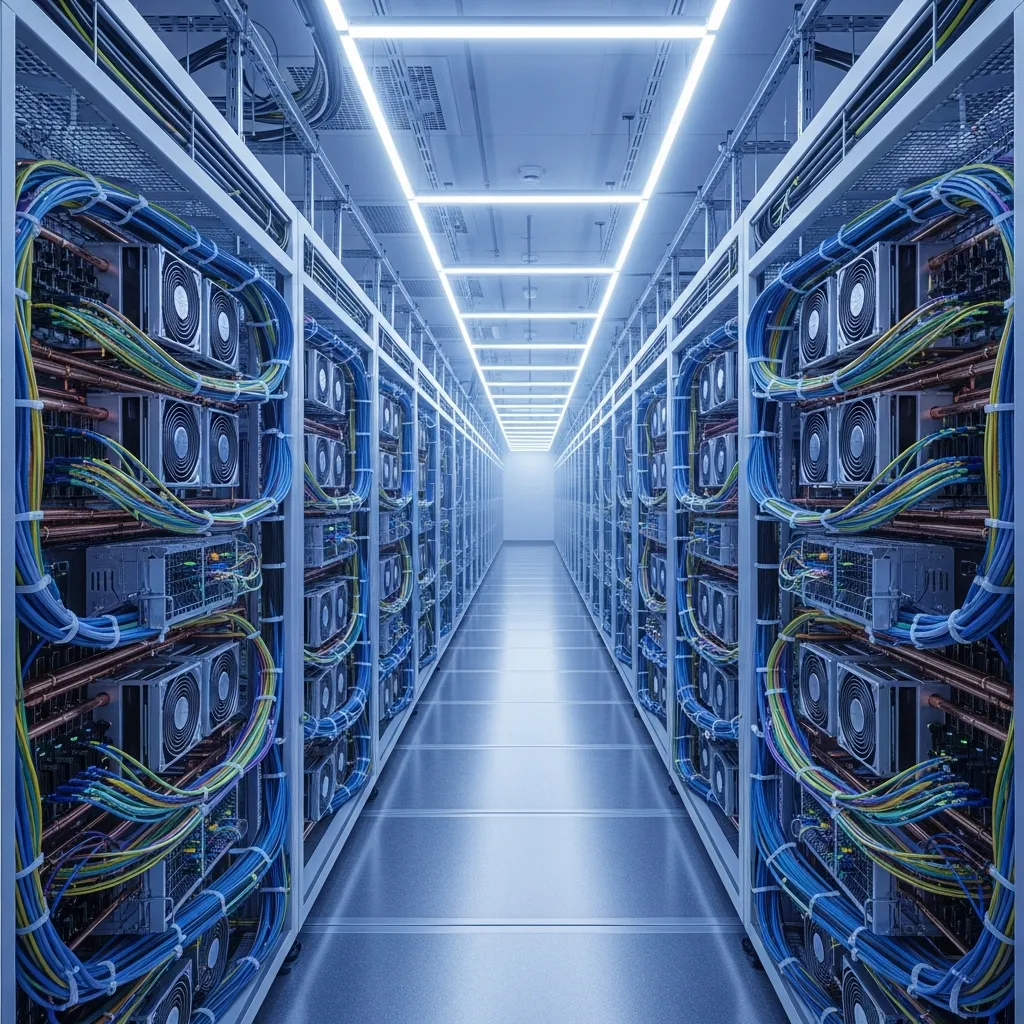
分布式训练跑不快,常常不是GPU不够,而是网络拖后腿。本文对比InfiniBandHDR/QDR、RoCEv2与传统以太网的带宽、延迟、RDMA与无损配置,解释它们如何影响NCCL的All-Reduce通信与GPU利用率,并给出从2节点到多节点集群的选型清单,以及在Hostease下单时可用的高速网络选项。
这是一份面向独立站卖家与工程新手的实操指南:用GPU云服务器训练ChatGPT类模型,怎么估算显存/算力/硬盘IO,如何选择分布式方案与部署架构,并给出不同规模下的配置清单与落地建议