GPU服务器NVLink验收:先看拓扑,再测通信与训练扩展
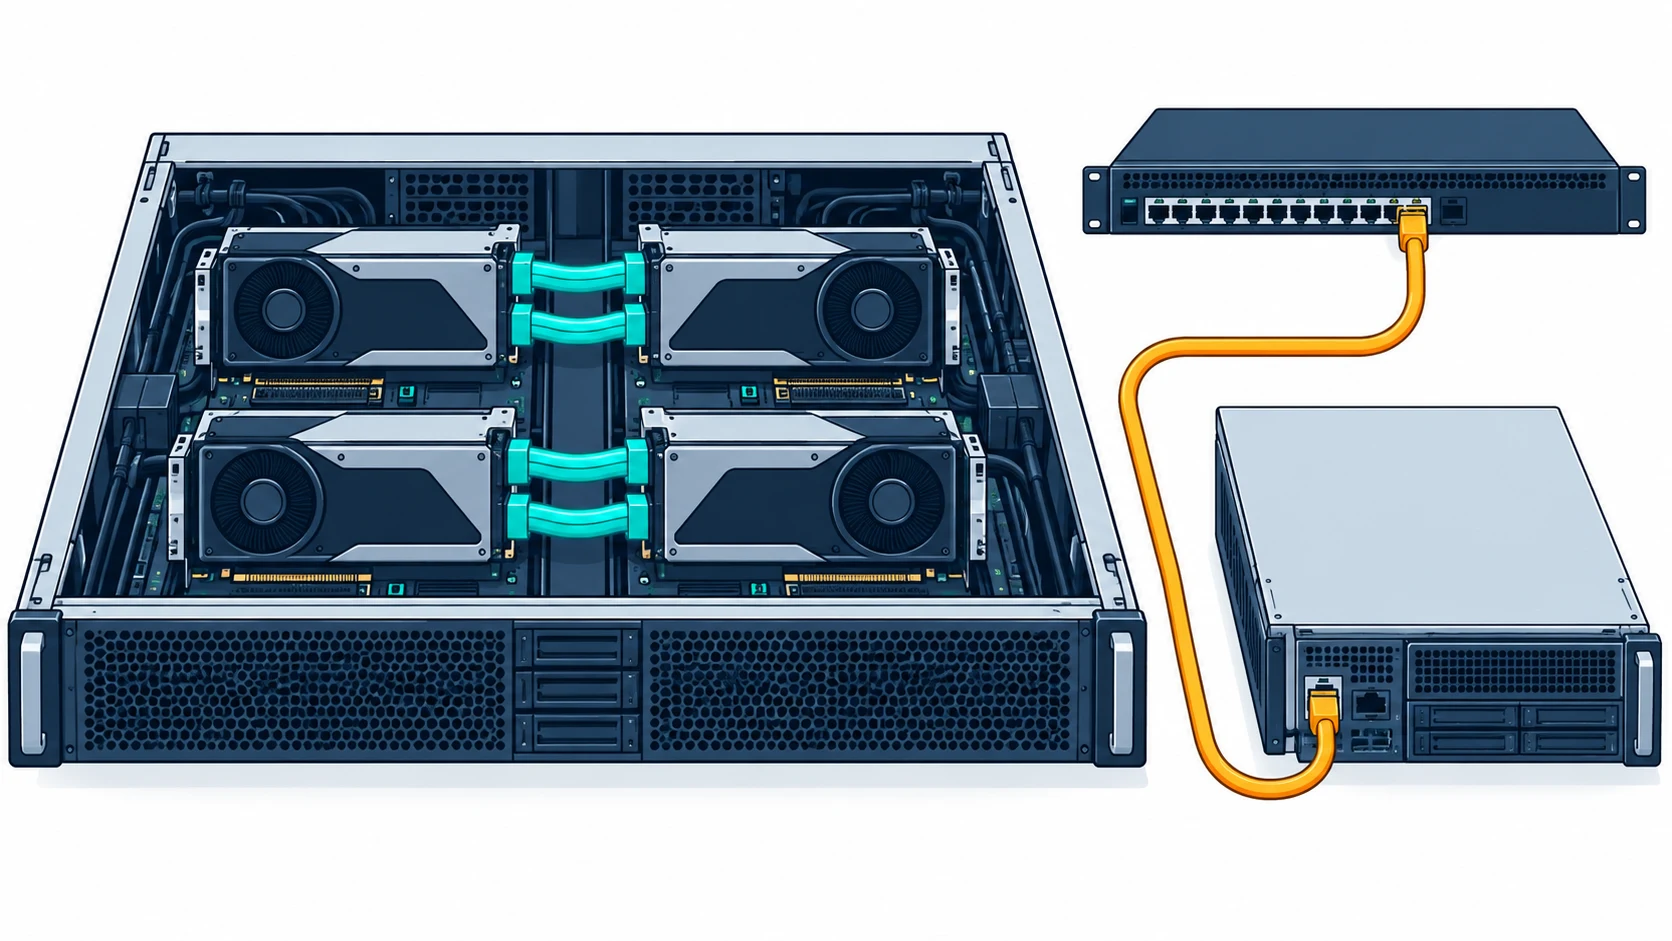
核对GPU具体型号与互联拓扑,用NCCL测试和真实训练分层验收,区分硬件NVLink、框架显存分片与跨节点网络,避免把多卡数量当成加速保证。
核对GPU具体型号与互联拓扑,用NCCL测试和真实训练分层验收,区分硬件NVLink、框架显存分片与跨节点网络,避免把多卡数量当成加速保证。

这篇文章带你一步看懂NVIDIA A100、H100和最新H200三代数据中心GPU在架构、显存容量与带宽、Tensor算力、NVLink互联等关键参数上的差异,并结合真实部署案例,聊聊大模型训练和推理该选哪一款GPU服务器、更适合怎样的业务场景,帮你少踩坑、选对配置。

训练大模型时,GPU算力再强也需要高速带宽和SSD存储支撑。本文结合实际场景,解读为什么选择GPU服务器不能只看显卡,带宽与存储才是训练效率的关键,并给出Hostease选型建议。