单台服务器扛不住并发,是业务增长后必然遇到的问题。很多人最先看到的信号不是监控大盘,而是用户报障”网站偶尔打不开、刷新一下又好了”——这就是 Nginx 开始频繁返回 502(后端不可达错误)的前兆,根源通常是单机过载或单点故障。本文教你如何用负载均衡(load balancing,把请求分摊到多台服务器上的技术)解决 502 频发的问题:与其反复重启救火,不如在前面加一层 Nginx upstream 分流,用两台普通配置的机器共同承担流量,任何一台故障时请求自动切走。下文覆盖分流、容错和健康检查三个环节的配置,每个步骤都给出可以直接复制的配置。看完这篇,你可以把一套单机服务平稳扩展成双机架构,让 502 从”常态”变回”异常”。
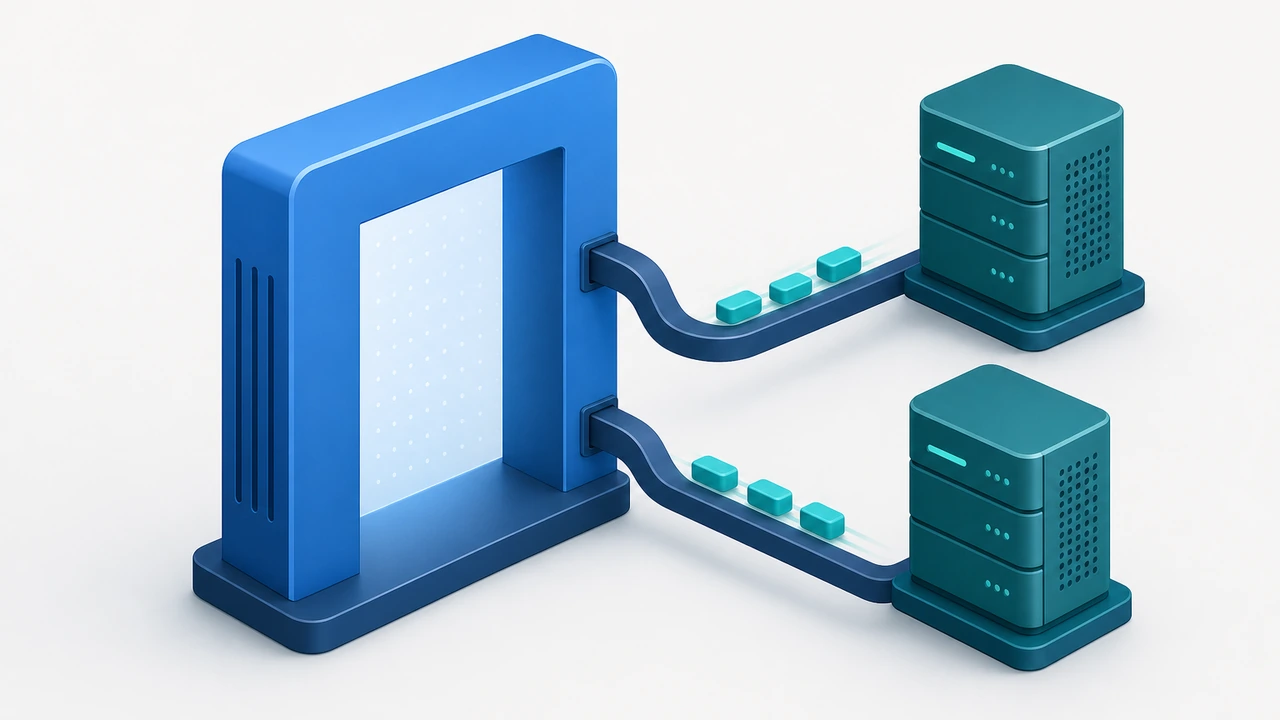
upstream 基础:最小可用的负载均衡配置
upstream 是 Nginx 定义后端服务器组的配置段,所有负载均衡行为都从它开始。假设你有两台后端机 192.168.1.10 和 192.168.1.11,都监听 8080 端口提供同样的 Web 服务,在 Nginx 配置中写入:
upstream backend {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://backend;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
保存后执行 nginx -t 检查语法,再 nginx -s reload 平滑生效。默认策略是轮询(round-robin,按顺序逐个分发),请求会一比一交替到达两台后端。验证方法很简单:在两台后端分别返回不同的标记页(比如各自的机器名),然后用 curl http://example.com 连续请求几次,看到返回内容交替变化就说明分发已经生效。
两个容易忽略的细节:一是 proxy_set_header Host $host 必须加上,否则后端收到的 Host 头是 upstream 名字,虚拟主机配置会全部失灵;二是 X-Real-IP 传递真实客户端 IP,缺少它后端日志里全是负载均衡机的内网地址,排查问题时无从下手。
加权与容错:让分发策略匹配机器差异
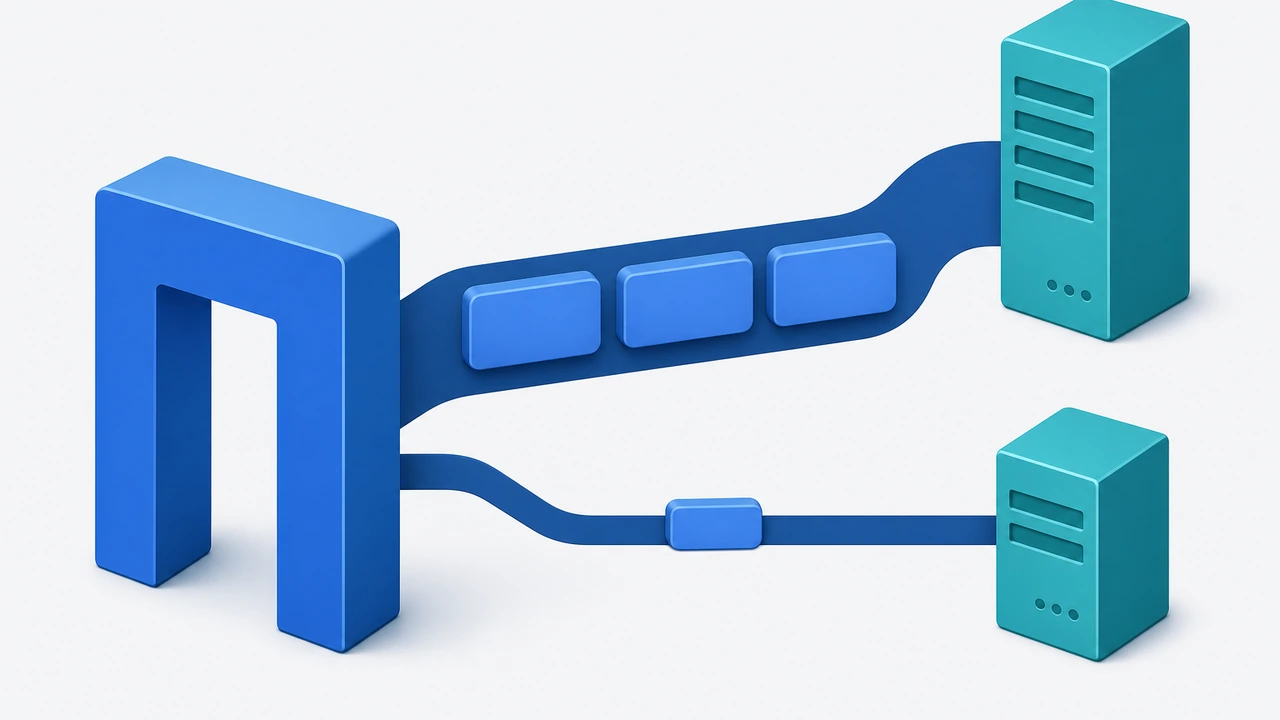
两台机器配置不同时,轮询就不合适了。假设一台 8 核、一台 4 核,处理能力大约是 2:1,用 weight 参数调整权重:
upstream backend {
    server 192.168.1.10:8080 weight=2;
    server 192.168.1.11:8080 weight=1;
}
这样每 3 个请求约有 2 个落到强机上。除了权重,还有两个应对后端故障的关键参数:max_fails 允许的失败次数、fail_timeout 判定失败的观察窗口,例如 server 192.168.1.11:8080 max_fails=2 fail_timeout=10s; 表示 10 秒内失败 2 次就把该节点暂时踢出分发,10 秒后再放请求试探恢复情况。
故障转移必须实际演练过才算数。一个常见的验证方法:直接停掉其中一台后端(systemctl stop nginx),然后循环请求入口地址。如果所有请求仍然 200 返回,说明失败转移生效;如果出现部分 502(后端不可达错误),通常是超时参数太紧,在 location 里补上 proxy_next_upstream error timeout; 和 proxy_connect_timeout 3s;,让 Nginx 在连接失败时自动把请求转投另一台后端。会话保持场景(用户登录状态存在单机内存里)需要额外加 ip_hash 指令,让同一 IP 固定访问同一后端,但这也会破坏负载的均匀性,更彻底的方案是把会话外置到 Redis 等共享存储,相关实践可以参考Redis 持久化与恢复实践。
健康检查:用备份节点兜住单点故障
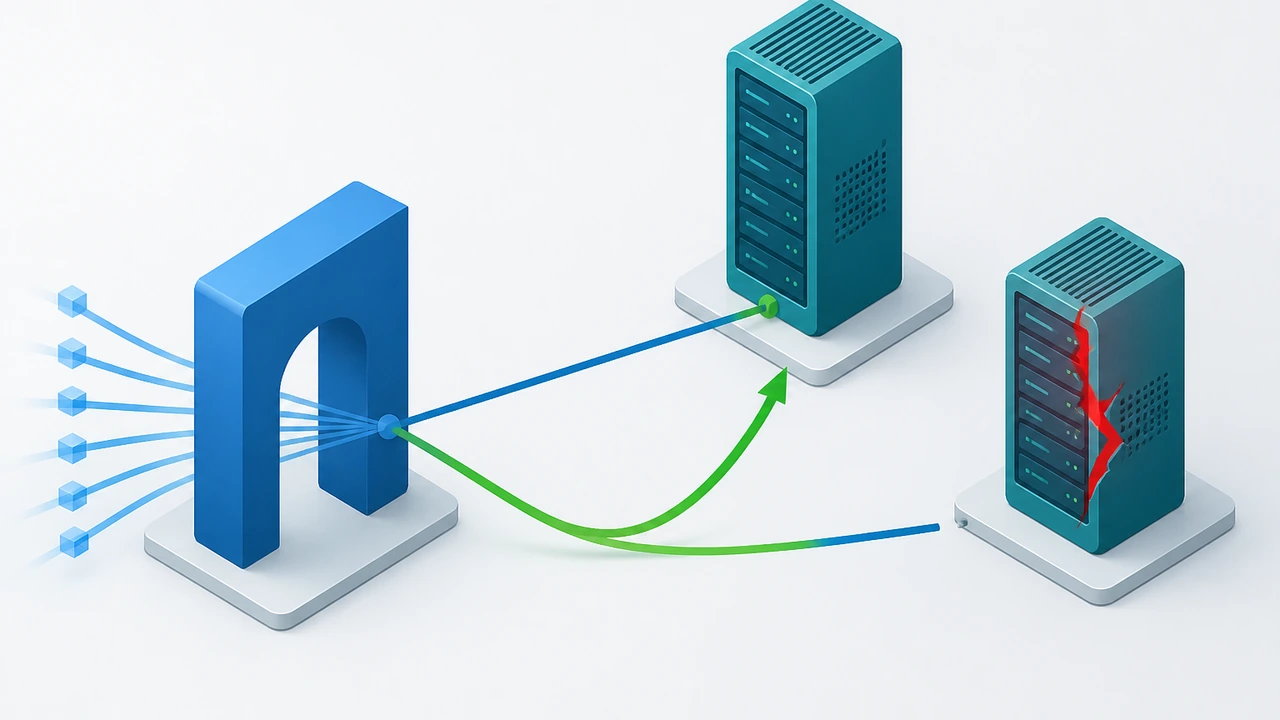
开源版 Nginx 没有内置主动健康检查(定期探测后端可用性的机制),但被动失败转移加上一个 backup 节点,就能组成实用性很高的兜底方案。所谓 backup 节点,是平时不接流量、只在所有正常节点都失败时才顶上的备用机:
upstream backend {
    server 192.168.1.10:8080 max_fails=2 fail_timeout=10s;
    server 192.168.1.11:8080 max_fails=2 fail_timeout=10s;
    server 192.168.1.12:8080 backup;
}
这个结构的价值在于把”两台同时挂”的概率压到极低。日常流量在 10 和 11 之间轮询,任何一台故障先被踢出、另一台接管;万一两台都挂,12 号机自动上线,保证至少返回一个友好的降级页面。对业务连续性要求更高的场景,可以把 backup 节点放在不同的可用区甚至不同的机房,进一步隔离物理风险。
判断后端是否真正”健康”,不能只看端口通不通。更贴近业务的探测方式是在每台后端上放一个专用的 /healthz 检查页,内容连接数据库执行一次简单查询后返回状态——数据库挂了即使 Nginx 进程还活着,检查页也会报错,负载均衡机就能感知到并停止分发。这套思路配合外部监控效果更好,把探测告警接入 Grafana 等面板的部署方法,可以参考Grafana 服务器监控部署实践。
部署环境与落地建议
负载均衡机本身的选型要求不高——它只做转发不做计算,1-2 核的小机型就够用,但必须保证网络质量稳定,因为所有进出流量都经过它。负载均衡机与后端机放在同一内网(私网互联)时转发延迟几乎可以忽略,跨机房则要评估线路开销。如果你在规划这样一套多机架构,VPS(虚拟专用服务器)方案支持按台数灵活扩展,适合作为后端节点起步;流量继续增长后再升级独立服务器承担核心业务,负载架构不需要推倒重来。Hostease 的服务器方案支持私网互联,多机组网时内网转发延迟更低。
部署完成后的日常维护有三条纪律:每次改 upstream 配置前先 nginx -t 验证,改完立即 nginx -s reload,避免重启造成瞬断;每月做一次手动故障演练,随机停一台后端确认流量平滑切换;给 upstream 里每台机器打上清晰的注释标记,机器多了以后配置可读性就是排障速度。
总结来说,用 upstream 解决 502 的路径就是三层递进:先用两行配置跑通分流把单机压力摊开,再用 weight 与 max_fails 让故障节点自动退出,最后用 backup 节点和业务级检查页兜住极端情况。建议你现在就在一台测试机上把最小配置跑起来,停掉一台后端亲眼看到流量自动切换——这个十分钟的演练,会让你对架构可用性建立真正的手感。如果后续需要引入主动健康检查或多机房容灾,再基于这套基础逐步演进即可。