一、小内存 [VPS](https://cn.hostease.com/vps/) 上的 Redis,为什么数据会丢
很多网站把会话、缓存甚至核心业务数据放进 Redis(一款开源的键值存储数据库)。它快,是因为数据主要存在内存里;但内存(临时存储)一断电就清空,如果没做持久化,重启后数据就没了。对小内存 VPS(虚拟专用服务器,即在一台物理机上用虚拟化技术划分出的独立服务器环境)来说,既要保住数据,又怕持久化拖垮本来就不宽裕的内存和磁盘 IO,这就成了取舍问题。这篇文章教你分清楚 RDB 与 AOF 各自的开销与丢失窗口,再给出两组可以直接落地的配置,让你能用很小的资源代价把数据安全稳稳做好。
二、RDB 与 AOF 到底差在哪里
Redis 持久化主要有两种方式,理解它们的差别是选择的前提。
RDB:把某一时刻的内存快照写盘
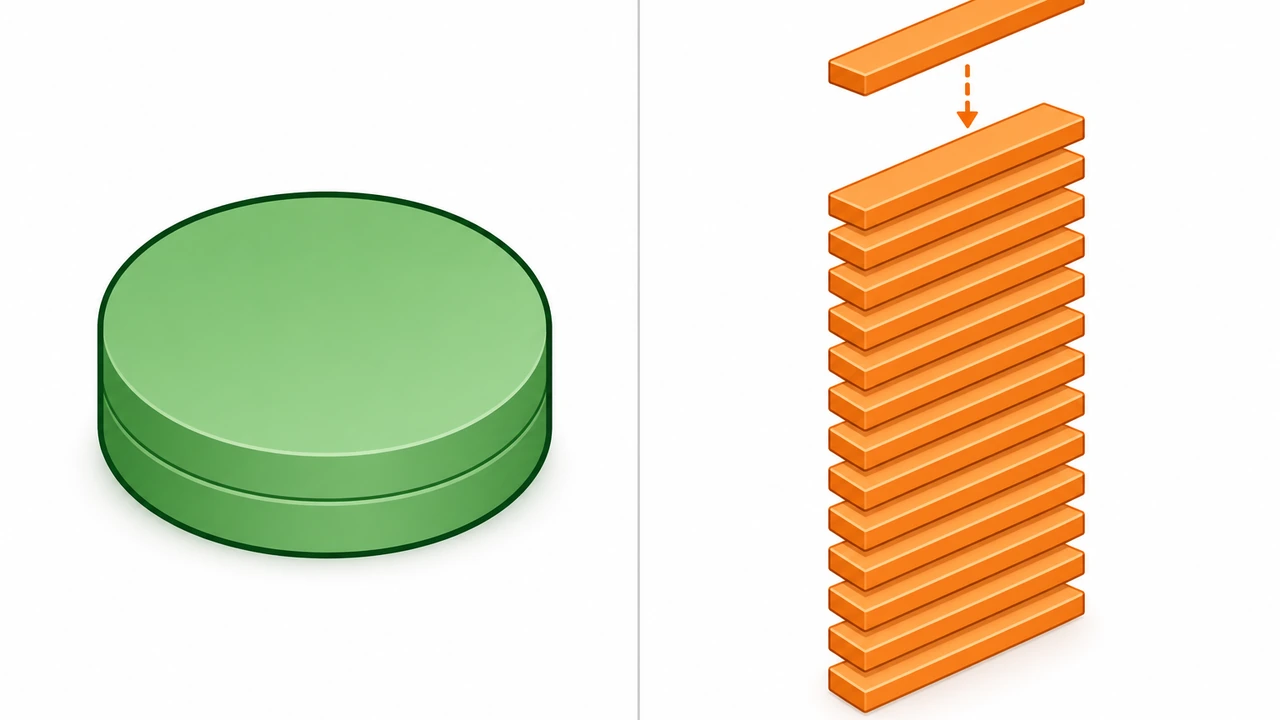
RDB 的做法是周期性把内存里的全部数据生成一份快照(snapshot)写入磁盘。优点是恢复快、文件紧凑,适合做备份;缺点是两次快照之间若发生宕机,中间的数据会丢,且生成快照时如果内存紧张,可能临时占用系统内存甚至触发内存交换,拖慢正在进行的读写。
AOF:把每次写命令追加到日志
AOF 的做法是把每一条会改变数据的写命令追加到日志文件,重启时重放这些命令来恢复数据。只要日志还在,丢失数据的窗口通常很小,最坏也不过是最后一条写入命令到最近一次落盘之间的一两秒。代价是日志文件增长快、重启恢复比 RDB 慢,写命令频繁时对磁盘 IO 压力明显更大。
下面这张图可以帮助你快速理解两者的区别:
三、小内存 VPS 推荐的取舍判断
内存和 IO 都紧张时,不建议一上来就同时开 AOF 和 RDB。先问自己两个问题:这个 Redis 里的数据丢了之后要花多久补回来?业务能接受多久的丢失窗口?
如果 Redis 只放可重建的缓存(例如商品页、用户会话),丢失窗口几秒钟到几分钟可以接受,那么 RDB 就够用,配置简单、恢复最快,也几乎不占磁盘空间。如果存的是订单、计数器、支付防重这类绝不能丢的数据,就需要 AOF,并把写回策略设为最保守的 everysec(每秒写一次),即使这样在极端情况下最多也只丢 1 秒数据。
一个务实的做法是 AOF 为主、同时保留 RDB 备份文件,作为定期手工备份的来源。这样既能靠 AOF 缩小丢失窗口,又能靠 RDB 快速做异地备份。前提是你的磁盘空间和 IO 都能扛得住 AOF 日志的增长——小内存 VPS 上业务量通常不大,日志增长速度一般可控,多数场景压力并不大。
四、关键配置与验证命令
下面以 redis.conf 为例,给出两组可以直接落地的小内存 VPS 配置。两类配置都建议先记下当前值,再逐项修改,避免一次性改动太多导致排错困难。
仅缓存场景:RDB 为主
在 redis.conf 里打开并调整如下参数:
save 900 1
save 300 10
save 60 10000
stop-writes-on-bgsave-error yes
rdbcompression yes
含义是:900 秒内至少有 1 次写就生成快照、300 秒内 10 次写、60 秒内 10000 次写,达到任一条件就触发一次快照。stop-writes-on-bgsave-error yes 保证快照写盘失败时停止写入并提醒你排查,避免数据在无人察觉的情况下悄悄丢失。对小内存机型,这个配置几乎不额外占用磁盘,是性价比最高的起点。
核心数据场景:AOF 为主
appendonly yes
appendfilename "appendonly.aof"
appendfsync everysec
auto-aof-rewrite-percentage 100
auto-aof-rewrite-min-size 64mb
appendfsync everysec 让系统每秒把缓冲里的日志刷到磁盘,在性能与安全之间取一个平衡点。auto-aof-rewrite 系列参数会在日志涨到一定规模后自动重写瘦身,防止文件无限增长占满小容量磁盘。这两个参数组合起来,即使长期运行,AOF 文件也不会失控。
配置文件改完后重启 Redis,用下面命令验证持久化是否真正生效:
redis-cli config get save
redis-cli config get appendonly
redis-cli info persistence
info persistence 输出里的 rdb_last_bgsave_status 和 aof_last_write_status 都应为 ok,说明快照与日志两条链路都正常,后续巡检也只需盯住这两个字段。
五、怎么量化内存与 IO 的压力
小内存 VPS 上最怕的不是功能没配好,而是持久化把资源悄悄占满。建议用一条命令定期看 Redis 自身的统计:
redis-cli info memory | grep used_memory_human
redis-cli info stats | grep -E "rdb_bgsaves|aof_rewrites"
used_memory_human 反映内存占用,如果明显接近你 VPS 的物理内存上限,就要警惕内存交换;rdb_bgsaves 和 aof_rewrites 累计次数能看出快照和日志重写触发的频率。如果一天之内这两个数频繁跳动,说明写入量大,应下调 save 触发门槛或把 AOF 重写门槛调高,让磁盘操作更平缓。另外用 iostat 1 5 看 %util,如果持续接近 100%,说明磁盘已是瓶颈,需要减少持久化频率或换更高 IO 规格的磁盘。
六、常见避坑清单
实战里以下问题最容易让“做了持久化”变成“数据照样丢”:
- 只开 RDB 却把 save 频率设得很低,例如 save 3600 1,导致一小时才备份一次,崩一次就丢一小时数据。
- 开了 AOF 却忘了显式设置
appendfsync,默认策略在极端断电时可能丢更多数据,务必写成 everysec。 - 磁盘写满后快照或日志会静默失败,日常巡检必须盯
info persistence的状态字段,而不是只看服务进程有没有正常启动。 - 把 RDB 当作唯一备份却不做异地复制,本地磁盘坏掉时快照和源数据一起消失,应当按 3-2-1 思路把快照定期同步到别处。
七、总结与下一步
对小内存 VPS 上的 Redis,持久化策略没有“绝对正确”,只有适不适合业务丢数据容忍度。建议先跑通上面两组配置之一,用 redis-cli info persistence 验证写入状态,再根据日志增长速度按月复查 AOF 重写频率。如果你需要更完整的数据安全兜底,可以配合定期异地备份与监控告警一起落地,具体可参考 Cloud Server 3-2-1 备份策略、备份与恢复:应对勒索风险 以及 云服务器上线前检查清单。云服务器(即常见的云主机,按需提供计算、内存与存储的远程通用计算资源)若你的业务数据量不大、只想快速把稳定可控的 VPS 环境跑起来,也可以了解一下 Hostease VPS 主机 的方案再对比选择。总结下来,建议你从最小改动起步:先只调 save 或 appendonly 参数并重启验证,确认 info persistence 全绿后再逐步加策略,不建议一次性把内存、IO 和备份全部改到位。