如果你有五六个微服务跑在生产环境,最近大概遇到过这类事情:服务 A 调服务 B 突然超时,查了半小时才发现是重试风暴;想给所有服务加上 mTLS 加密,却发现要改十几个代码仓库;灰度发布只能靠改 Nginx 配置, roll 回来手忙脚乱。这些问题的共同根源是:服务之间的通信逻辑散落在每一份业务代码里。Service Mesh(服务网格,一种把服务间通信下沉到独立基础设施层的技术)就是为了解决它而生的。本文帮助你搞清楚三个问题:什么阶段才真正需要服务网格、Istio 和 Linkerd 在中小团队的实际成本差多少、以及如何用最小的代价落地第一版。
Service Mesh 到底解决什么问题
先看没有 Mesh 时的典型场景。一家做 SaaS 的团队有 8 个微服务,部署在几台云服务器(由云服务商提供的弹性托管服务器)上,服务间用 HTTP 互相调用。上线第一年相安无事,第二年出了三件事:一是某个服务偶发超时,排查发现是上游没做重试上限,一次抖动放大成雪崩;二是安全合规要求所有内网流量加密,团队得逐个服务改配置、换类库、发版本,前后花了三周;三是想统计”订单服务调用支付服务的成功率”,发现每个服务埋点格式不一样,数据根本拼不起来。
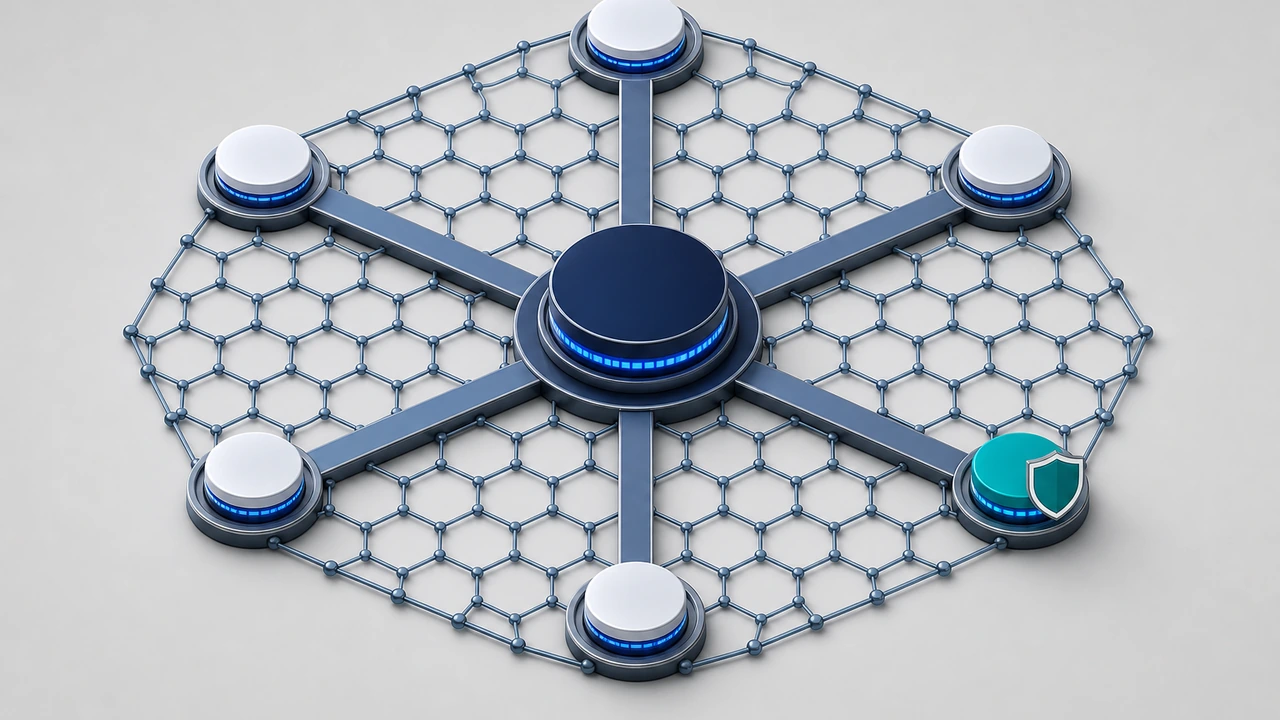
这三件事对应的就是 Mesh 承接的三类能力:流量治理(重试、超时、熔断)、安全(mTLS 双向加密、身份认证)、可观测(调用链、指标统计)。Mesh 的做法是给每个服务旁边挂一个代理(叫 sidecar,随服务一起部署的边车进程),所有进出流量都经过它,治理逻辑统一在控制面配置,业务代码一行不用改。
听起来很美好,但代价必须先讲清楚。Mesh 不是免费午餐:每个服务多一个 sidecar 进程,内存和 CPU 直接涨一截;请求多两跳代理,单次调用增加 1-3ms 延迟;控制面本身还要占 2-4 个常驻组件的资源。对两三个服务的团队来说,这些成本换不回对应收益;对十几个服务、调用关系开始像蜘蛛网的团队,它才开始划算。
判断你家需不需要 Mesh 的三个信号
与其背概念,不如对照下面三个信号自查,命中越多越值得上:
- 调用关系数超过服务数:5 个服务但有 10 条以上调用链路,手工管理重试和超时配置已经开始出错——某次改配置漏了一个服务,故障就从那里冒出来
- 安全合规要求加密:金融、医疗类客户要求传输层加密,逐服务改造的成本已经超过引入 Mesh 的一次性成本
- 排查一次跨服务故障超过 2 小时:没有统一调用链,日志散落在各服务里靠时间戳对齐,工程师的深夜就是这么熬掉的
如果三条一条都不占,先把精力放在服务拆分合理性和基础监控上,Mesh 可以等等。关于监控这块,可以参考我们整理的服务器监控实战教程,先把单机和服务级的指标盯住,再谈网格。
Istio 与 Linkerd:中小团队视角的真实差异
两个主流方案的目标一致,但设计哲学差别很大,直接决定中小团队的运维体验。先看一组公开数据:Istio 1.24 官方基线测试显示,其控制面(istiod)空载内存约 1.2GB,每个 sidecar 代理追加约 50-70MB 内存;Linkerd 2.x 的控制面五个组件合计约 300MB 出头,每个 sidecar 约 30-40MB。单看数字差距不大,乘上服务数量后,10 个服务的集群里两者仅 sidecar 内存就差出 300MB 以上,还不算控制面接近 1GB 的差距。
资源只是表象,运维复杂度才是中小团队真正要权衡的:
| 维度 | Istio | Linkerd |
|---|---|---|
| 安装与初始配置 | 组件多,配置项几十个,建议先跑官方 profile | 一条命令装完,默认配置即安全基线 |
| 功能范围 | 流量治理、策略、遥测全都有,还能接多种扩展 | 聚焦核心:mTLS、重试、金丝雀发布,功能面窄但稳 |
| 学习曲线 | 团队需要专人啃文档,社区资料多但良莠不齐 | 上手快,文档短,遇到问题排查路径简单 |
| 底层实现 | 基于 Envoy 代理,功能强、配置面大 | 自研轻量代理(Rust),资源占用低 |
| 适合谁 | 已有平台团队、未来要走多云多集群的中型组织 | 没有专职运维、想快速拿到 mTLS 和重试的团队 |
一句话概括:Istio 是功能全家桶,Linkerd 是”够用就好”。中小团队最容易踩的坑是按大厂架构图选型——人家上 Istio 是因为有平台组养着,你的团队一个人兼前后端还兼运维,装了全家桶最后只会用到其中两成功能,却要承担全部升级和维护成本。如果你们的业务部署还在虚机或单机多进程阶段、连 Kubernetes(容器编排平台,负责管理大量容器的调度与运行)都还没上,那两个方案都先不用考虑,Mesh 依赖 K8s 环境;这时候更实际的是先把服务容器化,选一台配置够用的 VPS(虚拟专用服务器,把一台物理服务器划分成多个相互隔离的虚拟主机)把 K8s 单集群跑起来,VPS 主机的入门配置就足以承载试验环境。
落地路径:从单服务试点到全量铺开
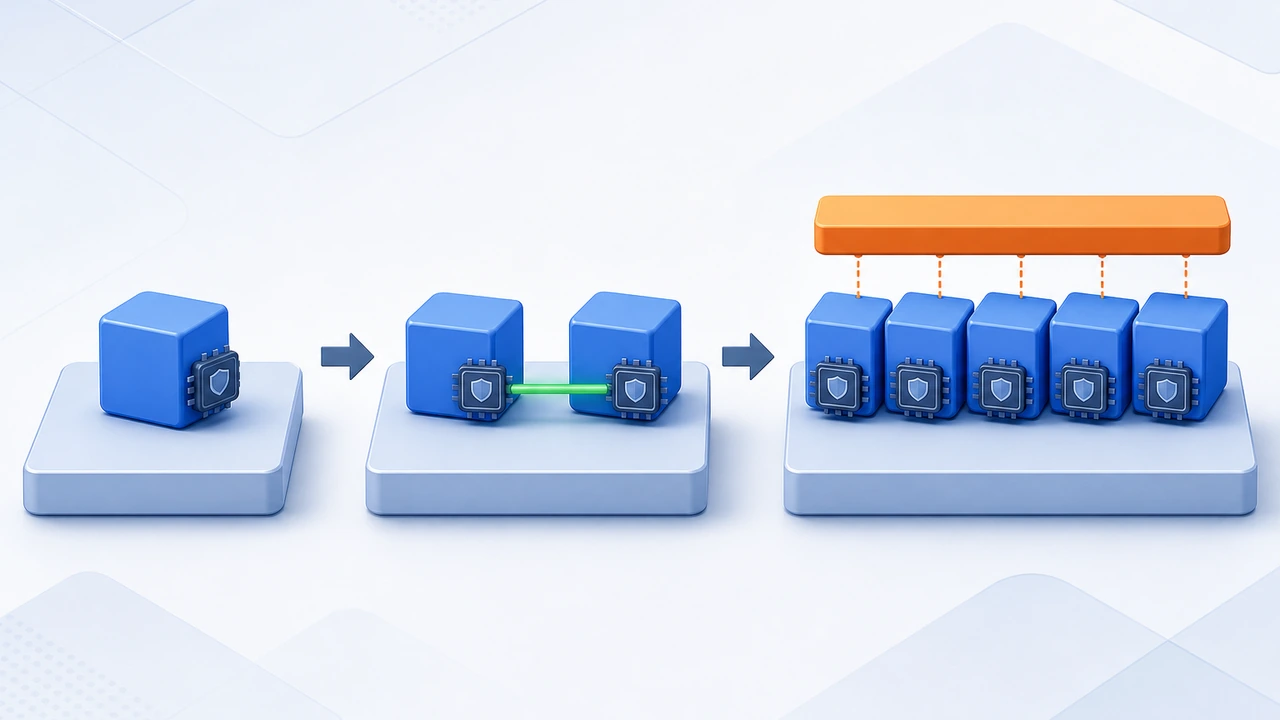
选定方案后,不建议一步到位全量接入。我们在实践中验证过的稳妥路径是三步走,每步都有明确的回退点:
第一步,选一个边缘服务试点。 挑一个调用关系简单、出问题影响小的服务(比如通知推送服务,而不是订单核心),把 sidecar 挂上去,观察两周。验收标准很具体:注入 sidecar 后该服务 P99 延迟增量不超过 5ms,内存增量符合上文预期,否则先停下来查环境。
第二步,开启 mTLS 并验证兼容性。 试点稳定后打开双向加密,重点验证有没有老客户端不兼容。这一步常被忽略的问题是协议假设:某些老旧的内网调用库对 TLS 握手超时设置过短,加密后会偶发失败。稳妥做法是先设成 permissive 模式(加密可选),观察一周无异常再切成 strict 强制加密。
第三步,逐步接入流量治理。 最后才上重试、超时、金丝雀这些策略,而且一个服务只加一类策略,加了就观察。一次全量铺开后出了问题,你分不清是 Mesh 配置的锅还是业务代码的锅。
整个过程中,Mesh 控制面和监控数据的存储会持续吃资源,尤其是调用链数据。中小团队建议把 Mesh 的可观测数据保留期调短(比如调用链保留 3 天),控制面资源请求值按实测的一半设置,避免为用不到的精度付费。关于服务器资源配置怎么选,可以看这篇服务器配置选购指南,把底座资源规划好,Mesh 才不会成为压垮服务的最后一根稻草。
总结与下一步行动
回顾一下决策链:先看三个信号判断需不需要 Mesh——调用关系复杂度、加密合规要求、故障排查耗时;需要的话,中小团队默认从 Linkerd 起步,除非你已经确定要走多云多集群路线或有专职平台团队,再选 Istio;落地时坚持”单服务试点 → mTLS 验证 → 流量治理”三步走,每步留回退点。
如果你需要一台稳定的服务器来搭建试验用的 Kubernetes 环境,可以考虑 Hostease 的VPS 主机方案,先在低成本的节点上完成 Mesh 试点,验证收益后再扩大规模。最后提醒一句:Mesh 解决的是服务间通信的复杂度,如果服务本身边界划得一团糟,上了 Mesh 也只是把混乱管理起来,而不是消灭它——先把服务拆对,再谈网格。