监控接入之后,很多团队的第一个感受不是安心,而是被告警淹没:一天两百多条通知,真正需要动手处理的不超过五条,剩下的全是连锁反应和重复提醒。这篇文章要解决的就是”告警比故障更吵”的问题——如何用 Alertmanager(告警路由与通知组件)的三个核心机制:分级路由、抑制规则和静默窗口,把噪声砍掉九成,只让真正需要人处理的告警到达对的人。为什么值得专门写一篇?因为告警系统的价值不在于”发出去了多少条”,而在于”每一条都值得看”。这段链路可以直接跑在一台 VPS(虚拟专用服务器)主机上练手,已有环境的话按本文改造即可,不需要推翻重来。
场景:告警风暴是怎么把人练麻木的
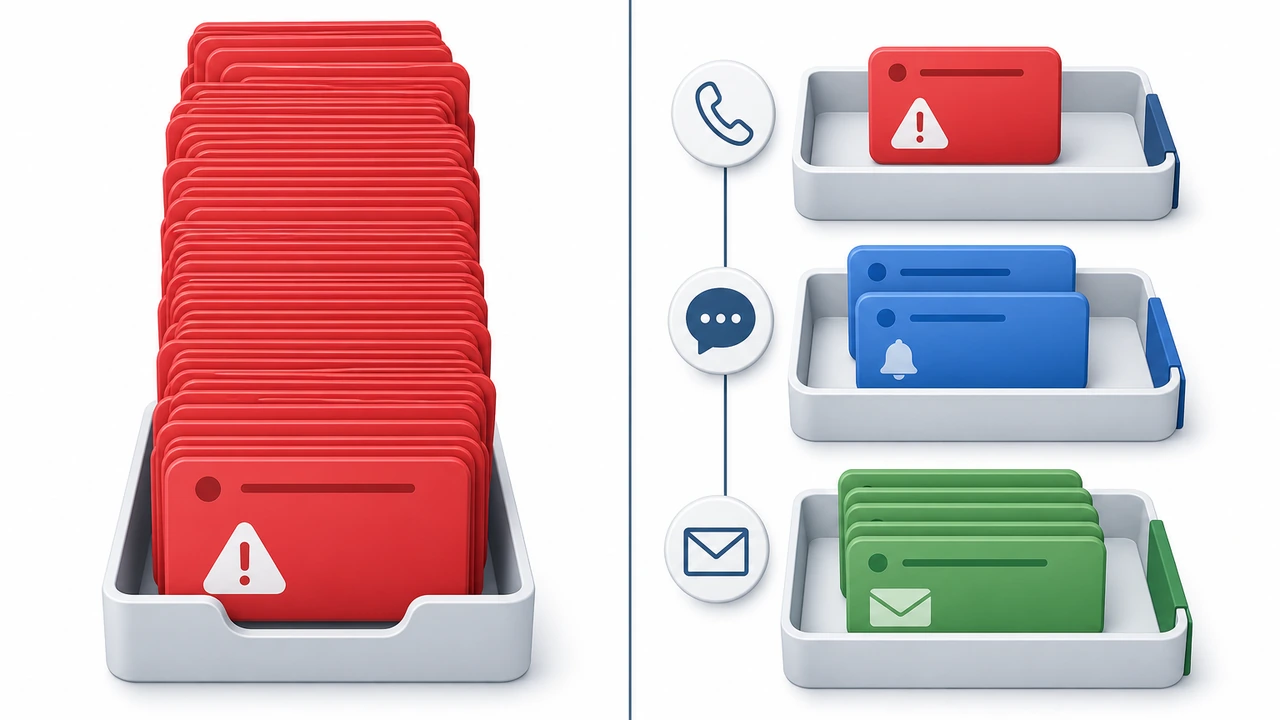
先还原一个真实过程:某台数据库主机的磁盘写满,触发一条 critical 告警;紧接着它上面的应用进程报错,又来十几条;负载均衡把流量切到备机,备机 CPU 跟着飙高,再十几条。十分钟后,值班群里有四十多条消息,其中三十九条是同一次故障的”回声”。更糟的是第二天再来一次,值班同学已经开始习惯性忽略红点——真正的故障就藏在这种麻木里。
这类问题的根因不是指标采得不对,而是所有告警都在走同一条通知通道、同一批人、同一个音量。解决思路是给告警系统装上”分拣和过滤”三层机制:路由决定”谁收到”,抑制决定”哪些不值得单独发”,静默决定”哪些时段不要发”。下面逐层展开,每一层都给出可直接复用的配置。
分级路由:让 warning 进群、critical 打电话
Alertmanager 的路由是一棵从 route 根节点开始的树:告警进来后从根往下匹配,命中最深的子路由就用那个子路由的接收器。默认路由是兜底,必须存在;子路由按 matchers 里的标签匹配——这正是我们在告警规则里写 severity 标签的意义,它就是路由的分流依据。
一个生产可用的分级结构长这样:
route:
  receiver: "ops-digest"
  group_by: ["alertname", "instance"]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - matchers: [ 'severity="critical"' ]
      receiver: "oncall-phone"
      repeat_interval: 30m
    - matchers: [ 'severity="warning"' ]
      receiver: "team-chat"
      repeat_interval: 12h

receivers:
  - name: "ops-digest"
    email_configs:
      - to: "ops@example.com"
  - name: "oncall-phone"
    webhook_configs:
      - url: "https://your-call-gateway/alert"
  - name: "team-chat"
    webhook_configs:
      - url: "https://your-chat-webhook/alert"
三个参数决定了降噪效果的一半:group_by 把同实例同名告警合并成一条通知;group_wait: 30s 等三十秒再发,让同一波连锁告警挤进同一条消息;repeat_interval 控制”没人处理时多久重发一次”——critical 半小时重发是合理的,warning 十二小时重发一次就足够,默认值不改的话,一条没人认领的 warning 能把群刷一整天。
分级之后还要守住一条纪律:critical 的准入标准必须苛刻。经验阈值是”需要人在 15 分钟内动手的才配 critical”,比如磁盘超 95%、主服务进程消失;”下班前处理就行”的问题一律 warning。critical 一旦泛滥,打电话这条通道就废了——这是很多团队路由配完三个月后重新退回噪音状态的头号原因。
抑制规则:连锁故障只报根因
分级路由解决了”发给谁”,抑制规则解决”发不发”。它的逻辑很直白:当某一类告警正在发生时,把由它引发的另一类告警压掉。配置在 inhibit_rules 段,source_matchers 是根因,target_matchers 是被压的连锁告警,两者必须 equal 里列出的标签完全相同才生效。
最常用的三条:
inhibit_rules:
  # 实例失联时,压掉这台实例上的一切其他告警
  - source_matchers: [ 'alertname="InstanceDown"' ]
    target_matchers: [ 'severity=~"warning|critical"' ]
    equal: ["instance"]

  # 节点宕机时,压掉该节点上所有 Pod 级告警
  - source_matchers: [ 'alertname="NodeDown"' ]
    target_matchers: [ 'severity=~"warning|critical"' ]
    equal: ["node"]

  # 磁盘满(critical)压掉磁盘将满(warning)
  - source_matchers: [ 'alertname="DiskFull"' ]
    target_matchers: [ 'alertname="DiskWillFillSoon"' ]
    equal: ["instance", "device"]
第一条的收益最明显:机器失联时,它上面挂的十几个采集项会同时消失,Prometheus 的 up 指标变化加上各业务指标超时,可能瞬间产生二十条告警;有了这条抑制,值班手机只会收到一条 InstanceDown。第三条则处理”预警和告警同时触发”的重复——机器真的满了,”将满”的预警已无意义。
写抑制规则有一个必须验证的细节:equal 标签必须两边都存在且值相同。如果根因告警的标签里没有 instance,而连锁告警有,抑制不会生效也不会报错,只会安静地失效。验证方法是制造一次可控的根因(比如临时停掉某台测试机的 node_exporter),观察是否只收到一条通知。
静默窗口:给计划内维护留出安静时段
抑制处理的是”告警之间的依赖”,静默处理的是”人和告警之间约定”。凌晨三点要做内核升级,升级期间 CPU、内存、进程类告警全部会触发——这些告警都是对的,但此刻不需要发给任何人。Alertmanager 的静默(Silence)就是为此设计的临时屏蔽机制,通过 Web UI 或 API 创建:
# 静默 web-01 上所有告警 2 小时
curl -X POST http://localhost:9093/api/v2/silences -H 'Content-Type: application/json' -d '{
  "matchers": [ { "name": "instance", "value": "web-01:9100", "isRegex": false } ],
  "startsAt": "2026-10-18T02:00:00+08:00",
  "endsAt":   "2026-10-18T04:00:00+08:00",
  "createdBy": "ops",
  "comment": "内核升级维护窗口"
}'
生产环境的静默纪律比配置本身更重要。我们建议的做法是三条:每条静默必须写清 comment(谁、为什么、到何时),禁止”先静默一周再说”;结束时间精确到维护窗口,宁可延长也不要一开始就拉长——静默期的故障是真发的,只是没人听见;每周清点一次过期静默,长期不清理的静默列表会变成第二套失控的黑名单。
效果验收:用数据确认降噪有效
改造完成后,降噪效果要用数字说话,而不是凭感觉。最直接的口径是对比一周内的通知量:路由与抑制生效后,日通知条数应从数百条降到十几条以内,其中 critical 占比应该低于一成——比例过高说明 critical 准入没守住,比例过低(长期为零)则说明阈值可能放得太松。
两个可以固定下来的健康检查习惯:每月用 amtool 查看路由命中分布,确认没有告警意外落进兜底接收器——落到 ops-digest 兜底邮箱的告警越多,说明 matchers 与规则文件里的标签越对不上;每季度把触发过却没引发任何动作的规则直接删掉,触发但从不行动的告警本身就是噪声的另一种形态。磁盘告警改造后通常是最先受益的场景,验证时可以临时往测试机写入一个大文件,确认只有 DiskFull 一条通知到达。
总结与行动建议
回头看,这套降噪体系只做了三件事:路由把不同严重度的告警分给不同通道,抑制把连锁故障压成一条根因通知,静默给计划内维护留出安静时段。配合 group_wait 合并和 repeat_interval 重发控制,普通团队一天的通知量可以从上百条降到十几条,而漏报风险不升反降——因为每条告警重新变得值得看了。
如果你正在从零搭建这套环境,建议先读一下站内这篇 node_exporter 与 Prometheus 服务器监控实战,把抓取链路和基础告警规则跑通,再回来套用本文的路由与抑制配置;告警治理更偏日常运维,服务器配置 分类下的其他文章覆盖了磁盘、负载等常见阈值的调优思路。托管环境里,Hostease 的 VPS(虚拟专用服务器)主机和 独立服务器 都提供完整的系统权限,可以直接部署 Prometheus 与 Alertmanager,并把告警通知对接到你自己的值班通道。落地节奏建议是:先上分级路由(半天可见效),一周后再加抑制规则(需要先积累一段真实告警标签数据),静默流程随第一次计划维护同步建立——不要试图一天配齐,每层机制都需要用真实告警来校准。