服务器运行得越久,沉淀的数据就越多:网站文件、配置脚本、SSL(安全传输协议)证书、数据库导出文件……一旦磁盘损坏或操作失误,这些数据可能在几秒内消失。本文将讲解如何用开源工具 restic 搭建 restic 备份方案,把服务器数据加密后上传到对象存储,帮助你用较低成本构建可自动化、可验证的备份体系,覆盖选型、初始化、自动化与恢复演练,照着做即可落地。
restic 是什么:为什么它适合服务器备份
restic 是一款开源的命令行备份工具,用 Go 语言编写、编译为单个二进制文件,安装后不依赖复杂的运行环境,特别适合在 Linux 服务器上执行定期备份任务。
它有三个关键特性直接决定备份质量。第一是客户端加密:数据在你自己的服务器上完成 AES-256 加密后才上传,对象存储服务商无法读取内容;即使 Access Key 意外泄露,攻击者拿不到仓库密码也解不开数据。第二是去重与增量:restic 按数据块(而不是整个文件)切分并做哈希比对,第二次备份只上传变化的部分。比如一个 10 GB 的网站目录只改动了 50 MB,实际传输量就接近 50 MB,对流量和存储成本都友好。第三是快照管理:每次备份生成一个可独立浏览的快照,配合保留策略自动清理历史版本,不必手动维护日期文件夹。
为什么推荐对象存储作为备份目的地?相比再租一整台服务器做异地备份,S3 兼容对象存储按容量计费、无需维护操作系统,还天然具备异地容灾能力。对预算有限的中小站点,这套组合的月成本通常可以控制在几美元级别(价格截至 2026 年 9 月,以各厂商官网实时报价为准),而可靠性远高于把备份压缩包放在同一块磁盘上。如果你还在为对象存储选型和备份清单发愁,可以参考我们之前整理的对象存储备份核对清单一文。
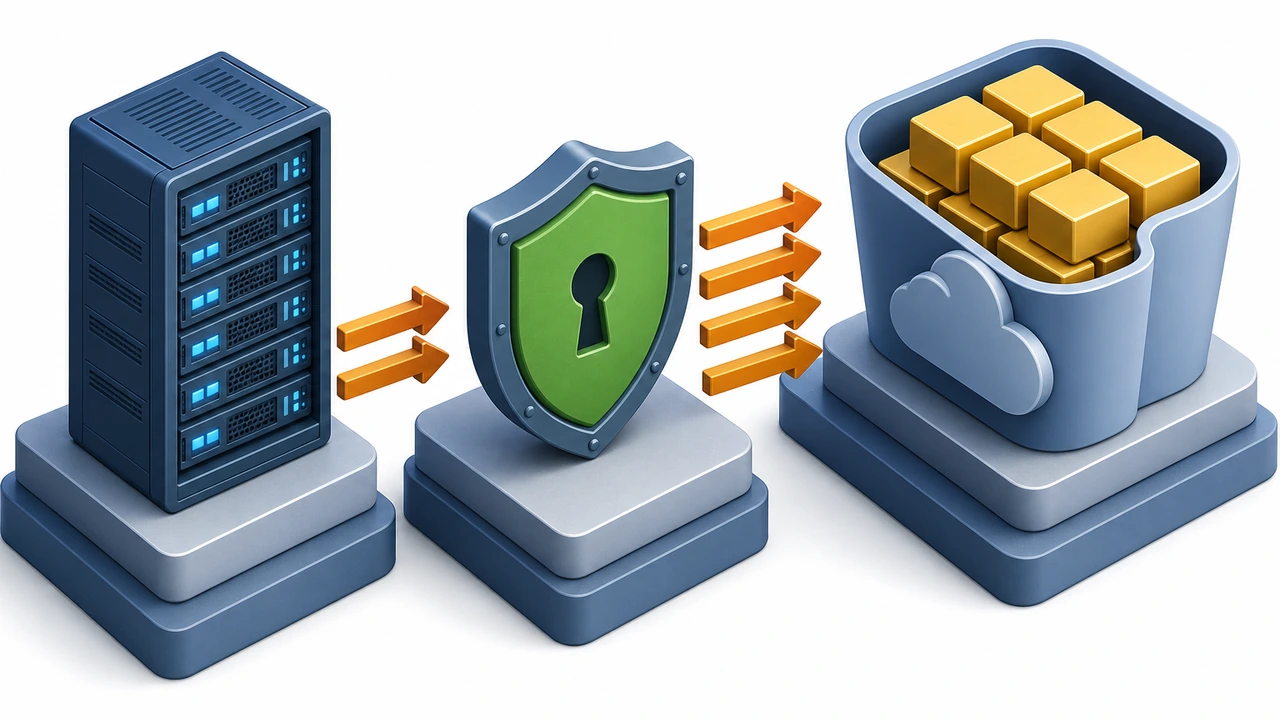
环境准备:安装 restic 与对象存储仓库
在开始 restic 备份之前,需要准备两样东西:一台可以运行定时任务的服务器,以及一个 S3 兼容对象存储的 Bucket(存储桶)和对应的 Access Key / Secret Key。主流云厂商的对象存储产品大多兼容 S3 协议,任选一家即可,下文用 s3.example.com 代指服务端点。
安装 restic 非常简单。以 Debian / Ubuntu 为例:
apt update && apt install -y restic
restic version
如果发行版仓库里的版本较旧,可以从 restic 官方 GitHub Releases 下载对应平台的二进制文件,放到 /usr/local/bin/ 并赋予执行权限。写作本文时 restic 稳定版为 0.17.x,建议使用 0.16 以上版本以获得更完善的对象存储支持。
接下来初始化加密仓库。先把连接信息和仓库密码写入环境变量,避免明文散落在命令历史里:
export AWS_ACCESS_KEY_ID="你的AccessKey"
export AWS_SECRET_ACCESS_KEY="你的SecretKey"
export RESTIC_REPOSITORY="s3:https://s3.example.com/my-backup-bucket"
export RESTIC_PASSWORD="一个足够长的仓库密码"
restic init
restic init 会在 Bucket 中创建仓库结构,并输出一串 repository ID。这里的 RESTIC_PASSWORD 是整个方案的安全核心:它只存在于你的服务器上,丢失后所有快照都将无法解密,因此务必把它记录在密码管理器或离线介质中,而不是只存在服务器本机。
首次备份直接执行 backup 命令即可,例如备份网站根目录和数据库导出目录:
restic backup /var/www /data/db-dumps --tag web --tag daily
命令结束后 restic 会输出新增文件数、去重后的传输量和总耗时。首次是全量备份,耗时取决于数据量和上行带宽(带宽即服务器与外部传输数据的通道容量);之后每次执行同一命令,restic 会自动做增量比对,只上传变化的数据块。
数据库备份与自动化脚本
restic 备份的是文件系统层面的内容,而 MySQL、PostgreSQL 这类数据库的数据始终在内存和磁盘上动态变化,直接拷贝数据目录可能得到不一致的副本。正确做法是先用 mysqldump 或 pg_dump 导出一致性 SQL 文件,再交给 restic。以 MySQL 为例,可以把导出和备份写进同一个脚本:
#!/bin/bash
set -euo pipefail
mysqldump --single-transaction --all-databases | gzip > /data/db-dumps/all-$(date +%F).sql.gz
restic backup /var/www /data/db-dumps --tag web
--single-transaction 保证 InnoDB 导出过程中不锁表,对线上业务几乎无感;gzip 压缩能在 restic 加密前先减小体积,进一步降低存储开销。
把脚本保存为 /usr/local/bin/backup.sh 并赋予执行权限后,用 cron 定时执行。执行 crontab -e 加入一行:
30 3 * * * /usr/local/bin/backup.sh >> /var/log/restic-backup.log 2>&1
这表示每天凌晨 3:30 执行备份并把日志追加到指定文件。环境变量建议改为从 root 权限的 /etc/restic.env(chmod 600)读取,避免密钥出现在进程列表里。关于定时任务与文件同步的更多实践,我们在用 rsync 与 crontab 搭建服务器定时任务里有专门介绍。
保留策略:用 forget 控制存储成本
每天一个快照、从不清理,仓库体积迟早失控。restic 提供按时间保留的 forget 命令,配合 --prune 真正释放空间。一条常用的策略是「保留最近 7 天 + 最近 4 周 + 最近 6 个月各一份」:
restic forget --keep-daily 7 --keep-weekly 4 --keep-monthly 6 --prune
把它追加到备份脚本的最后,仓库就会自动收敛在一个可预期的体积附近。执行 prune 时 restic 会重写仓库索引并删除无引用的数据块,建议安排在业务低峰期,并确认脚本中 set -euo pipefail 会让任何一步失败时中断并留下日志。
需要注意的一点是:forget 删除的快照无法找回,执行前先跑一次 restic snapshots 确认保留规则覆盖了你想留的时间点,避免策略写错导致历史版本被误删。
恢复演练:备份只有在恢复成功时才有价值
很多团队的备份体系看起来完善,出事后才发现从未验证过恢复流程。restic 的恢复只需要两条命令:先用 restic snapshots 找到目标快照的 ID,再用 restore 把它解密还原到指定目录:
restic snapshots
restic restore latest --target /tmp/restore-test
latest 表示最近一次快照,也可以换成具体的快照 ID。恢复完成后,重点核对两类内容:网站的 HTML、图片等静态文件是否完整;数据库导出文件能否在测试环境中导入并正常访问。建议把恢复演练固定为每月一次的例行操作,并记录从「发起恢复」到「服务可用」的耗时,这个数字就是你的实际 RTO(恢复时间目标)。更完整的演练方法论,可以参考我们的备份恢复演练指南。
除了人工演练,restic 还提供 check 命令做仓库完整性校验:
restic check --read-data-subset=10M
这条命令会随机抽取部分数据包做完整解密读取,用于发现对象存储侧的静默数据损坏(bit rot)。每月跑一次全量 restic check,每周在备份脚本末尾追加一次抽样校验,能在灾难发生前暴露问题。
常见问题与排查思路
实际运行这套方案时,最常遇到的三类问题都有明确解法。
第一类是仓库锁:如果一次备份被中断,下次执行会报 repository is already locked。此时先用 restic unlock 清理残留锁再重试;若锁非本机持有,先确认没有其他进程仍在写入,避免误删活跃锁。
第二类是内存占用偏高:prune 和 check 在大仓库上可能消耗较多内存。可以把这两步从每日备份脚本里拆出来,安排在每周低峰期单独执行,或在执行前用 systemd-run --scope -p MemoryMax=1G 限制内存上限。
第三类是对象存储端点连通性:备份突然失败且日志显示超时,先在服务器上 curl -I https://s3.example.com 确认端点可达,再检查 Access Key 权限是否被收紧、Bucket 配额是否用尽。DNS(域名解析系统)解析异常也是常见诱因,可以对比 dig s3.example.com 的解析结果是否稳定。
总结与下一步行动
回顾整套方案:restic 负责客户端加密、去重和快照管理,对象存储提供低成本异地容灾,cron 脚本把备份变成无人值守的日常任务,check 与恢复演练保证体系在需要时拿得出数据。落地顺序按本文章节推进:先在测试目录完成一次「备份 + 恢复」闭环,再接入真实业务数据,最后配置保留策略和告警。
进阶方向可以考虑两件事:一是为备份脚本增加失败告警,比如执行失败时调用邮件或即时通讯 Webhook 通知,避免备份静默失败数周无人察觉;二是多台服务器可以用 restic 统一仓库加不同 tag 的方式集中管理,配合我们此前的对象存储备份验证方法做跨机核对。
如果你在寻找承载业务的服务器,可以考虑 Hostease 的独立服务器或 VPS 主机。VPS(虚拟专用服务器)在一台物理机上划分出独立资源空间,两者均提供完整 root 权限,可直接部署本文的备份脚本。无论硬件来自哪里,我们都建议你今天就动手完成第一次恢复演练——备份的价值,永远在恢复成功的那一刻才兑现。