带宽(网络传输容量,决定单位时间内能进出服务器的数据量)跑满,是站长最容易慌、也最容易误判的故障之一:网站突然打不开,SSH 卡顿到敲一个命令要等十几秒,第一反应往往是”服务器被打了”或者”该升级配置了”。但真实原因可能只是一个压缩包被搜索引擎爬虫反复抓取、一次站点镜像、或者图片目录忘了做防盗链。这篇文章会教你如何用 nload(实时带宽总量监控工具)和 iftop(按连接实时排序的流量分析工具)这两个轻量工具,在十几分钟内把”流量到底去哪了”定位到具体进程和具体连接,帮助你区分”正常业务增长”与”异常流量”,再决定是处置、限速还是扩容。
先分清方向:出站跑满和入站跑满是两回事
排查的第一步不是急着装工具,而是先确认流量方向。在主机商后台或者监控面板里,带宽图通常分成入站(Inbound,外部流向服务器的流量)和出站(Outbound,服务器流向外部的流量)两条曲线,绝大多数”跑满”问题出在出站方向。这两类问题的处理思路完全不同:
- 出站跑满:多与网站内容被大量下载、图片被盗链、爬虫抓取大文件、服务器被当作攻击源有关,本篇的重点场景。
- 入站跑满:多与遭受流量型攻击(如 SYN Flood、UDP 反射)有关,需要在防火墙或上游做过滤,单机排查手段有限。
另一个常见误区是把”带宽跑满”和”CPU 跑满”混为一谈。如果你在 SSH 里执行 uptime 看到 load average 只有 0.5,但网站依然卡死,那基本可以确认瓶颈在网络而不是计算资源;反过来,如果 CPU 长期 100%,带宽图可能只是被拖累的次要症状。先花一分钟分清方向和瓶颈类型,后面的排查才不会走弯路。关于服务器整体的性能判断方法,可以参考我们之前的 服务器运维文章分类。
用 nload 确认总量:现在到底跑了多少
nload 的价值在于”快”:一条命令就能看到每块网卡的实时入站、出站速率和累计流量,不需要任何配置。它回答的问题是”现在流量有多大、方向是哪边”,但不会告诉你流量属于哪个连接,这一步留给后面的 iftop。安装方式因发行版而异:
apt install nload -y      # Debian / Ubuntu
yum install nload -y      # CentOS 7 / AlmaLinux / Rocky
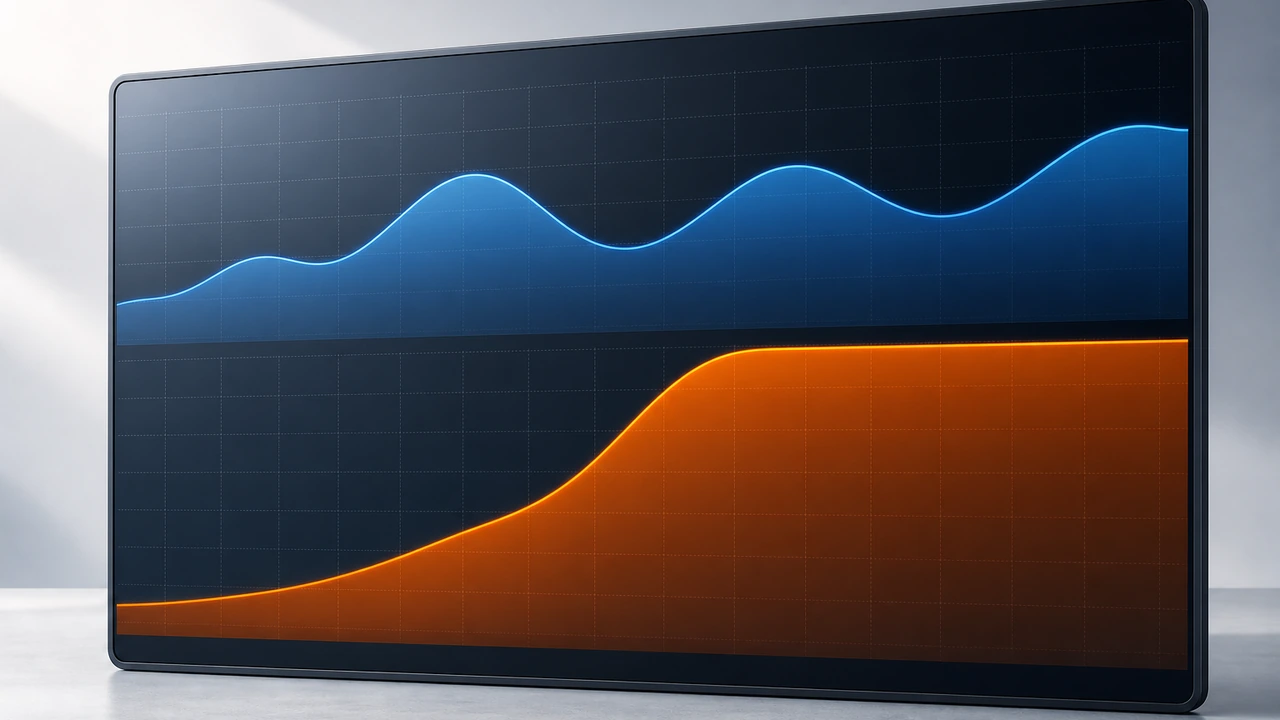
直接运行 nload 即可进入实时界面,按左右方向键可以在多块网卡之间切换,按 q 退出。界面上半部分是入站曲线,下半部分是出站曲线,右侧会给出当前速率(Curr)、平均值(Avg)、最小值(Min)和最大值(Max)。几个实战判读技巧:
- 对比套餐带宽:一台标称 100Mbps 的 VPS(虚拟专用服务器),如果出站 Cur 长期贴着 95Mbps 以上,就是”跑满”,先记录峰值和持续时间。
- 看曲线形态:白天高峰缓升属于正常业务;凌晨三点依然满速、曲线平成一条直线的,大概率是下载、镜像或异常程序。
- 累计数据:
nload -t 5000 -a 360000把刷新间隔设为 5 秒、平均值窗口拉到 1 小时,适合判断”持续性跑满”还是”瞬时突发”。
如果服务器上还没装任何监控,建议在排查的同时把 nload 界面挂着,在另一个 SSH 窗口做后续操作,随时观察限速和封禁措施是否生效。单机视角之外,更完整的容量规划思路可以参考我们关于 网站性能优化的专题文章。
用 iftop 定位来源:流量到底去哪了
nload 告诉你”跑满了”,iftop 则回答”谁干的”。它把当前所有网络连接按实时速率排序,默认最上面就是流量最大的连接。安装同样简单:
apt install iftop -y      # Debian / Ubuntu
yum install iftop -y      # CentOS 7 / AlmaLinux / Rocky
运行时建议带上参数:iftop -nNP -i eth0。其中 -n 禁止域名反解析(避免排查时反向 DNS(域名系统)查询把 SSH 拖得更卡),-N 直接显示端口号,-P 显示端口对应的服务,-i eth0 指定网卡(多网卡环境必须指定,否则看到的是聚合数据)。进入界面后按 S/D 可以切换源端口、目标端口的显示与排序。界面上方的条形图实时显示每个连接的流量占比,底部三行分别是接收、发送、总计的实时速率。判读时盯住两个位置:
- 最上方的连接:=> 表示发送方向,<= 表示接收方向,条形图最长、速率数字最大的就是当前”吃带宽”的主角。
- 底部 Tx 峰值:如果发送速率远大于接收速率,说明是服务器主动往外发数据,重点查 Web 下载、盗链、备份上传或异常程序。
看到可疑 IP 后,先用 ss -tunap | grep 查到的IP 找到对应进程,再用 iftop -nNP -F 可疑IP/32 单独观察它的持续流量,确认是持续占用还是瞬时突发。整个排查思路可以归纳成下面这张流量地图:
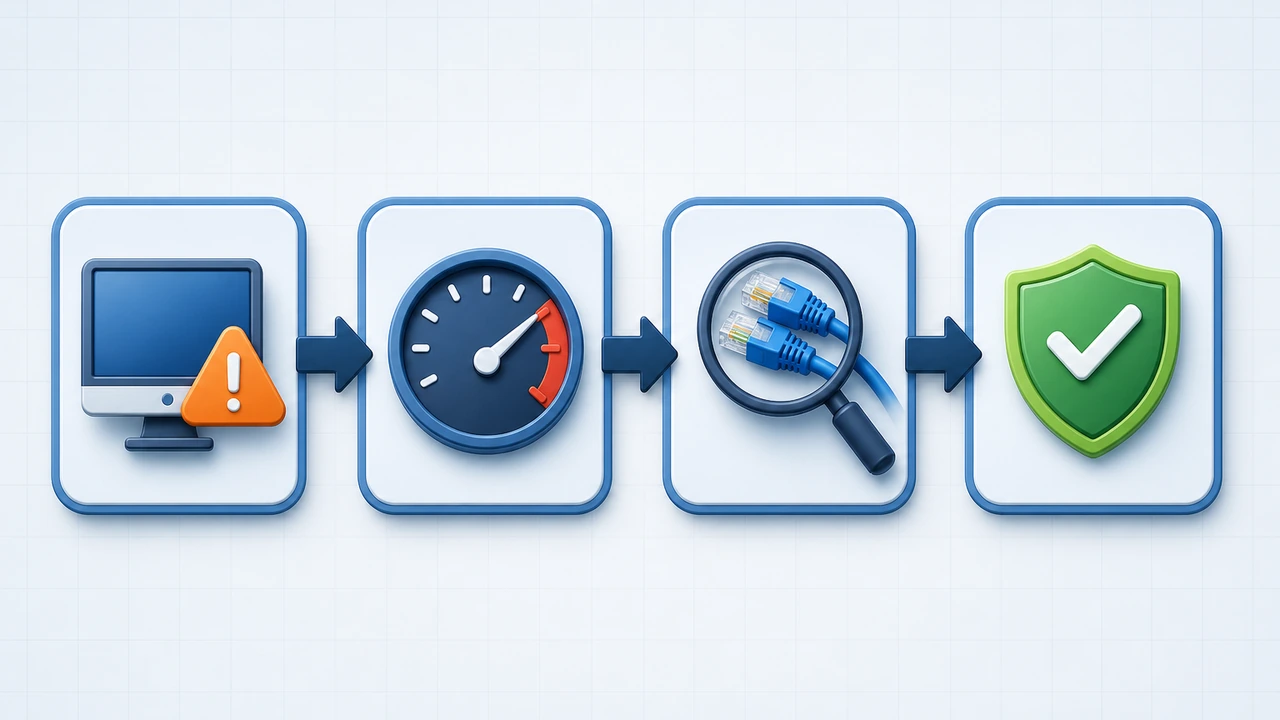
从”卡顿”到”定位到具体 IP 和端口”,熟练之后整个流程不超过十分钟。定位只是第一步,真正的关键在于看到结果后怎么分类处置。
三类典型结果与对应处置
iftop 的排序结果虽然千差万别,但归纳起来无非三类。先对号入座,再选择对应动作,能避免”一看到流量大就封 IP”的误伤:
| iftop 特征 | 典型原因 | 建议动作 |
|---|---|---|
| 本机 80/443 端口出站大、对端 IP 分散 | 正常业务高峰(活动、爆款内容) | 临时扩容或升级带宽,同时做页面静态化 |
| 同一外部 IP 或同网段长期高速下载 | 站点被镜像、爬虫抓大文件 | 防火墙封禁 + Nginx 限速 |
| 可疑进程占用、与 Web 无关的端口 | 服务器被入侵、被当跳板 | 立即隔离进程、改密、查计划任务 |
前两类都可以用 Nginx 限速直接缓解。以对单个 IP 限制下载速度为例,在站点配置中加入:
limit_req_zone $binary_remote_addr zone=dl:10m rate=5r/s;
location /downloads/ {
    limit_req zone=dl burst=10 nodelay;
    limit_rate_after 1m;    # 每连接前 1MB 不限速
    limit_rate 256k;        # 之后限制为 256KB/s
}
这套配置的含义是:先允许爬虫或用户快速拿到第一兆字节(保证页面体验),超过 1MB 后降速到 256KB/s,单个 IP 的请求频率也被限制在每秒 5 次。对图片站和资源站来说,仅这一条配置通常就能把失控的出站流量压回安全水位。图片资源如果体积本身过大,还应该在源头压缩,思路可以参考我们的 性能优化实践。
而”正常业务增长”和”异常流量”的区别,可以用下面这张对比图直观感受:
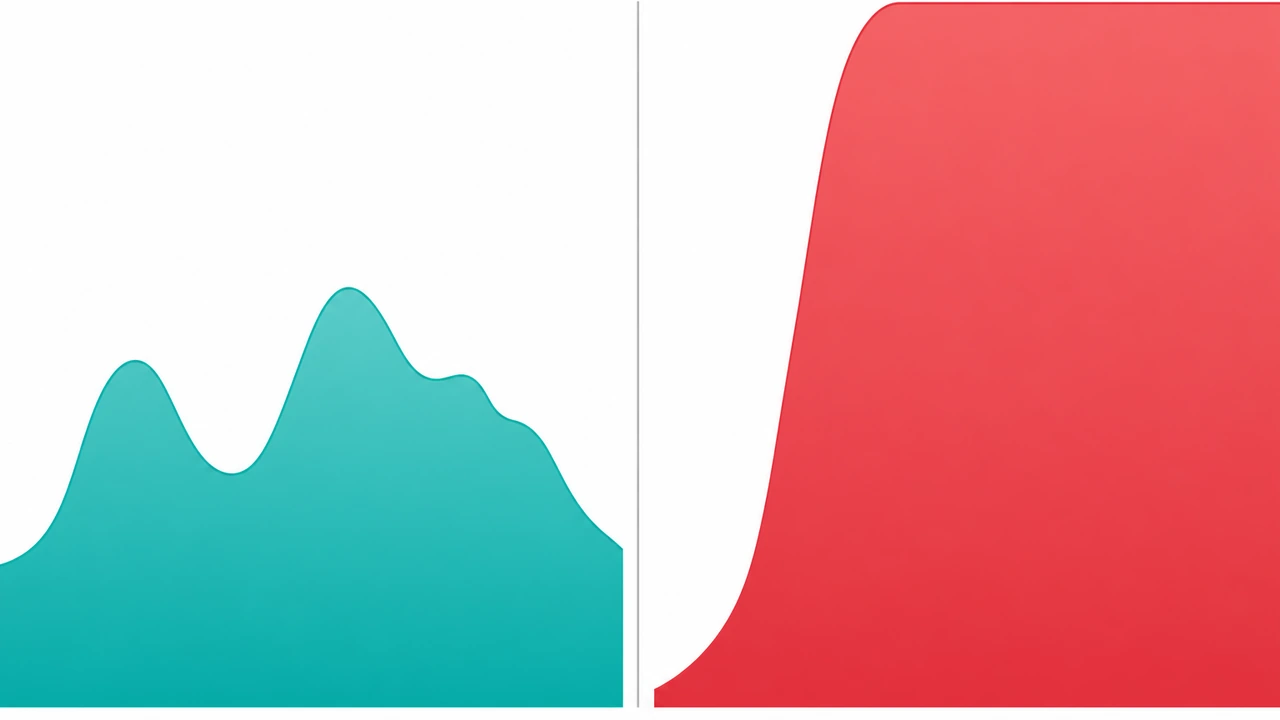
左边是健康流量的典型形态:随访问时段起伏、有峰有谷;右边则是异常流量的形态:与访问时段无关、长期贴着带宽上限走成一条直线。如果你的带宽曲线更像右图,就值得按上一节的方法继续深挖具体连接了。
总结:把一次性排查变成常规能力
回顾整个流程:nload 负责”确认总量与方向”,iftop 负责”定位到连接与进程”,再按三类场景选择扩容、限速或安全处置。这套方法的价值不止于救急——建议你把它固化为两步常规动作:
- 加监控:用 vnstat 或云监控记录每日带宽基线,例如”工作日峰值 40Mbps、夜间 5Mbps”,下次异常时一眼识别偏离。
- 做准备:提前在 Nginx 配置里保留限速模板和防盗链规则,异常发生时改两个数字即可生效,不用临场翻文档。
如果你需要更高且可预测的流量上限,可以在 Hostease 的 独立服务器方案中按业务量选择端口与带宽规格;日常运维中遇到类似网站加载慢的问题,也推荐结合我们之前的 网站性能优化指南一起看。带宽跑满从来不是”重启解决”的问题,掌握 nload 与 iftop 这对组合,你就能在故障发生的十几分钟内给出准确的判断和处置。