如果你在监控里看到从库的 Seconds_Behind_Master 一路涨到几百秒,业务读到的数据却停在几分钟前,这篇文章可以帮助你把延迟的真实来源找出来,并解决掉大部分由单线程回放引起的堆积问题。主从复制延迟(Replication Lag)是 MySQL 高可用架构里最常见的故障信号之一:主库写入正常,从库却越落越远,读写分离场景下用户会直接读到旧数据。很多人第一反应是网络慢或从库配置低,但实际排障时,真正的瓶颈更多出在 SQL 线程的回放能力上。下面我们按照先看懂指标、再定位原因、最后调整配置的顺序走完整个排查路径。如果你还没有搭建过主从复制,建议先阅读 MySQL 主从复制搭建教程,跑通基础环境后再回来处理延迟问题。
一、Seconds_Behind_Master 到底在测量什么
排查延迟的第一步,是搞清楚这个数字的真实含义。Seconds_Behind_Master 并不是”从库数据比主库旧了多少秒”,而是从库 SQL 线程正在回放的事件的时间戳与从库当前时间的差值。理解这一点,直接决定你会在哪些场景下被这个指标误导。
举三个实际会遇到的例子:
- 从库没有新事件可回放时,这个值显示为 0,但主库此时可能已经挂了——没有事件到达,不代表数据是新的。
- 一条在主库上跑了 40 分钟的大批量
UPDATE写进 binlog 后,从库上对应的事件同样带着 40 分钟前的时间戳,Seconds_Behind_Master会瞬间跳到 2400 左右,但这只是回放进行中的正常表现。 - 主从服务器时钟不一致时,这个值会整体偏移,甚至出现负数。
所以正确的用法是把 SHOW SLAVE STATUS\G 里的多个字段组合起来看,重点核对:
Slave_IO_Running和Slave_SQL_Running:两个线程必须都是Yes,任何一个不是Yes都说明复制已经中断,而不是”延迟”。Master_Log_File与Relay_Master_Log_File:如果前者明显领先,说明 IO 线程拉取正常,瓶颈在 SQL 线程回放侧。Read_Master_Log_Pos与Exec_Master_Log_Pos:两个位置点的差值就是尚未回放的事件体量,差值持续扩大就是延迟在累积。
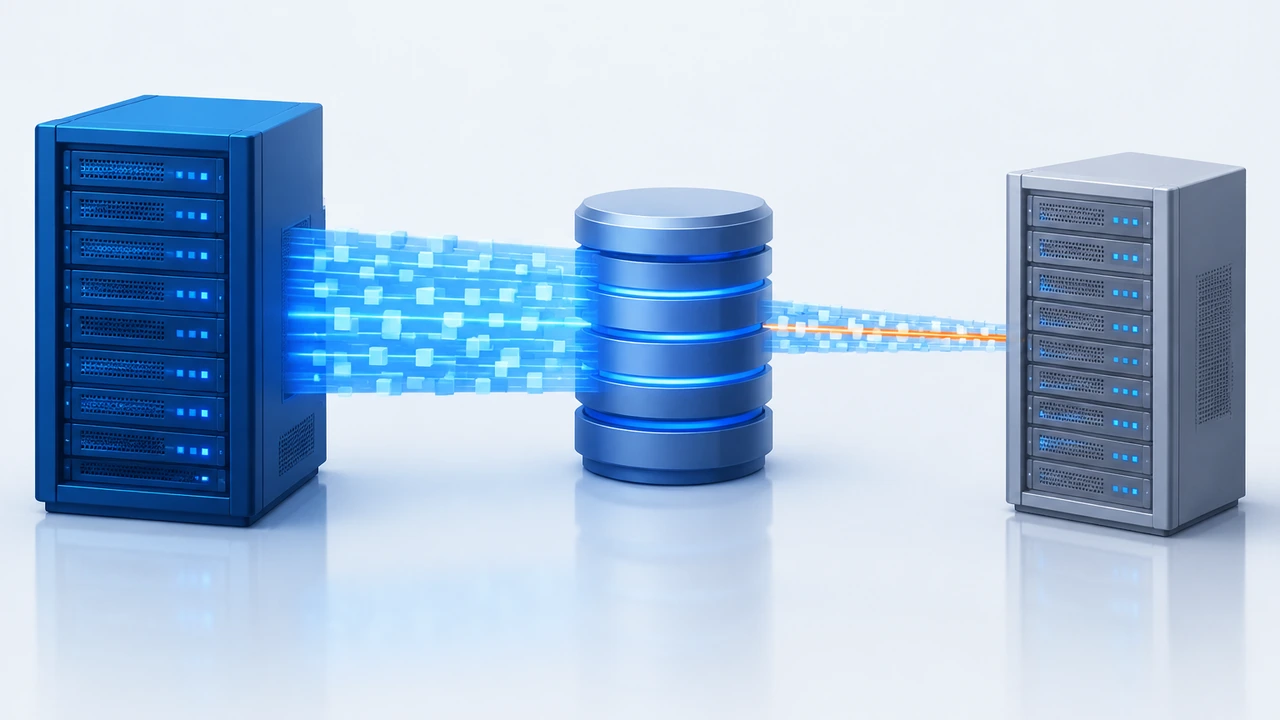
一个简单的判断规则:IO 线程位置领先、SQL 线程位置落后,问题几乎都在从库回放侧;反过来才需要去查主库 binlog 或网络。下面这张图概括了事件从主库到从库回放的完整路径,延迟可能出现在其中任何一段。
二、定位延迟来源:大事务还是单线程回放
看懂指标之后,下一步是把延迟归因。生产环境里九成以上的延迟来自两类问题:主库产生的大事务,以及从库默认的单线程回放。两者处理方式完全不同,先区分清楚再动手。
先看大事务。在从库上执行会话列表查询并观察 Info 列,若回放线程长时间停在,大概率就是主库上一条巨大的 UPDATE 或 DELETE——这类事件在主库执行了多久,从库就要原样再执行多久。处理思路是在源头拆分:把一次性更新 500 万行的任务改成每批 5000 行、循环执行,主库执行时间从几十分钟降到几秒,从库回放自然跟得上。慢 SQL 不仅拖垮主库,还会通过复制链条放大成从库延迟,具体分析见前面的 MySQL 慢查询优化实战。
再确认是不是单线程瓶颈。MySQL 5.7 及以前,从库回放默认只有一个 SQL 线程,即使主库是 64 个连接并发写入,从库也只能逐条串行回放。可以用下面这条命令快速确认当前状态:
SHOW VARIABLES LIKE 'slave_parallel_workers';
如果返回值为 0,而你的业务高峰期主库写入并发明显较高,那么单线程回放几乎可以确定就是延迟持续累积的主因。判断依据可以再叠加一条:执行 SHOW ENGINE INNODB STATUS\G 观察回放事务是否长期单条推进,同时主库侧 SHOW GLOBAL STATUS LIKE 'Com_commit' 显示每秒几十次提交——这种”主库高并发、从库单线程回放”的剪刀差,正是并行复制要解决的问题。
区分两类问题还有一个技巧:大事务导致的延迟是阶跃式的,突然飙高再缓慢恢复;回放能力不足导致的延迟是斜坡式的,高峰期持续上涨、低谷期缓慢回落。画出监控曲线就能分辨。
三、并行复制配置:从库回放提速的完整步骤
确认瓶颈在回放侧之后,并行复制就是最直接的解法。按下面的步骤配置,可以拿到比较理想的回放吞吐。
第一步,在从库的 my.cnf 中加入核心参数。slave_parallel_workers 是回放线程数量,经验值为 CPU 核数的一半,16 核从库先设 8:
[mysqld]
slave_parallel_workers = 8
slave_parallel_type = LOGICAL_CLOCK
slave_preserve_commit_order = 1
slave_parallel_type = LOGICAL_CLOCK 让同一组提交的事务并行回放;slave_preserve_commit_order = 1 保证从库提交顺序与主库一致,避免只读业务读到乱序数据。MySQL 8.0 下再在主从两侧同时打开 WRITESET,并行度还能进一步提升:
transaction_write_set_extraction = XXHASH64
binlog_transaction_dependency_tracking = WRITESET
第二步,在线生效并验证。不重启实例时可用 SET GLOBAL 动态调整——注意必须先停掉 SQL 线程再修改 worker 数量,否则会报错:
STOP SLAVE SQL_THREAD;
SET GLOBAL slave_parallel_workers = 8;
SET GLOBAL slave_parallel_type = 'LOGICAL_CLOCK';
SET GLOBAL slave_preserve_commit_order = 1;
START SLAVE SQL_THREAD;
第三步,确认并行真正起效。重启复制后观察 SHOW SLAVE STATUS\G 中 Exec_Master_Log_Pos 的推进速度,或查询 performance_schema.replication_applier_status_by_worker 确认多个 worker 都分到了事件。参考量级:8 核从库单线程回放每秒推进几百个事务,开 8 个并行 worker 后通常能到数千个,高峰期堆积的延迟从十几分钟缩短到几十秒内追平。并行度也不是越大越好——worker 超过 CPU 核数后上下文切换反而拉低吞吐,务必用真实流量观察后再微调。
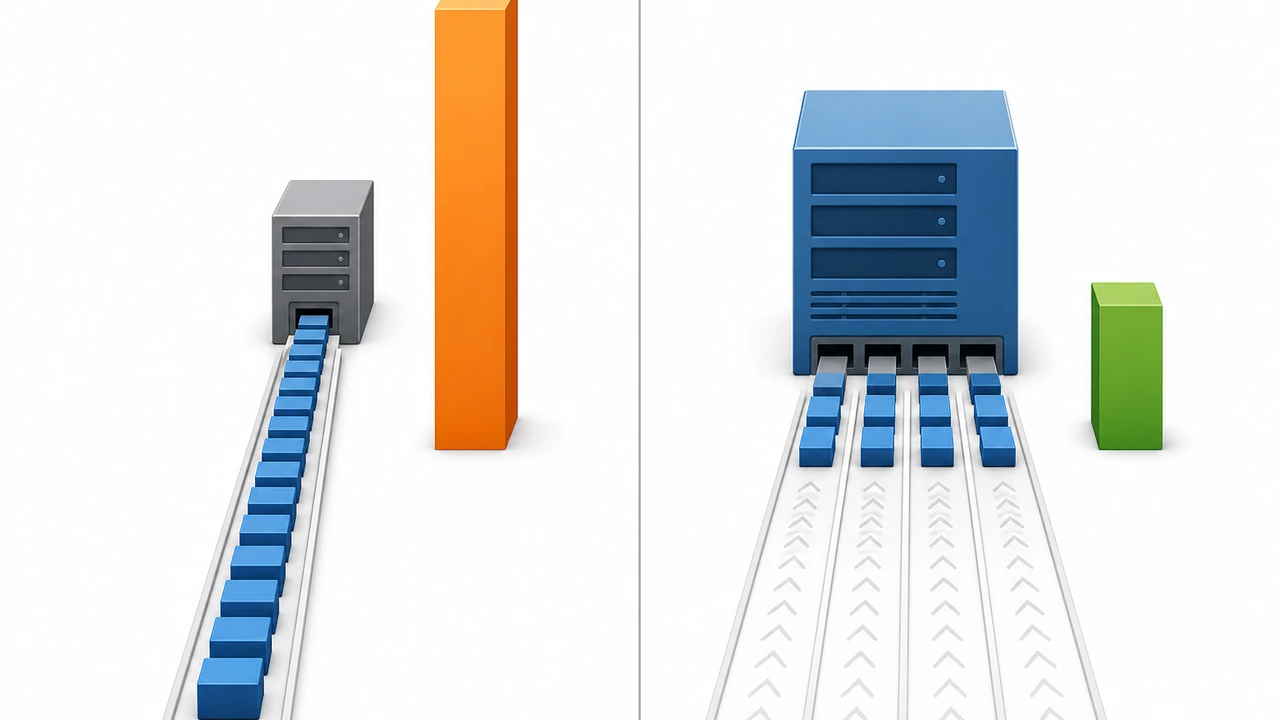
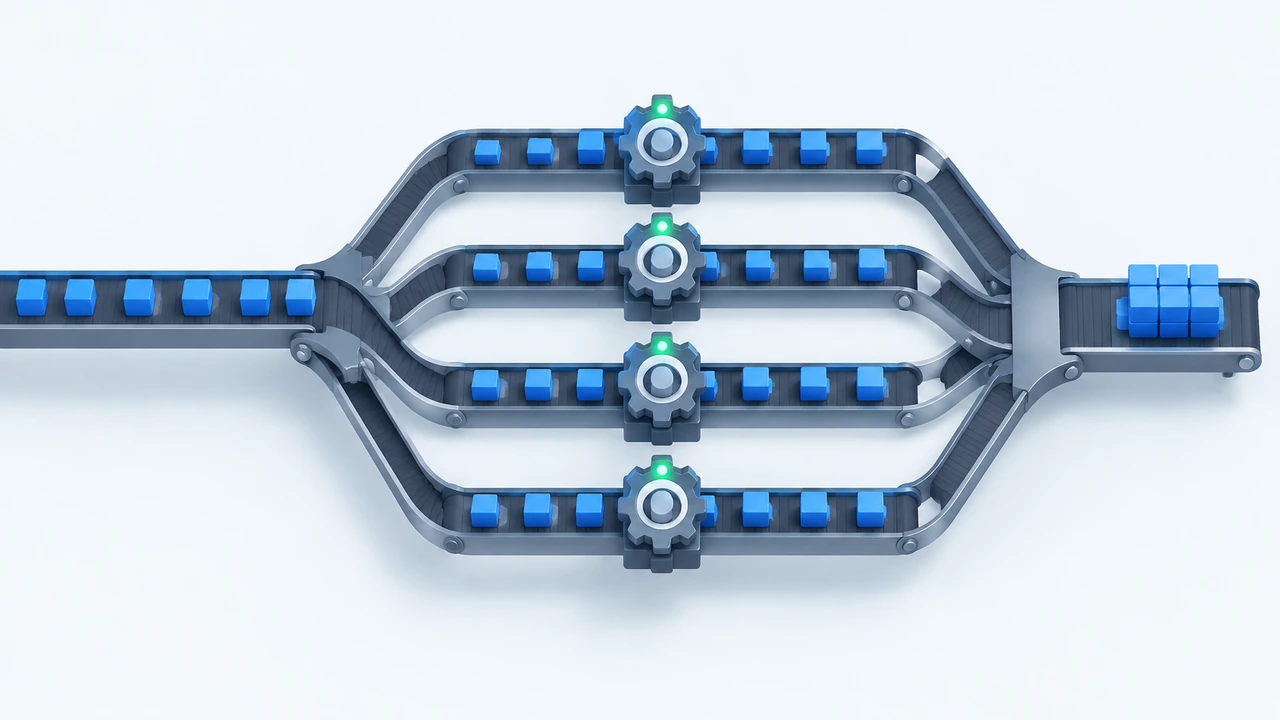
开启前后的差异见下面的对比图:同样的写入流量,单线程回放侧持续堆积,并行复制侧快速消化。
四、并行复制解决不了的延迟:另外三个常见原因
并行复制调整到位后,仍有三类延迟需要单独处理。
第一类是从库硬件资源不足。回放也是真实的写操作:每个事务都要在从库上重新执行、写 redo log、刷脏页,如果从库的磁盘写入能力明显弱于主库,worker 加得再多也追不上。判断方法是在延迟出现时执行 iostat -x 1,若 %util 长期接近 100%,瓶颈就在磁盘,最有效的手段是把从库迁移到 IOPS 更高的服务器,我们在 独立服务器承载高负载数据库的实践 中对比过不同磁盘配置的差异。
第二类是表缺少主键或唯一索引。基于行格式(ROW)的 binlog 回放时,没有主键意味着从库每同步一行都要做全表扫描,一条大表上的 UPDATE 可能把回放拖慢上千倍。用下面的语句找出无主键的表并补上:
SELECT TABLE_SCHEMA, TABLE_NAME
FROM information_schema.TABLES t
WHERE TABLE_SCHEMA NOT IN ('mysql','information_schema','performance_schema','sys')
AND NOT EXISTS (SELECT 1 FROM information_schema.TABLE_CONSTRAINTS c
WHERE c.TABLE_SCHEMA = t.TABLE_SCHEMA AND c.TABLE_NAME = t.TABLE_NAME
AND c.CONSTRAINT_TYPE IN ('PRIMARY KEY','UNIQUE'));
第三类是从库上的查询争抢。读写分离架构下,从库同时承担回放和对外查询,一条失控的慢查询可能把 CPU 和缓冲池吃满,回放线程只能排队。解决办法是给从库的业务账号设置查询超时(max_execution_time),并把分析类查询放到单独的报表从库上,慢查询定位方法可以参考 MySQL 慢查询优化实战。
五、总结与行动建议
最后把排查路径收拢成可落地的清单,建议按顺序执行:
- 先组合查看
SHOW SLAVE STATUS\G的线程状态和日志位置差值,区分复制中断与延迟累积。 - 用监控曲线判断延迟形态:阶跃式尖峰查大事务,斜坡式上涨检查
slave_parallel_workers是否为 0。 - 按”8 worker + LOGICAL_CLOCK + preserve_commit_order”组合开启并行复制,MySQL 8.0 再叠加 WRITESET。
- 仍有残余延迟时,依次排查从库磁盘 IO、无主键表和查询争抢。
总结一下:Seconds_Behind_Master 告诉你延迟了多久,要解决延迟则必须找到卡在哪一段——把从库从单线程回放升级为并行复制,配合源头拆分大事务,绝大多数场景都能把延迟稳定在秒级。如果你正在为从库硬件性能不足导致的延迟发愁,可以考虑把数据库迁移到 Hostease 独立服务器,或用 VPS(虚拟专用服务器) 承载只读副本;每次变更前也别忘了参考 数据库备份策略指南 做好快照。