当你管理着 3 台以上的 VPS(虚拟专用服务器)或云服务器时,几乎一定会遇到这样的场景:某台机器上的备份脚本已经连续 5 天没有执行,直到磁盘写满、数据库报错才发现——因为没有任何一台机器知道其他机器上跑了什么定时任务。本文要解决的正是这个问题:如何把散落在各台服务器里的 Cron(Linux 系统自带的定时任务服务)任务收拢到一处,实现统一查看、统一修改、统一告警。全文基于真实可执行的命令和配置展开,即使你只管两三台机器,也能照着把方案搭起来。
为什么分散的 crontab 会失控
Cron 本身没有问题,问题出在”每台机器各自为战”的管理方式。我们把实际运维中最常见的失控原因归纳为三类,你可以对照自查:
- 排查难:出问题时需要逐台登录执行
crontab -l,机器越多越容易漏;一台 10 台服务器的集群完整盘点一次往往要 20 分钟以上。 - 修改易漏:同一套备份逻辑复制在 5 台机器上,改了 4 台漏了 1 台,后续的故障定位会指向”改过配置”的误导方向。
- 失败无感:Cron 默认只把输出发给本地邮箱,而多数服务器根本没配邮件服务,任务失败后日志直接被丢弃。
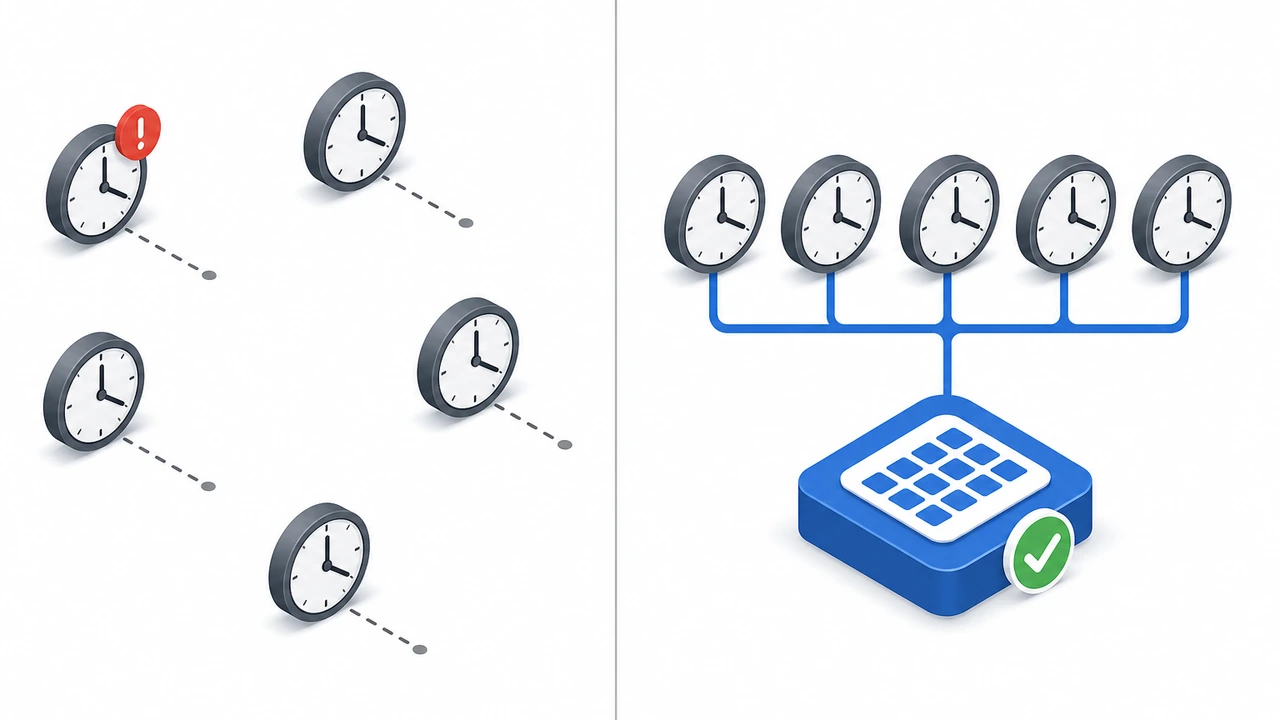
第一类失控最典型的表现是”任务黑洞”:脚本写进 crontab 之后没有任何执行记录,没人知道它上次是成功还是失败。如果你还在用手工方式同步各机器的定时任务,建议先读一下我们之前整理的 Linux rsync 与 crontab 定时备份实操,把单机层面的执行日志先补齐,再考虑跨机器的集中化——否则集中管理只是把混乱搬运到了同一个地方。
统一调度的三种路径:怎么选
集中管理 Cron 任务不是只有”上调度平台”一条路。按投入成本从低到高,有三种常见路径,分别适合不同规模的机器数量和团队情况:
路径一:Git 仓库托管 crontab 文件。把每台机器的 crontab 内容导出成文件,放进一个 Git 仓库统一版本管理,机器上用一个小脚本定期 pull 并 diff(比对差异)。改动有记录、可回滚,成本几乎为零。缺点是只能管”定义”,管不了”执行结果”——任务是否跑成功仍然要看各机日志。
路径二:SSH 批量执行器 + 中央清单。用 Ansible(自动化配置管理工具)维护一份中央任务清单,通过 ansible all -m cron -a "name=backup minute=0 hour=2 job=/opt/backup.sh" 这类命令统一下发。定义和下发都集中了,适合 10-30 台规模的场景。我们之前写过 Ansible 批量初始化 VPS 实操,其中的 inventory 组织方式可以直接复用到 Cron 管理上。
路径三:中央调度器接管执行。任务不再写在业务机器上,而是由一台中央机器通过 SSH 远程触发,或部署专门的调度系统统一派发。执行记录、重试、告警全部在中央侧完成,这是真正意义上的”统一调度”。代价是多一个单点,中央机器自身的高可用要单独考虑。
三种路径的取舍可以用一句话概括:机器少于 5 台先走路径一兜底,10 台以上且改动频繁走路径二,对任务失败零容忍的业务(如每日结算、证书续期)直接上路径三。很多团队的实际形态是三种并存——备份类任务走中央调度,机器本地只留轻量的日志清理任务。
落地步骤:用中央调度器接管定时作业
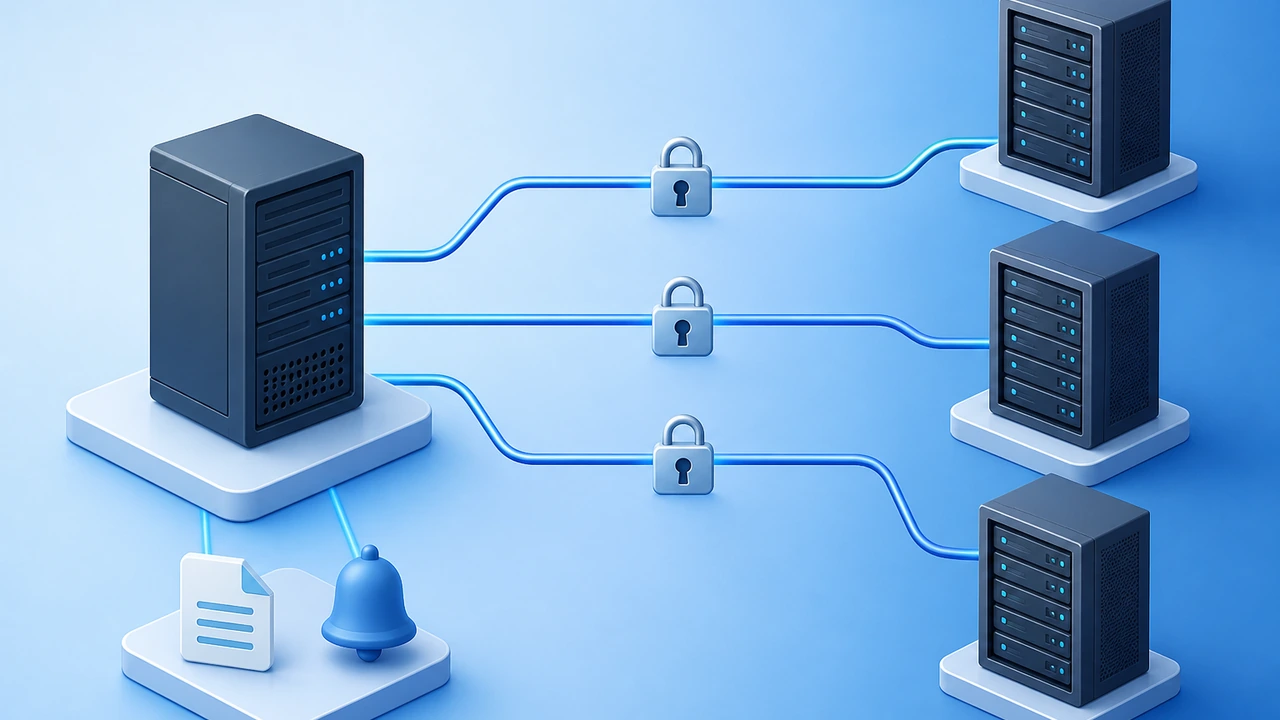
下面以路径三为主线,给出一套可以直接照做的落地步骤。核心思路是:中央机器上维护一份任务清单,每条任务通过 SSH 在目标机器上执行,执行结果写回中央日志并触发告警。
第一步:盘点并导出存量任务
先在每台机器上导出当前任务,形成基线清单,避免迁移过程中漏掉已经在跑的作业:
# 在每台目标机器上执行,导出当前用户的定时任务
crontab -l > /tmp/crontab-backup-$(hostname).txt
# root 与业务用户要分别导出
sudo crontab -l > /tmp/crontab-backup-root-$(hostname).txt
把所有导出文件汇总到一个目录后,用 grep -v '^#|^$' /tmp/crontab-backup-*.txt | sort -u 快速去重合并,人工确认哪些任务要迁移、哪些已经废弃。这一步在 10 台机器的集群上通常能清理掉 20%-30% 的僵尸任务。
第二步:中央机器配置免密 SSH
中央调度器需要能免密登录所有目标机器。生成专用密钥对并分发,注意不要复用人工登录的密钥:
ssh-keygen -t ed25519 -f ~/.ssh/cron_scheduler_key -N ""
ssh-copy-id -i ~/.ssh/cron_scheduler_key.pub user@target-server-01
# 验证免密可用
ssh -i ~/.ssh/cron_scheduler_key -o BatchMode=yes user@target-server-01 'hostname'
安全上加两条约束:在目标机器的 ~/.ssh/authorized_keys 中给这把公钥加上 from="中央机IP" 限制来源;同时确认目标机器的 SSH 配置里没有禁用公钥认证。关于 SSH 层面的整体加固,可以参考 SSH 服务器安全加固清单,把调度通道纳入统一的访问控制策略。
第三步:编写中央任务清单与调度脚本
用一份 CSV 或 YAML 清单描述所有任务,每行包含:目标机器、执行时间、命令、超时时间和失败时的重试次数。下面是一个最小可用的调度脚本骨架:
#!/bin/bash
# central_cron.sh - 中央调度脚本示例
# 任务清单格式: host,schedule,command,timeout_sec
while IFS=',' read -r host schedule cmd timeout_sec; do
  [[ "$host" =~ ^# ]] && continue
  evaluate_schedule "$schedule" || continue   # 判断当前时刻是否命中计划
  timeout "$timeout_sec" ssh -i ~/.ssh/cron_scheduler_key     "user@$host" "$cmd" >> "/var/log/central-cron/${host}-$(date +%F).log" 2>&1     || echo "$(date '+%F %T') FAILED $host $cmd" >> /var/log/central-cron/failures.log
done < tasks.csv
这个脚本本身由中央机器的 crontab 每分钟拉起,配合锁文件(flock -n /tmp/central_cron.lock)防止重复执行。任务定义从此只存在于 tasks.csv 一处,改任务 = 改清单 + 提交 Git,不再逐台登录。
第四步:配置失败告警,别让任务静默失败
集中管理的价值一半在于执行,另一半在于”失败了有人知道”。最轻量的告警方案是利用任务清单里已带回的 webhook(网络回调接口)机制——任务失败时向企业内部群或值班系统推送一条消息:
# failures.log 出现新记录时推送告警(每分钟由 cron 拉起)
NEW=$(find /var/log/central-cron/failures.log -mmin -1 2>/dev/null)
if [[ -n "$NEW" ]]; then
  tail -n 5 /var/log/central-cron/failures.log | \
    curl -s -X POST -H 'Content-Type: application/json' \
    -d '{"msg":"Cron 任务失败,请查看日志"}' \
    https://your-alert-endpoint.example/alert
fi
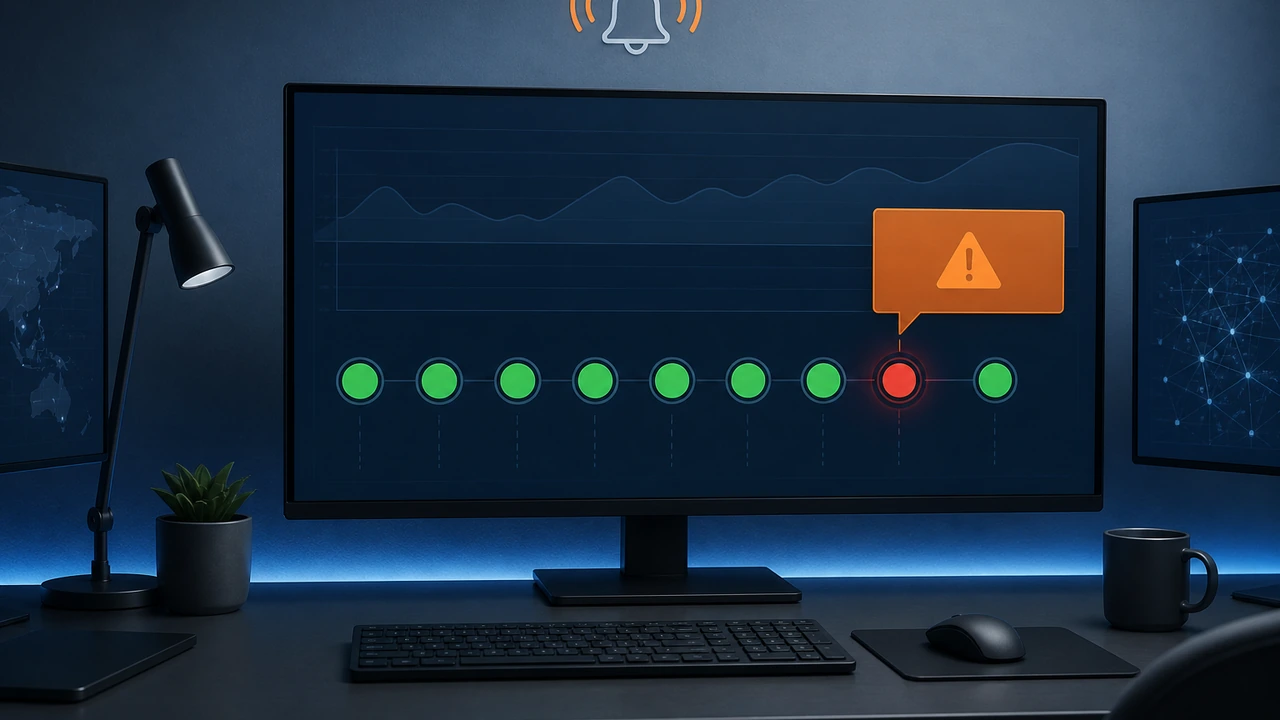
告警规则上有两条实战经验:一是”连续失败才升级”,单次失败先记录,同一任务 24 小时内失败 3 次再升级到值班,避免网络抖动造成的告警疲劳;二是给每条任务记录”最后成功时间”,超过计划周期 1.5 倍仍无成功记录就补发提醒,这条规则恰好能兜住”任务从没成功过所以从不告警”的盲区。如果任务清单里包含数据备份类作业,建议同步阅读 备份恢复演练指南——告警只解决”知道失败”,恢复演练才解决”失败之后怎么办”。
常见坑与规避方法
统一调度上线前后,有几个坑几乎每个团队都会踩一次,提前规避能省下不少排查时间:
坑一:时区不一致。中央机器和目标机器时区不同,”凌晨 2 点备份”可能实际在早上 10 点执行。上线前用 timedatectl 统一所有机器时区,或全部改用 UTC 表达任务时间。时间同步本身也是定时任务准确性的前提,可参考 Chrony 时钟校准实操。
坑二:环境变量丢失。Cron 的执行环境极简,PATH 默认往往只有 /usr/bin:/bin,脚本里裸写的 mysql、php 在命令行能跑、进 Cron 就报 command not found。规避方法是在中央清单的任务命令里写绝对路径,或在脚本开头显式 source /etc/profile。
坑三:任务重叠执行。任务执行时间超过调度间隔(如每 5 分钟跑一次、但单次要跑 8 分钟)会导致多个实例并发,写同一张表时产生脏数据。解决办法是给每条任务加互斥锁:flock -n /tmp/task.lock -c "your command",抢不到锁直接退出。
坑四:中央机成为单点。中央调度器挂了,所有定时任务停摆。至少做到两条:中央机自身的调度进程用 systemd(系统服务管理器)托管并配置自动重启;任务清单和日志每天异地备份,保证中央机重建后 1 小时内恢复调度能力。
总结与行动建议
回顾整篇文章的核心结论:Cron 任务集中管理的本质是把”任务定义、执行记录、失败告警”三样东西从各台服务器收拢到一处。分散的 crontab 之所以失控,不是因为 Cron 不好用,而是因为缺少统一的视图和统一的责任边界。
如果你正准备动手,我们建议的行动顺序是:
- 第一周:导出全部存量 crontab 形成基线清单,顺手清理废弃任务,这一步零风险且立刻见效。
- 第二周:搭建 Git 仓库托管任务定义,任何修改必须通过提交完成,杜绝”登上机器直接改”。
- 第三到四周:按业务关键度分批把任务迁入中央调度,先迁备份类任务(失败影响最直接),再迁日志清理等低风险任务。
迁移过程中保留一个原则:每台目标机器上只保留极少量”自愈型”本地任务(比如时钟同步、日志轮转),其余一律收口到中央。这样即使某台机器被重装,你也不会丢失任务定义——它安全地躺在中央清单和 Git 历史里。
在服务器选型层面,如果你的定时任务对执行时间的连续性要求高(例如每分钟级的监控采集),选择内存充足、网络稳定的云服务器(通过互联网按需使用的远程计算资源,按配置付费)或独立服务器会明显减少因资源争抢导致的任务延迟。Hostease 的 VPS 主机和 独立服务器都支持完整的 root 权限和 Cron 服务,可以作为中央调度器或任务执行节点的承载方案。如果你需要针对自己的机器数量和任务类型评估具体配置,推荐先从一台中央调度节点开始验证,再逐步扩大接入范围——有其他部署问题也欢迎在评论区留言,我们会逐一解答。