网站上线两三周,搜一下 site: 只出现首页,很多人第一反应是换主机、删稿重发。这类”网站不被收录”的问题,多数不是服务器坏了,而是抓取链路上某一环断了。下面按排查顺序说明如何核对 sitemap(站点地图)、robots 规则和 Search Console(谷歌搜索控制台)的抓取错误,每一步都给命令和判断标准。
先确认”不收录”属于哪一层
site: 只能当抽样参考,它显示索引里的近似结果,不是精确数量。真正的入口是 Search Console 的”索引编制 → 网页”报告,它把网址分成”已编入索引”和”未编入索引”,后者会给出原因,例如”已发现 – 尚未编入索引””已抓取 – 尚未编入索引””已排除(noindex 标记)””备用网页(有适当的规范标记)””软 404″”服务器错误(5xx)”。
拿到原因,问题就分成两半:抓取失败(5xx、超时、robots 拦截)属于技术层,先修主机和规则;抓取成功却没进索引属于内容层,先看质量、重复度和内链深度。用 URL 检查工具对具体网址做一次”测试实际网址”,能看到抓取状态和 robots.txt 获取结果,比盯着汇总数字有用。
第一项核对:sitemap 能不能被抓到
先确认地址。WordPress 5.5 之后自带 /wp-sitemap.xml,装 Yoast 或 Rank Math 时是 /sitemap_index.xml。用一条 HEAD 请求确认它存在且返回 XML:
curl -sSI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/wp-sitemap.xml
判断标准三条:状态码 200、Content-Type 是 application/xml 或 text/xml、返回体不是首页 HTML。不少站点因伪静态没放行 .xml,请求被重写到首页,状态码还是 200,内容却已经错了,这是”提交成功却不收录”的常见来源。
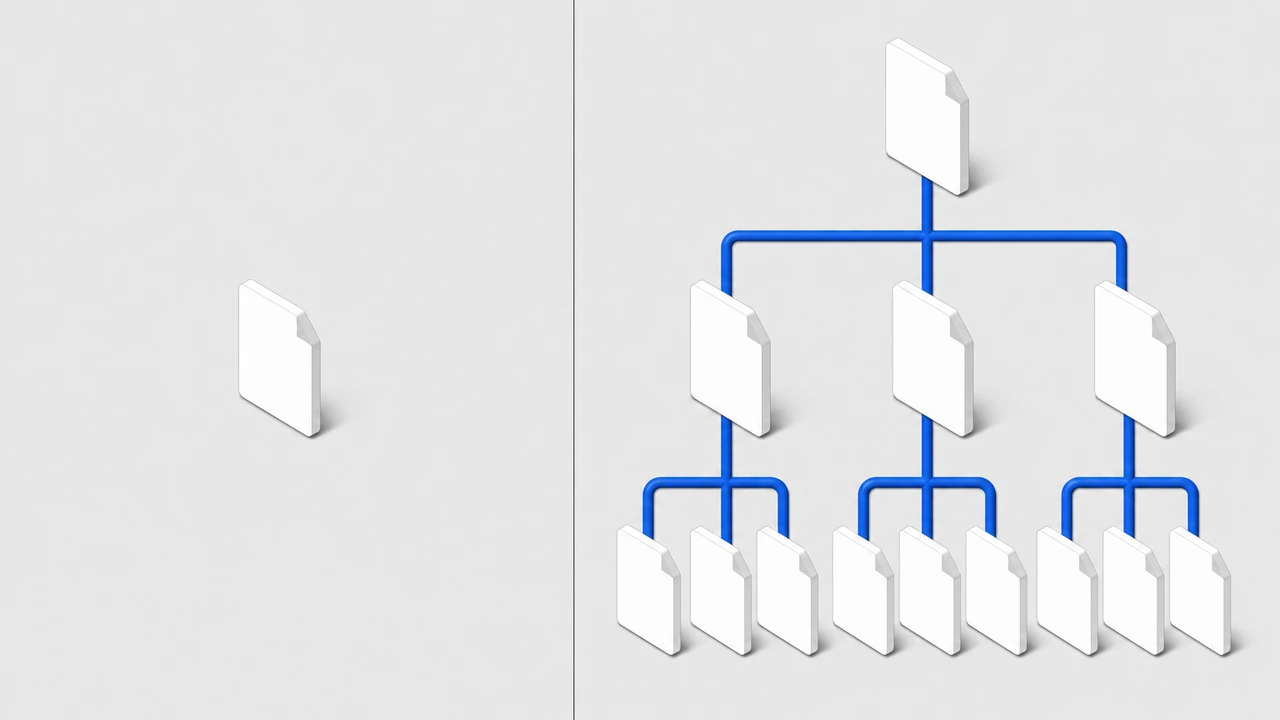
内容也要可信:子站点地图要含真实文章地址,被 noindex 的页面不该出现,分片 sitemap 在文章增加后要能自动更新。站点前面有 CDN(内容分发网络)时,还要确认 XML 没被缓存成旧版本。最后在”站点地图”报告里提交完整地址并读状态:”成功”只说明文件可读,不等于已收录。在根 robots.txt 写一行 Sitemap: 加绝对地址,能让抓取方顺带发现它。生成细节可参考站内这篇WordPress 网站地图生成教程。
第二项核对:robots 有没有挡住目录
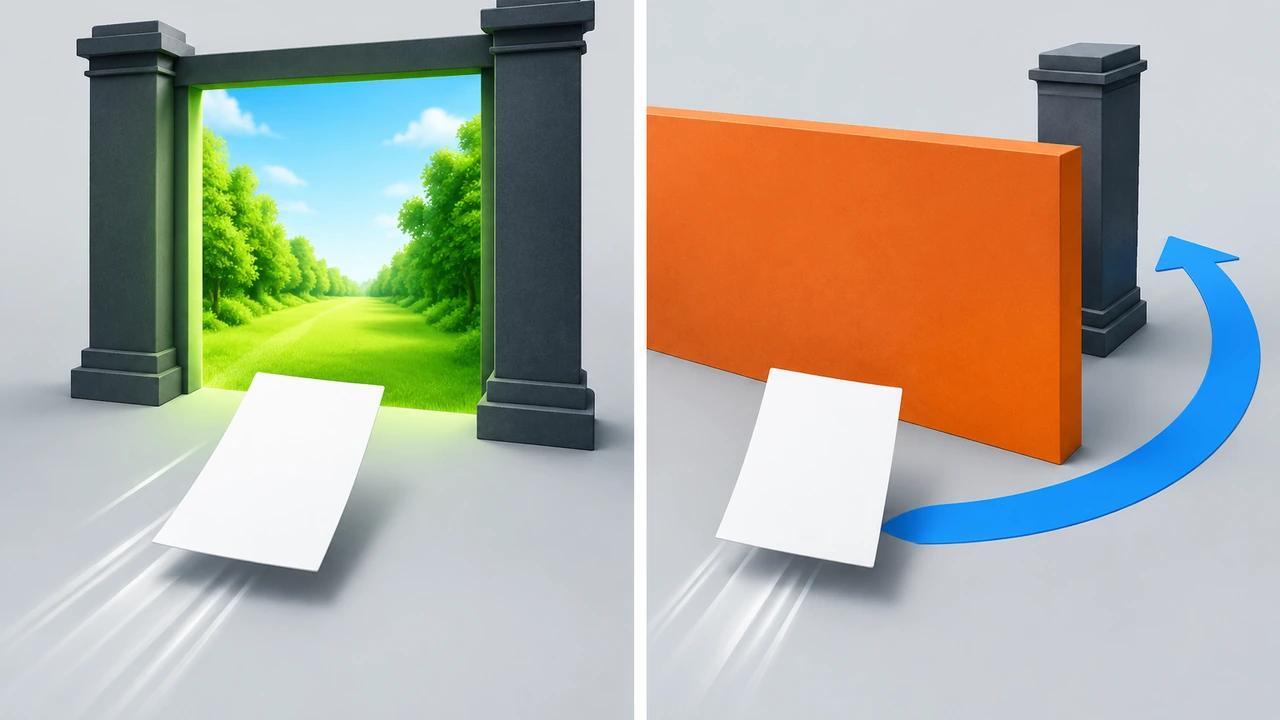
robots.txt 只认域名根目录下的一个文件:https://example.com/robots.txt。放在 /blog/robots.txt 对 Google 无效,这是子目录建站最常踩的坑——博客挂在 /blog/ 下,运维在那里写了一份规则,搜索引擎根本不会读。要挡或放行子目录,必须在根文件里写规则。
第二类坑是误伤。为了挡采集器,有人直接写 User-agent: * 加 Disallow: /,或用 Nginx 按 User-Agent 拦截;规则一宽,Googlebot 也被挡在门外。Google 不支持 Crawl-delay,写了不会被遵守。站内那篇Nginx 屏蔽恶意爬虫提到 UA 规则要留白名单,原因就在这里。
还要分清:Disallow 只阻止抓取,不阻止索引。页面被挡住后,若别处有链接指向它,仍可能以”无摘要”形式出现;反过来,noindex 标记必须能被抓到才生效,robots 一挡就永远读不到。想彻底下线,顺序是先放开抓取、让搜索引擎读到 noindex,再等索引移除。
验证很直接:用上面的 Googlebot UA 请求关键 URL,看是否 403;再在实时测试里看”robots.txt 获取状态”,显示”已屏蔽”就先改规则。
第三项核对:抓取错误怎么读
索引报告里每种原因对应不同动作,不要混在一起改。
服务器错误(5xx)优先查资源。共享主机上常见的是并发连接打满、PHP 进程数不够、数据库连接数到顶,日志会集中在同一时间段。把访问日志按分钟聚合,看 5xx 是否和备份、采集、图片批量生成重合;如果是,把备份挪到低峰或升级配置。虚拟主机(共享主机)的进程上限是硬指标,超了就是 503。
软 404 指页面返回 200,内容却是”没有找到”。它浪费抓取预算,也让搜索引擎分不清该留哪些页面。让空结果页返回真正的 404 或 410,不要用 200 加提示语糊过去。
“已发现 – 尚未编入索引”多数是抓取预算不够,或页面离首页太远。检查两点:文章是否有从栏目页或相关文章进来的内链,链接是否分散在不同章节。层级过深(首页 → 栏目 → 子栏目 → 列表 → 文章)会让深处页面排队很久,取舍思路可参考多语言网站架构里的对比。
“备用网页(有适当的规范标记)”说明 canonical(规范网址标记)指向了另一个地址,常见于 http 与 https 并存、带 www 与不带 www 并存、?utm 参数生成重复页。用 curl -sSI 看响应头与页面标签的 canonical 是否一致,不一致就统一到主地址。
用日志确认爬虫到底来没来
Search Console 数据有延迟,通常几天才更新。想立刻看效果,查服务器日志更快。
先用 cut -d" " -f1 access.log | sort | uniq -c | sort -rn | head 统计访问最多的 IP 段。真实抓取会集中在固定段,例如 Google 的 66.249.x.x;日志里几乎看不到这类请求,说明请求没到源站,问题在 DNS(域名解析系统)、CDN 回源或防火墙。
UA 可以伪造,只按字符串匹配会误判。对来源 IP 做反向解析,结果应以 googlebot.com 或 google.com 结尾,再正向解析回去确认是同一个 IP。日志里大量自称 Googlebot 的陌生 IP,那是采集器。
另一个高发问题是 403:CDN 的机器人挑战、WAF 地区封禁、限速规则都会挡掉正常抓取,而你自己用浏览器访问一切正常。把日志按状态码和 UA 交叉统计,403 集中在 Googlebot 上,就要去边缘规则里放行。按小时趋势的可视化可以用站内这套 GoAccess 日志分析配置。图片也要能抓,robots 误挡 /wp-content/uploads/,页面主体收录了,图片却进不了索引。
修复顺序与观察窗口
改动不要一次改五处,否则无法判断哪一步生效。顺序是:先修 5xx 和 403 让抓取成功;再放开 robots 误挡,让 noindex 可读;然后确认 sitemap 可访问且完整;最后处理内容质量和内链深度。每改一层记录日期和网址,方便两周后对照。
修完可以用”请求编入索引”催一次,但配额有限、官方不再公布具体次数,不能当批量提交工具。Indexing API 只对招聘信息(JobPosting)和直播(BroadcastEvent)结构化数据生效,普通文章提交无效。
观察窗口给两到四周。正常轨迹是网址从”已发现”进入”已抓取”,再进入”已编入索引”;如果两周后仍停在”已抓取 – 尚未编入索引”,问题在内容相似度,需要合并重复页、补充独有数据和案例,而不是继续折腾配置。
总结:把排查做成固定清单
顺序可以记成一句话:先看抓取成不成功,再看规则放不放行,最后看内容值不值得收。抓取失败查主机、WAF 和 5xx;规则问题查根目录 robots.txt 与 canonical;内容问题查重复度、内链和页面深度。
如果站点跑在资源有限的共享环境里、5xx 反复出现,建议先看日志中的进程数和内存峰值,再决定是否换到更高配额。Hostease 的虚拟主机方案适合流量稳定的小站,遇到批量采集或高并发促销仍需更高配置,这点不必回避。把这套检查项做成清单,每次上线新栏目都跑一遍,收录问题就会从”玄学”变成可以定位的工程问题。如果你需要,我们也可以整理成一份可执行的检查表。