网站突然集体报错”Too many connections”,页面打不开、后台登不进,而服务器 CPU 和内存看起来都很空闲——这是 MySQL 数据库连接数超限的典型现场。这篇文章解决的就是这个高频故障:教你如何一步步定位连接数被谁占用了,哪些缓解操作是安全的、哪些会引火烧身,以及如何从根源上避免它再次发生。
报错的本质:连接是有限资源
MySQL 的每个客户端连接对应服务端一个线程,连接数达到 max_connections(最大连接数上限)后,新连接一律被拒绝,报错正是 Too many connections。它不是”数据库坏了”,而是”门口排队的位置满了”——后面的请求连门都进不来。
默认的 max_connections 通常只有 151,这个数字对生产环境明显偏小,但也不能无脑调大:每个连接要消耗约 256KB 到数 MB 内存,一个连接池配置错误的应用可以在几秒内吃掉数 GB 内存。所以正确的思路永远是”先定位谁占用了连接,再决定是释放、限流还是扩容”。
第一步:定位连接被谁占用
报错发生后,数据库本地通常还保留一个管理入口(max_connections 达到上限后,额外预留 1 个带 SUPER 权限的连接位,供管理员登入处理)。用管理员账号登入 MySQL 执行以下查询,这是定位问题的核心三步:
-- 查看当前总连接数与上限
SHOW STATUS LIKE 'Threads_connected';
SHOW VARIABLES LIKE 'max_connections';

-- 查看每个连接的来源、状态和持续时间
SELECT id, user, host, db, command, time, state
FROM information_schema.processlist
ORDER BY time DESC;
拿到 processlist 结果后,重点看三类异常模式:
- 大量 Sleep 且 time 很长(如数百个 Sleep 超过 300 秒的连接):典型的应用侧连接池泄漏——连接借出不归还,常见于代码里没有正确关闭连接,或连接池的空闲回收时间设置过长。
- 同一 host 数百个连接:应用部署了多个实例但共享同一个连接池配置,每个实例各开几十个连接,乘起来直接打满上限。
- 大量 Query 状态的慢查询堆积:真正的元凶是慢查询,连接堆积只是症状,此时杀连接没有意义,新的连接会立刻继续堆积。
定位结果决定了处理路径:泄漏型要改应用配置,堆积型要治理慢查询,扩容型才涉及调参数。
第二步:安全的临时缓解操作
现场还开着门,就要先疏堵。以下操作的优先级从高到低:
- 杀掉异常空闲连接:对确认是泄漏的 Sleep 连接,用
KILL 线程ID;逐个终止,或批量生成 KILL 语句后统一执行。只杀 time 超过业务合理值的空闲连接,不要凭SHOW PROCESSLIST一眼扫过去全杀。 - 用 wait_timeout 自动回收:设置
SET GLOBAL wait_timeout = 300;,让超过 300 秒的空闲连接被服务端自动断开,缓解泄漏型占位。 - 谨慎提高 max_connections:只有确认内存充足(用
SHOW VARIABLES LIKE 'max_connections'对比当前值后,按每连接 256KB-1MB 估算增量内存)才可以临时上调,例如SET GLOBAL max_connections = 500;。这是止痛药不是治病药,上涨后必须继续查根因。
一个绝对要避免的操作:不要用 flush hosts 或重启数据库来”清空连接”。前者只清访问白名单记录,对已建立连接无效;重启会让所有正常业务跟着中断,把一个小故障放大成停机事故。
第三步:从根源解决的三个配置
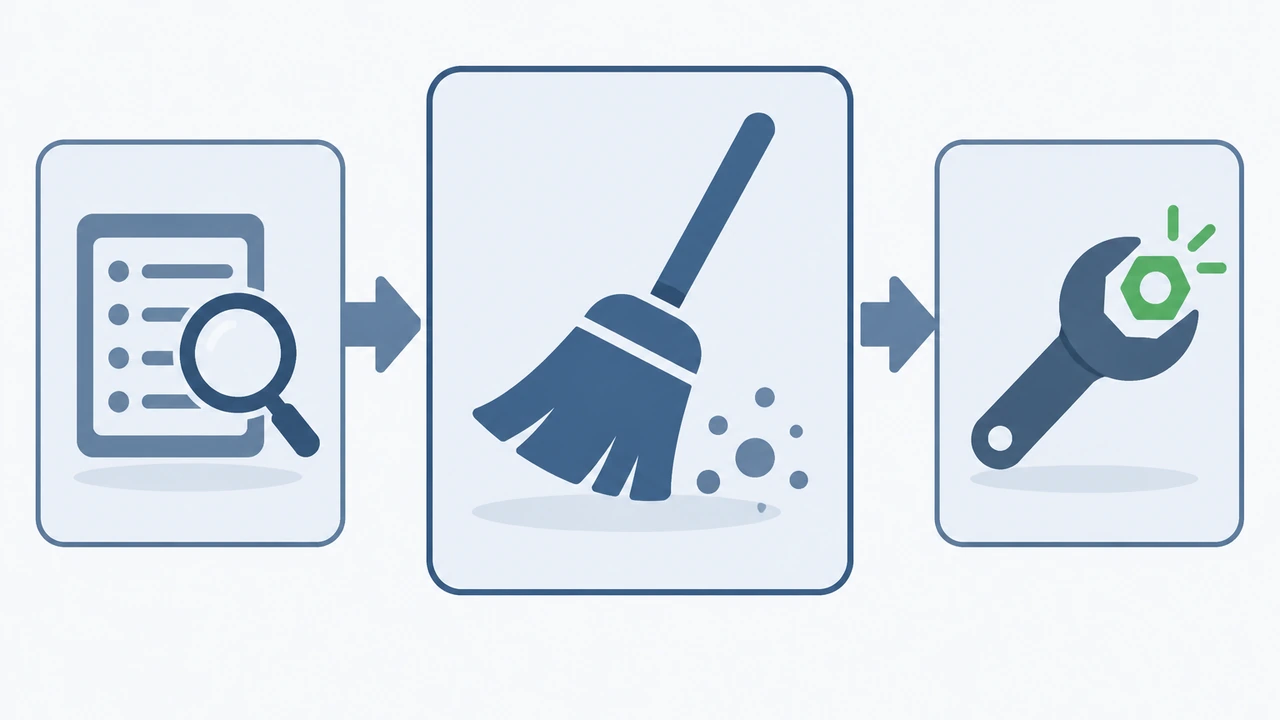
临时缓解之后,根源治理通常落在应用与数据库两侧的三个配置上:
- 应用侧启用连接池并限制总量:绝大多数 Too many connections 的根因在应用侧。给应用配置连接池(如 Java 的 HikariCP、PHP 的持久连接中间件),把单实例最大连接数控制在 20-50,多实例部署时用”实例数 × 单实例上限”倒推总量,确保总和低于
max_connections的 80%。 - 数据库侧按内存合理设置 max_connections:一条常用的估算公式是
max_connections ≈ 可用内存 / 单连接平均内存占用。一台 8GB 内存、专用于 MySQL 的服务器,设 300-500 比较稳妥;再配合innodb_buffer_pool_size优化,让内存优先服务数据缓存而不是连接开销。 - 治理慢查询缩短连接持有时间:连接的占用时长与查询时长直接相关。开启慢查询日志(
slow_query_log = ON,long_query_time = 1),把超过 1 秒的查询逐条优化,补索引、改写低效 SQL。查询快了,连接周转就快,同样的上限能服务多得多的请求。
这三项里,连接池配置的收益最直接。很多站点把 max_connections 从 151 调到 1000 后问题依旧,就是因为应用根本没用连接池——上限再高也架不住无节制的创建。
总结与行动建议
总结一下:Too many connections 是连接资源耗尽的信号,处理顺序是”先定位(processlist 分析三类模式)→ 再缓解(杀空闲连接、调 wait_timeout、谨慎扩上限)→ 后根治(连接池、内存匹配、慢查询治理)”。跳过定位直接调参数,是这个问题最常见的二次踩坑点。
建议你今天就做一件事:登入自己的 MySQL 跑一遍 Threads_connected 对比 max_connections,看看日常水位是不是已经超过 80%——如果是,连接数报警就该配上(阈值建议设在 80%),不要等报错打进来才发现。如果你正在选独立环境部署数据库,可以考虑从 Hostease 的 VPS(虚拟专用服务器)主机方案入手,资源独享对连接数与内存的匹配控制更可靠;纯建站场景也可以先了解虚拟主机方案的适用边界,再决定数据库是否需要独立部署。更多数据库与服务器运维实战可以继续看服务器专栏和 WordPress 教程分类,把数据库治理纳入日常运维清单。另外,部署公网可访问的数据库管理入口时,别忘了配好 SSL(安全传输协议)加密,避免连接凭证明文传输。最后建议把本文的三步处理顺序写进团队故障手册,下次报错出现时按流程执行,不再临时救火。