很多人想学习 Kubernetes,却被生产级集群的复杂配置劝退:多节点组网、etcd 调优、证书管理,每一步都是门槛。k3s 解决了这个问题——它把完整的 Kubernetes 控制面打包成单个二进制文件,默认内置 SQLite 数据存储和轻量运行时,让一台 2 核 4GB 的云服务器(一种按需租用的虚拟化主机)就能跑起一个功能完整的集群。这篇指南会带你完成单机部署,并整理出一套日常最常用的运维命令,帮助你把”装好”变成”管好”。
为什么单机场景适合选 k3s
单机场景最常见的痛点是资源紧张。标准 Kubernetes 发行版仅控制面组件就常驻 1GB 以上内存,而 k3s 官方文档给出的基线是:server 节点最低 512MB 内存、1 核 CPU 即可运行。对只有一台 VPS(虚拟专用服务器,在一台物理机上隔离出的独立资源单元)的用户来说,这个差距直接决定了服务还剩多少资源给业务容器。
单机部署的另一个好处是数据链路短。k3s 默认使用 SQLite 作为集群数据存储,所有状态都在本机 /var/lib/rancher/k3s/server/db/ 目录中,不需要单独维护外部数据库。对个人项目、测试环境或小型网站来说,这大幅降低了运维心智负担。
部署前先做两项检查
k3s 对系统本身要求不高,但有两点在安装前必须确认,否则装完再排查会浪费时间。
第一是端口。server 节点需要 6443 端口对外可达(kubectl 与节点注册都走这里),同时 8472/UDP 是默认 flannel 组网端口。如果你的服务器在安全组或防火墙后面,先放行这两个端口,用下面的命令验证:
ss -tlnp | grep 6443
sudo ufw allow 6443/tcp
第二是主机名唯一性。k3s 要求每台机器有唯一主机名,单机部署虽然只有一台,但如果你克隆过虚拟机或镜像,主机名可能重复,加入集群时会报节点冲突。用 hostnamectl set-hostname 设置一个明确的名字更稳妥。
一条命令完成安装
k3s 官方提供了一键安装脚本,会自动把 k3s 注册为 systemd 服务并设置开机自启:
curl -sfL https://get.k3s.io | sh -安装脚本会同时完成几件事:写入 kubeconfig(kubectl 的集群连接配置文件)到 /etc/rancher/k3s/k3s.yaml,并附带安装 kubectl、crictl、ctr 以及 k3s-killall.sh、k3s-uninstall.sh 等辅助脚本。安装完成后等 30 秒左右让服务完成初始化,然后验证节点状态:
sudo k3s kubectl get node -o wide看到 STATUS 为 Ready 就说明集群正常。如果停留在 NotReady 超过两分钟,通常是容器运行时网络没就绪,查看服务日志定位:
sudo journalctl -u k3s --no-pager | tail -50如果你想裁剪掉用不到的内置组件、进一步省内存,可以在安装时带上 –disable 参数,比如去掉捆绑的负载均衡器 Traefik:
curl -sfL https://get.k3s.io | sh -s - --disable traefik日常运维:从节点到 Pod 的五组命令
装好只是第一步,日常管理主要围绕资源状态和排障展开。下面这五组命令覆盖了单机 k3s 90% 的日常操作,注意系统已把 kubectl 链接为 k3s 的子命令,也可以直接用 kubectl。
第一组:查看资源状态
sudo k3s kubectl get nodes
sudo k3s kubectl get pods -A
sudo k3s kubectl get svc,deploy -A
get 是使用频率最高的命令,-A 表示所有命名空间(Kubernetes 中隔离不同项目资源的逻辑分组)。单机环境下重点看 pod 是否全部 Running,有没有 CrashLoopBackOff 或 Pending。
第二组:排查异常 Pod
当一个 Pod 反复重启时,先看事件再看日志:
sudo k3s kubectl describe pod <pod名称> -n <命名空间>
sudo k3s kubectl logs <pod名称> -n <命名空间> --tail=100
describe 输出底部的 Events 部分会直接告诉你失败原因,比如镜像拉取失败、探针超时或端口冲突。logs 则显示容器内部的应用日志,–tail 限制行数避免刷屏。这两个命令的组合基本能解决大部分部署报错。
第三组:进入容器与资源用量
需要现场调试时,exec 命令相当于登进容器内部:
sudo k3s kubectl exec -it <pod名称> -n <命名空间> -- /bin/sh查看节点和 Pod 的实际资源消耗,用 top 系命令:
sudo k3s kubectl top node
sudo k3s kubectl top pods -A --sort-by=memory
注意 top 依赖内置的 metrics-server,单机版 k3s 默认已启用。按内存排序能快速定位吃内存最多的应用,2GB 内存的机器上这一步建议每天看一次。
第四组:升级与回滚
应用发新版本时,set image 是最快的滚动更新方式:
sudo k3s kubectl set image deployment/<应用名> <容器名>=新镜像:标签 -n <命名空间>
sudo k3s kubectl rollout status deployment/<应用名> -n <命名空间>
sudo k3s kubectl rollout undo deployment/<应用名> -n <命名空间>
rollout status 会阻塞直到更新完成,适合写进发布脚本;如果新版本出现问题,rollout undo 一条命令就能回滚到上一个版本。这套机制比手动改文件再重启安全得多。
第五组:备份与恢复
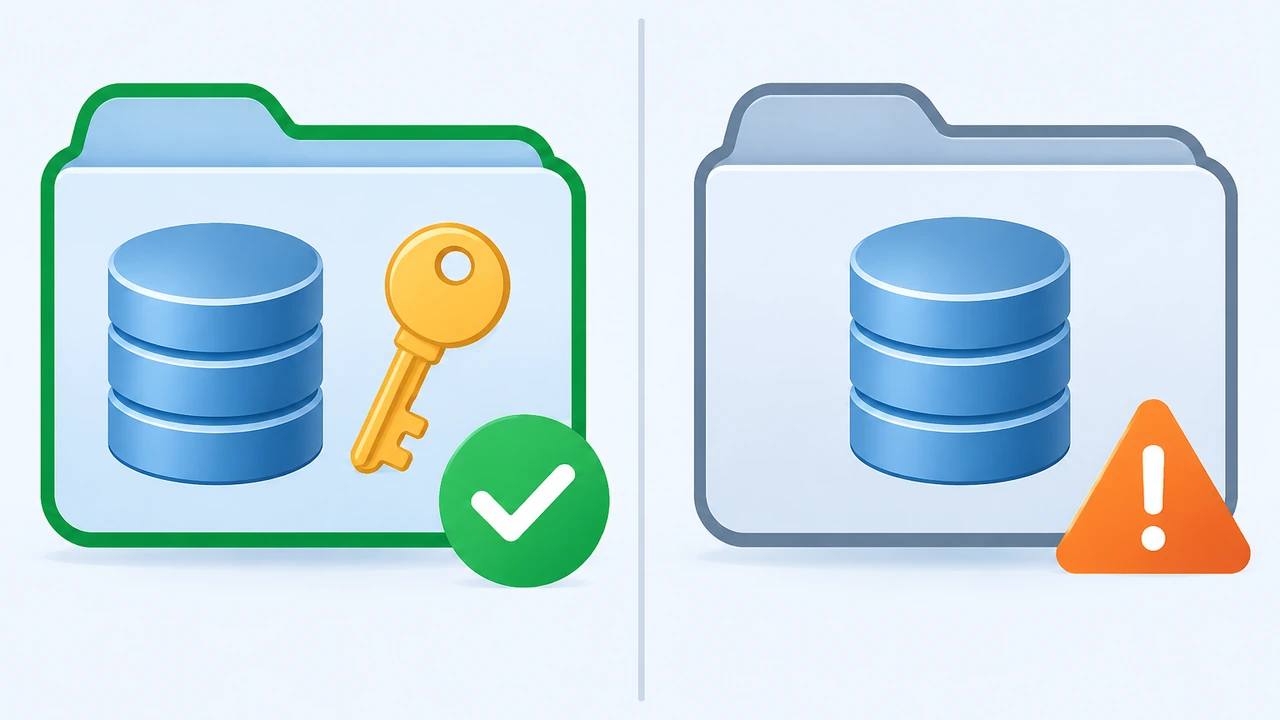
单机 k3s 用 SQLite 存数据,官方文档明确:备份时必须拷贝整个 /var/lib/rancher/k3s/server/db/ 目录,同时还要备份 /var/lib/rancher/k3s/server/token 文件——token 用于加密数据存储中的机密信息,恢复时若不带同值 token,快照将无法使用:
sudo cp -r /var/lib/rancher/k3s/server/db /backup/k3s-db-$(date +%F)
sudo cp /var/lib/rancher/k3s/server/token /backup/k3s-token
恢复时先停服务,把 db 和 token 放回原位再启动即可。建议把这两条命令加进 crontab 每天执行,配合 服务器 3-2-1 备份策略 把备份同步到异地。
常见问题与边界
单机部署虽然简单,有几个边界要先想清楚。
一是可用性上限。单机意味着节点宕机服务就中断,kubectl get nodes 也只有一行输出。如果业务对可用性有要求,可以后续追加 agent 节点组成多节点集群,官方文档里 k3s 高可用部署 方案要求至少 3 个 server 节点才能启用内置 etcd 高可用。
二是资源监控不能省。轻量不等于不需要观测,建议部署 netdata 或 node-exporter 这类轻量监控,参考这篇 Prometheus 监控部署指南 搭建基础告警,内存打满前就收到通知比事后救火成本低得多。
三是容器基础安全。k3s 默认开放 6443 API 端口,公网服务器上建议用防火墙限制来源 IP,只允许自己的管理机访问;更进一步可以按这篇 SSH fail2ban 加固指南 的思路对暴力破解做自动封禁。
清理与卸载的正确姿势
测试完想彻底清掉 k3s 时,不要手动删文件——安装脚本生成的卸载脚本会一并停止服务、删除本地数据存储和所有相关配置:
/usr/local/bin/k3s-uninstall.sh官方文档特别提醒:卸载会删除本地集群数据和 Local Storage 持久卷数据,但不会动外部数据存储和外部持久卷。卸载前务必确认重要数据已导出,这个操作没有撤销机会。
总结与行动建议
k3s 把 Kubernetes 的学习曲线从”先组集群再学命令”压缩成”一条命令装好、五组命令管住”,对单机用户非常友好。回顾一下核心路径:装前检查 6443 端口和主机名,用官方脚本安装,日常用 get/describe/logs/exec/top 五组命令覆盖状态查看、排障、调试和资源观测,用 db+token 双备份保住数据安全。
建议先在一台测试机上把这篇文章的命令全部跑一遍,熟悉之后再迁移到生产。如果你需要一台干净的服务器来做练习,Hostease 的 VPS 主机 支持 Linux 系统快速重装,装坏了随时重置重来;需要更强算力的话也可以考虑 独立服务器 跑多节点集群。把命令练熟,比收藏十篇教程都有用。