网站明明 CPU 和内存都不紧张,页面却时不时卡上几秒,这类问题很多时候不是算力不够,而是磁盘读写排队了。本文教你如何用 iostat 和 iotop 两个命令行工具,从”磁盘整体忙不忙”和”谁在疯狂读写”两个方向入手,一步步定位服务器磁盘 IO 瓶颈,全文命令都可直接复制执行,帮助你把排障时间从几小时压缩到几分钟。
为什么磁盘 IO 慢会把整个服务器拖垮
磁盘是服务器里最容易成为瓶颈的部件之一。CPU 一次计算只要毫秒级,内存访问更快,而一块机械盘的随机读写延迟可能在 10 毫秒以上,普通 SATA 固态盘虽然快很多,但在高并发写入时同样会排队。这也是为什么很多站长把网站从小型 VPS 主机(虚拟专用服务器)迁移到更高配置后,卡顿问题反而集中在磁盘指标上——硬件规格变了,磁盘层面的排查方法并没有变。
你可以这样理解:进程每次读文件、写日志、查数据库,最终都要落到磁盘上。当磁盘忙不过来时,请求就会在队列里等待,等待时间被层层放大——数据库查询变慢,PHP 进程等待数据库,Web 请求堆积,用户看到的就是页面加载越来越慢。这时候如果只升级 CPU 或加内存,问题不会消失,钱花在了不对的地方。
所以除了升级硬件,日常的磁盘 IO 监控同样是每个站长应该掌握的技能——借助它可以在用户投诉之前就发现隐患。所以在动手优化之前,先回答两个问题:磁盘到底忙到什么程度?是哪个进程在大量读写?iostat 回答第一个问题,iotop 回答第二个问题。
用 iostat 看磁盘整体负载
iostat 属于 sysstat 工具包,负责从块设备层面给出磁盘的读写速率、请求队列长度和利用率。如果你的服务器上还没有这个命令,先安装它:
# Debian / Ubuntu
apt install sysstat

# CentOS / AlmaLinux / Rocky Linux
yum install sysstat
安装后直接运行 iostat -xz 1,其中 -x 表示输出扩展统计,-z 隐藏空闲设备,1 表示每秒刷新一次。重点关注下面几列:
- %util:磁盘处于忙碌状态的时间百分比。持续高于 80% 说明磁盘接近饱和,是判断慢磁盘最直接的信号
- await:每个 IO 请求的平均等待时间(毫秒)。机械盘正常应在 10ms 以内,超过 50ms 说明请求在排队
- r/s 与 w/s:每秒读请求和写请求次数,用来判断负载类型是读多还是写多
- aqu-sz:平均队列长度,持续大于 2 通常意味着磁盘处理能力已经跟不上请求速度
一个典型的高负载输出是这样的:某块盘 %util 长期贴着 100%,await 从平时的 3ms 涨到 80ms,同时 w/s 达到每秒 400 次。这时可以基本断定,变慢的根源就在这块盘的写入压力上。如果多块盘里只有一块异常,还要留意是不是日志或临时目录集中写在了同一块盘上。
用 iotop 找出高 IO 进程
iostat 告诉你”磁盘很忙”,但定位问题还需要知道”是谁把它搞忙的”,这一步要用 iotop。它是基于内核 IO 记账的工具,需要 root 权限运行:
# Debian / Ubuntu
apt install iotop

# CentOS / AlmaLinux / Rocky Linux
yum install iotop
运行 iotop -oP 最有实用价值:-o 只显示当前有 IO 活动的进程,-P 按进程而不是线程聚合,避免同一个服务的一堆线程刷屏。排障时我们建议的观察方式是盯 30 秒左右,记录读写量最大的前几个进程,通常瓶颈进程会立刻现形。
实际排查中,高频出现的”元凶”主要有这几类:
- 数据库进程(如 mysqld):慢查询、临时表落盘、备份任务都会造成持续高写入,配套检查慢查询日志往往能找到根因
- 日志写入:调试级别日志或访问日志暴涨,每小时能写掉几个 GB,可以用
du -sh /var/log/*确认目录大小 - 备份与同步任务:打包、压缩、rsync 任务集中在业务高峰执行,把白天就不宽裕的磁盘带宽(单位时间可传输的数据量)吃光
- swap 交换:内存不足时系统频繁换页,kswapd 进程出现在 iotop 前列,说明真正的问题是内存而不是磁盘
一个完整的排查案例
把两个工具串起来用一遍,思路就清晰了。假设某台跑 WordPress 的 VPS(虚拟专用服务器)白天页面响应从 800ms 涨到 5 秒以上,CPU 使用率不到 20%,内存也充足,从现象看是”没理由的慢”。排查前的第一步,是先确认磁盘层面有没有异常,避免一上来就误判成应用问题。
第一步运行 iostat -xz 1,发现 vdb 这块盘 %util 长期在 95% 以上,await 达到 60ms,而系统盘 vda 各项指标正常。问题范围缩小到数据盘。
第二步运行 iotop -oP,半分钟内 mysqld 的写入速度维持在每秒 8MB,排在所有进程之首。登录数据库查看进程列表,发现一个每天这个时段运行的统计任务在全表扫描并写临时表。
第三步对症处理:给统计任务涉及的表补上索引,把任务执行时间从高峰期挪到凌晨 3 点。处理后同一时段的 await 回落到 4ms,%util 降到 30% 以下,页面响应恢复到 1 秒内。验证方式很简单:处理后第二天再次运行 iostat -xz 1 对比同时段数据,确认指标确实回落,而不是碰巧业务量少。
这个案例说明磁盘 IO 排查的价值在于”找准再动手”——如果当时没有看 iotop,直接凭感觉升级磁盘规格,统计任务照样会在高峰期占用大量带宽,钱花了效果有限。类似的思路也适用于网站性能优化:先量化瓶颈,再决定在哪里投入。
常见慢磁盘场景与处理建议
定位到瓶颈后,处理方式取决于具体原因。下面按场景给出可落地的做法,每一条都来自实际工单中反复出现的典型情况:
- 日志失控:先清理和轮转,配置 logrotate 限制单日志大小,再把应用日志级别从 debug 调回 info,通常能减少一半以上的写入量
- 数据库写入压力大:优先优化慢查询和索引,其次考虑把 InnoDB 的刷盘参数(如 innodb_flush_log_at_trx_commit)按业务容忍度调整,最后才是升级存储
- 多服务争抢同一块盘:把日志、数据库数据、网站文件分盘存放,例如系统盘跑系统、数据盘单独给数据库,避免互相拖累
- 硬件本身老化:机械盘连续高
await且无异常进程,用smartctl -a /dev/vdb查看健康状态,出现重映射扇区增长就该计划换盘了
上面这些场景多数可以通过调整配置解决,但如果排查到最后发现是服务器本身的磁盘规格跟不上业务增长——比如网站数据量涨到几十 GB 后,机械盘的随机读写始终跟不上数据库的写入节奏——继续在软件层打转收益就很有限了。换用全闪存方案会有明显改善,Hostease 的独立服务器采用纯 SSD 存储,对数据库类应用的高随机 IO 场景更友好,可以作为扩容时的备选之一。
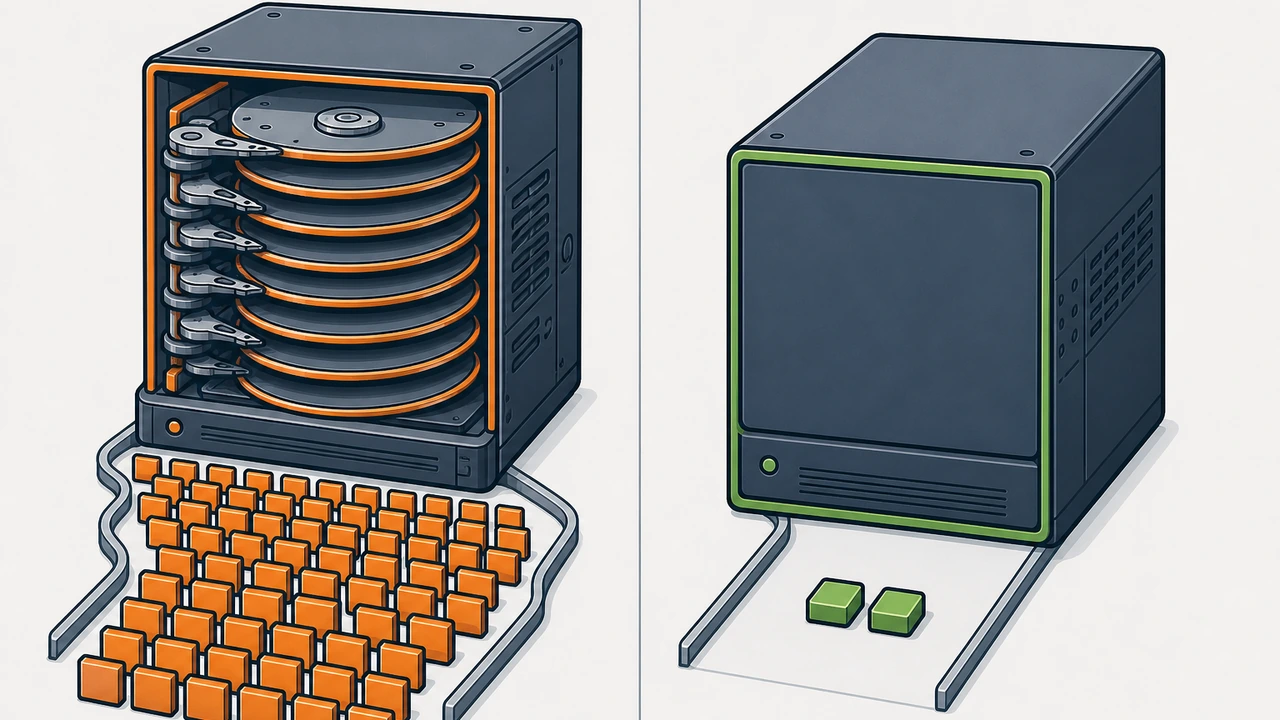
总结:把 IO 排查变成固定动作
磁盘 IO 瓶颈的核心排查路径可以压缩成三句话:先用 iostat 确认磁盘是否饱和,再用 iotop 找出占用 IO 的进程,最后针对进程类型对症处理。建议把它固化成日常运维动作:在监控系统中对 %util 设置 85% 的告警阈值,每周检查一次 /var/log 增长量,备份任务统一安排到凌晨低峰时段。
如果你需要一台磁盘性能更扎实的服务器来承载增长中的业务,可以考虑了解一下 Hostease 独立服务器,全 SSD 存储搭配中文技术支持,迁移或扩容过程中遇到问题也可以直接联系我们协助排查。总结成一句话:先建立磁盘 IO 监控的习惯,再决定硬件投入的方向,当磁盘不再排队,你在应用层做的每一个优化才能真正兑现成用户可感知的速度。