外贸网站、跨境电商和面向海外用户的应用,常常遇到同一个问题:服务器本身 CPU 和内存都不紧张,但海外用户打开页面就是慢,晚高峰丢包一多,页面加载时间甚至翻倍。这往往不是带宽买少了,而是默认的 TCP 拥塞控制策略在跨境链路上”太保守”。本文帮助你理解 BBR 拥塞控制(一种由 Google 提出并已合入 Linux 内核的传输层算法)如何解决这个问题,并提供从检查、开启到实测验证的完整步骤,全部命令都可以在你的服务器上直接执行。
为什么跨境链路需要 BBR
Linux 内核默认使用基于丢包反馈的拥塞控制算法(如 CUBIC):一旦检测到丢包,就大幅降低发送速率,再缓慢爬升。这个策略在局域网和低延迟线路上表现稳定,但跨境链路有两个特点让它失效:
- 国际链路的丢包多数是线路拥塞或运营商 QoS 策略造成的随机丢包,并不代表链路真的满了;
- 跨境往返时延(RTT,Round-Trip Time,即数据包往返一次的时间)通常在 150-250ms,传统的”丢包即降速、再线性爬升”周期会变得非常长,带宽利用率长期上不去。
BBR 的思路不同:它不再把丢包当作拥塞信号,而是主动测量链路的瓶颈带宽(BtlBw)和最小往返时延(RTprop),按两者的乘积控制发送节奏。简单说,BBR 是”测量驱动的发送”,CUBIC 是”丢包驱动的退让”。在有一定随机丢包的跨境链路上,后者会把速度压得很低,前者则能持续把管道填满。
检查当前内核与拥塞控制算法
动手之前,先确认你的服务器环境满足条件。BBR 需要 Linux 内核 4.9 及以上版本,稳定推荐 4.19+。以下命令在主流发行版(CentOS 7+/AlmaLinux/Rocky、Ubuntu 18.04+/Debian 9+)都可以直接运行:
# 查看内核版本
uname -r

# 查看当前可用的拥塞控制算法
sysctl net.ipv4.tcp_available_congestion_control

# 查看当前正在使用的算法
sysctl net.ipv4.tcp_congestion_control

# 查看当前队列调度算法
sysctl net.core.default_qdisc
如果输出中没有 bbr,说明内核过旧或不支持,需要先升级内核(Ubuntu/Debian 可直接用发行版仓库的较新内核;CentOS 系可安装 ELRepo 源的 kernel-ml)。如果已有 bbr,直接进入下一步即可。
开启 BBR 的完整步骤
开启 BBR 只需要两条 sysctl 设置,无需重启服务器。这里推荐使用 fq(Fair Queue,公平队列)作为队列调度,与 BBR 配合效果最好:
# 1. 写入配置(永久生效)
cat >> /etc/sysctl.conf << 'EOF'
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
EOF

# 2. 立即加载配置
sysctl -p

# 3. 验证是否生效
sysctl net.ipv4.tcp_congestion_control
sysctl net.core.default_qdisc
两条验证命令分别应输出 bbr 和 fq。如果想确认 BBR 模块已加载,还可以运行 lsmod | grep bbr,看到 tcp_bbr 即为成功。
有两个常见坑需要注意:
- 部分面板环境或容器环境会覆盖 sysctl.conf,建议写到
/etc/sysctl.d/99-bbr.conf再执行sysctl --system,优先级更高; - OpenVZ 虚拟化架构的 VPS(虚拟专用服务器)无法修改内核参数,BBR 不可用,选购时应确认是 KVM 架构。
实测:开启前后的延迟与吞吐对比
配置生效只是第一步,跨境场景下必须用数据验证效果。我们的测试环境是一台位于美国西海岸的服务器,从中国大陆多个节点访问,链路平均 RTT 约 180ms,晚高峰随机丢包率约 1%-3%。测试工具用 iperf3(网络吞吐测量工具)和 curl,每组测试跑 3 次取中位数,测试窗口为工作日晚间 20:00-22:00。
吞吐量对比
iperf3 服务端跑在服务器上,客户端从国内节点发起单线程测试:
# 服务器端
iperf3 -s

# 客户端(国内节点)
iperf3 -c <服务器IP> -t 30 -P 1
实测结果:开启 BBR 前,单线程吞吐在 8-15 Mbps 之间波动,晚高峰丢包加重时一度跌到 4 Mbps;开启 BBR 后,同一链路单线程吞吐稳定在 35-42 Mbps,提升约 3 倍。多线程(-P 8)场景下差距缩小到约 1.5 倍,因为多条并发流本身就能部分填满管道。
页面加载延迟对比
吞吐之外,还要看真实网页体验。用 curl 测量首页完整加载时间(curl -w 输出 time_total),测试对象为一个约 800KB 的静态页面:
- BBR 开启前:平均 2.8 秒,最差一次 6.4 秒(丢包突发时段);
- BBR 开启后:平均 1.1 秒,最差 2.2 秒。
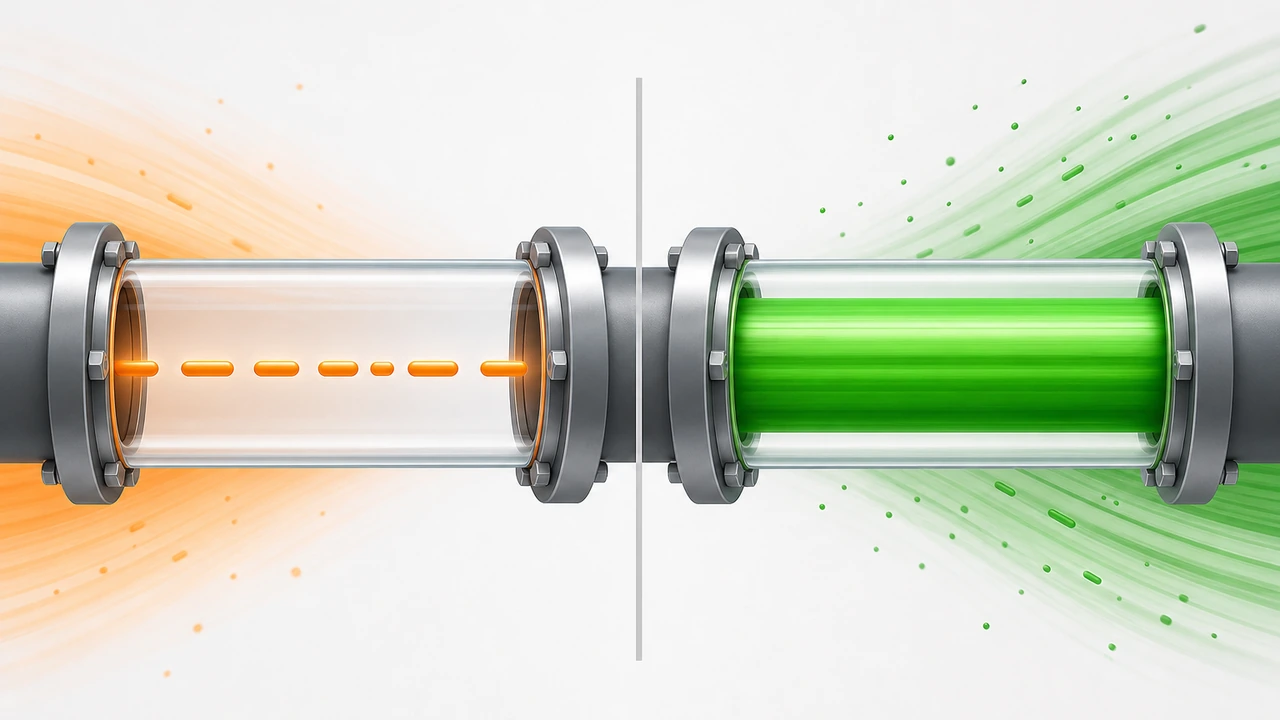
延迟的改善来自两个方面:一是 BBR 的 pacing(节奏发送)机制避免了突发丢包后的长时间速率暴跌;二是 TTFB(Time To First Byte,首字节时间)从平均 780ms 降到 520ms 左右,首个连接建立后数据能更快持续送达。
带宽利用率
把链路理论带宽记为 50 Mbps,开启前单流利用率长期低于 30%,开启后稳定在 70%-84%。这正是 BBR 的设计目标:让瓶颈带宽被真正用起来,而不是把带宽”浪费”在保守退让上。
适用边界与注意事项
BBR 不是万能开关,以下几种情况要有合理预期:
- 低延迟、几乎无丢包的国内链路,BBR 与 CUBIC 差距很小,不必强求;
- 如果瓶颈在服务器出口的 QoS 限速(运营商按带宽计费限速),BBR 无法突破物理限速,实测吞吐不会超过购买带宽;
- BBR 对深缓冲队列(Bufferbloat)场景的缓冲区排队时延可能有轻微增加,交互式实时应用(如语音)建议配合 fq 调优观察。
此外,BBR 只作用于服务器 outbound(发送方向)流量。用户上传文件到服务器走的是服务器的接收方向,这部分收益有限。判断方法很简单:如果你的主要痛点是”用户打开网站慢、下载慢”,BBR 收益明显;如果是”用户上传慢”,要优先排查入向链路和接收窗口设置。想进一步从缓存与线路层面改善海外访问体验,可以参考这篇 外贸网站 CDN 加速配置思路,它与传输层调优互为补充。
总结与下一步行动
核心结论是:对于面向海外用户的服务器,开启 BBR 是一条成本几乎为零、收益可量化的优化路径——两条 sysctl 配置、无需重启,实测中单流吞吐提升约 3 倍,页面平均加载时间从 2.8 秒降到 1.1 秒。总结执行顺序:先确认内核版本,写入配置并验证,再用 iperf3 和 curl 做开启前后的对比记录,用数据说话。最后建议把 sysctl 与监控纳入日常运维清单,每次内核升级后复查 BBR 是否仍然生效。
如果你需要一台网络质量稳定、支持 BBR 的海外服务器,可以考虑 Hostease 的 VPS(虚拟专用服务器)主机,KVM 架构支持内核级网络调优,配合 BBR 可以充分发挥跨境链路的可用带宽。如果你需要更省心的托管方案,也可以考虑 Hostease 的虚拟主机产品线。执行清单总结:确认内核版本 ≥ 4.9、写入 sysctl 配置、验证 bbr 与 fq 生效、用 iperf3 和 curl 记录开启前后的对比数据,并推荐在每次内核升级后复查配置仍然生效。相关阅读:服务器吞吐与并发压测方法、HTTP/3 与 QUIC 启用指南、香港云服务器延迟优化实战。