网站突然变慢,用户投诉页面卡顿,但你打开监控却发现 CPU 和内存都不高——这种时候,最容易被人忽略的线索就藏在 Nginx 的访问日志里。本文教你如何通过 request_time 和 upstream_response_time 两个日志变量,快速找出拖慢网站的慢请求,并判断耗时究竟发生在 Nginx、PHP 还是后端数据库。掌握这套方法后,你不需要额外安装重型监控,一条日志就能回答”到底慢在哪里”。
为什么访问日志是排查慢请求的第一入口
很多站长排查性能问题的第一反应是看 CPU、内存或者装 APM 工具,但在共享主机和 VPS(虚拟专用服务器)场景下,访问日志往往是最快、成本最低的切入点。它有三个不可替代的优势:
- 默认就在产生数据,不需要额外部署任何组件;
- 每一行都对应一次真实请求,能精确到具体 URL、IP 和时间点;
- 配合耗时字段,可以直接量化”这次请求到底花了多少毫秒”。
默认的 Nginx 日志格式并不记录耗时,所以第一步是扩展 log_format。我们建议在 http 块中定义一个包含计时变量的格式:
log_format timing '$remote_addr - $remote_user [$time_local] '
                  '"$request" $status $body_bytes_sent '
                  '"$http_referer" "$http_user_agent" '
                  'rt=$request_time urt=$upstream_response_time';
其中 $request_time 表示 Nginx 从收到请求第一个字节到发出响应最后一个字节的总耗时,而 $upstream_response_time(常缩写为 urt)记录的是后端服务返回响应所花的时间。修改后执行 nginx -t 检查语法,再 nginx -s reload 重载配置即可生效。如果你的环境没有启用代码高亮插件,直接把这段写进 nginx.conf 的 http {} 内也一样。
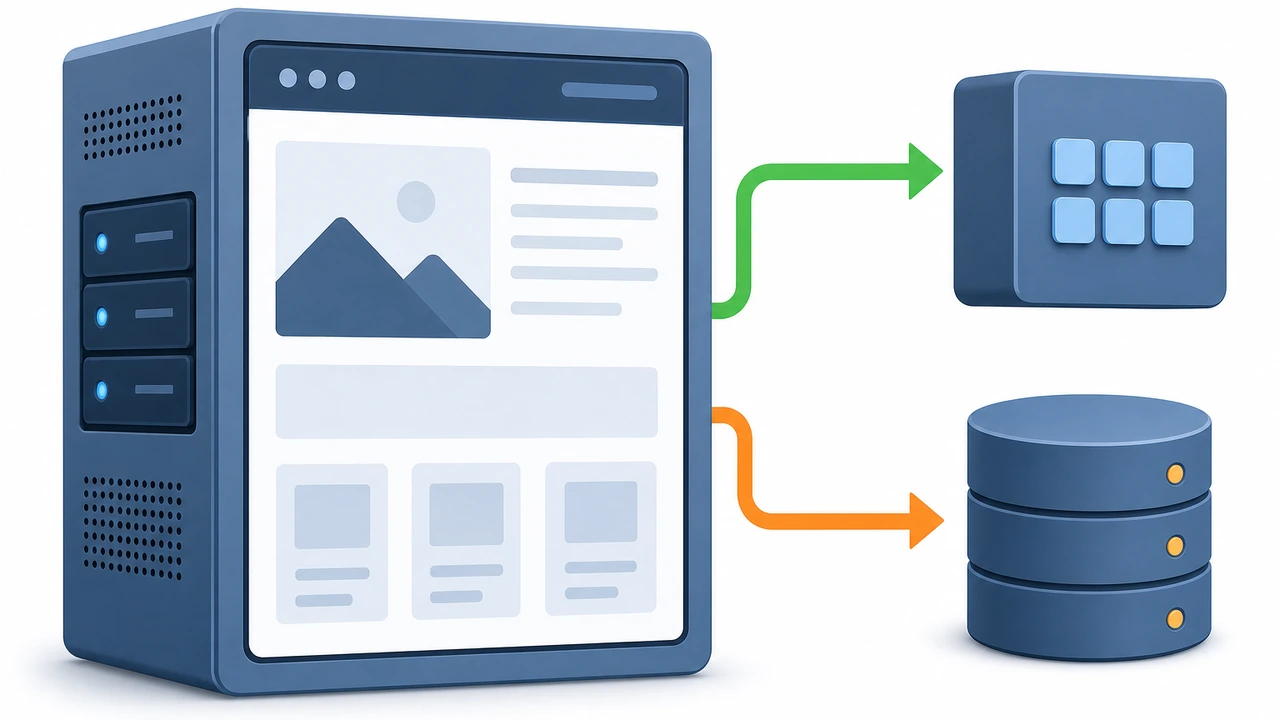
request_time 与 upstream_response_time 的关系
这两个数字的差值本身就携带信息,核心结论是:
rt ≈ urt:耗时几乎全部发生在后端应用(PHP-FPM、数据库、外部接口),Nginx 本身没有问题;rt很大、urt很小或为-:瓶颈在 Nginx 侧,常见原因是客户端网络慢、上传大文件、磁盘写入阻塞或开启了限速;- 两者都很小但用户仍然反馈慢:问题可能出在 DNS(域名解析服务)、TLS 握手、CDN(内容分发网络)缓存命中率,或者用户访问的不是这台服务器。
举个例子:一条日志显示 rt=8.502 urt=8.480,说明 8.5 秒里几乎都是后端在处理,接下来应该去看 PHP 慢日志和 MySQL 慢查询;如果显示 rt=12.003 urt=0.015,后端只用了 15 毫秒,剩下的 12 秒都耗在传输环节,要优先检查客户端网络和 Nginx 的发送缓冲配置。
用一行命令找出最慢的请求
日志格式就绪后,找出慢请求只需要一条命令。下面的脚本从 access.log 中提取耗时超过 3 秒的请求,按 URL 汇总并倒序排列:
awk -F'rt=' '{split($2,a," "); if (a[1]+0 > 3) print $0}' /var/log/nginx/access.log \
  | awk -F'"' '{print $2}' | awk '{print $2}' | sort | uniq -c | sort -rn | head -20
如果你只想看每小时的整体耗时趋势,可以用下面的命令按小时统计平均 request_time:
awk -F'[][]' '{print $2}' /var/log/nginx/access.log | cut -d: -f1-2 > /tmp/hours.log
awk -F'rt=' '{split($2,a," "); print a[1]+0}' /var/log/nginx/access.log > /tmp/rts.log
paste -d'|' /tmp/hours.log /tmp/rts.log \
  | awk -F'|' '{sum[$1]+=$2; cnt[$1]++} END {for (h in sum) printf "%s avg=%.3fs n=%d\n", h, sum[h]/cnt[h], cnt[h]}' \
  | sort
实际运维中,我们建议每天早上跑一次”超过 3 秒请求 Top 20″,连续观察一周。如果某几个 URL 反复上榜,就说明问题集中在特定功能,而不是随机抖动——这能把排查范围从一个模糊的”网站慢”缩小到几个具体的接口或页面上。
结合 GoAccess 做可视化分析
命令行适合临时排查,长期运营的站点更推荐用 GoAccess 生成实时报表。它直接解析 Nginx 日志,可以在终端或网页里看到耗时分布、访问来源和状态码统计:
goaccess /var/log/nginx/access.log \
  --log-format='COMBINED rt=%T urt=%D' \
  --date-format='%d/%b/%Y' --time-format='%H:%M:%S' \
  --real-time-html -o /var/www/html/rt-report.html
更详细的使用步骤可以参考我们之前整理的 GoAccess 服务器日志可视化分析教程。对于想要更完整方案的同学,把 GoAccess 输出和 服务器监控与告警 结合起来,就能实现”慢请求激增自动通知”的效果。
根据耗时分布定位真正的瓶颈
找到慢请求之后,下一步是判断时间花在了哪一层。一个实用的做法是把耗时分布画出来:把 request_time 按 0-100ms、100-500ms、500ms-2s、2s 以上分成四档,统计每档的请求数。如果 2 秒以上的请求集中在某些带数据库查询的 URL,并且这些请求的 urt 和 rt 几乎相等,基本可以确定是应用层问题,优先去查慢 SQL 和 PHP 慢日志。
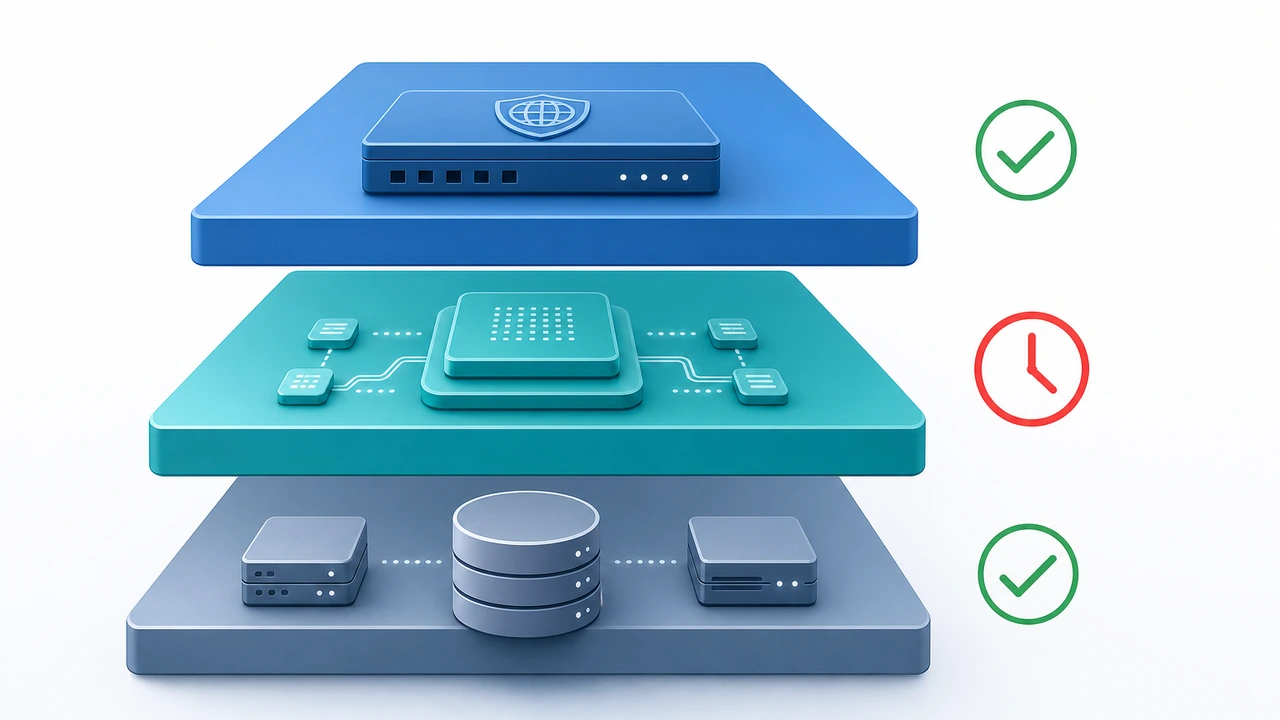
分层排查时可以按这个顺序推进:
urt高:检查 PHP-FPM 进程数是否打满、数据库慢查询、外部接口超时;urt低但rt高:检查带宽(网络传输容量)是否跑满、磁盘 IO、是否被爬虫大量抓取大文件;- 只有个别时段慢:对照日志时间点,检查是否有定时任务、备份作业在抢占磁盘。
以一个真实场景为例:某外贸站每天下午三点左右页面明显变慢,日志显示该时段 rt 均值从 0.4 秒涨到 5 秒,而 urt 始终在 0.3 秒以内。最终排查发现是备份脚本在这个时间点全量打包上传,占满了出站带宽。把备份改到凌晨并限速后,下午的耗时立刻恢复正常。这个案例说明,日志给出的时间分布往往比单次采样更能揭示规律性问题。
常见误区与注意事项
第一,不要只看平均值。平均耗时 500 毫秒可能意味着一半请求 50 毫秒、一成请求超过 5 秒,真正伤害体验的是长尾,所以统计时要同时看 P95 或 P99 分位。第二,注意 $upstream_response_time 可能包含多个值(例如 0.010, 0.350),那是请求被转发到多个 upstream 依次尝试的结果,取最大值参与判断即可。第三,日志文件本身也要管理,高流量站点建议配合 logrotate 按天切割,否则几 GB 的日志会让上面的 awk 命令跑不动。
还有一点常被忽略:容器或集群环境下,多台机器各有各的日志,直接在单机上统计会漏掉请求。这时要先把日志集中(rsync 定时拉取或使用日志服务),再统一分析。在 Hostease(恒创科技旗下主机品牌)的中文博客里,我们多次强调过”先看数据再动手”的运维习惯,日志分析正是这个习惯里成本最低、见效最快的一环。
总结与下一步建议
回顾一下整套流程:先在 log_format 中加入 request_time 和 upstream_response_time,然后用 awk 命令筛出慢请求 Top 榜单,接着区分 rt 与 urt 的差值判断瓶颈层级,最后结合分位数统计确认长期趋势。整个过程不需要新增任何付费组件,一台普通的 VPS 就能完成。
如果你需要,建议接下来做三件事:第一,今天就按上文模板给日志加上计时字段,积累基线数据;第二,把”慢请求 Top 20″做成每日定时任务,用邮件或群通知发给运维负责人;第三,如果排查后发现应用层瓶颈明显、现有主机规格吃紧,可以考虑升级到 Hostease 独立服务器,把 PHP-FPM、数据库和日志写入隔离到独立资源上,从源头减少慢请求的产生。更多主机性能相关内容,也可以浏览我们的服务器优化专栏。