打开服务器账单时,很多站长会看到一个尴尬的现象:访客数没涨,出口流量却先涨了。过去一年,AI 训练爬虫(为模型训练而自动抓取网页内容的机器人程序)从零星的测试请求变成了稳定流量,一个日 IP 五千左右的内容站,一个月被训练爬虫拉走几十 GB 并不罕见。这篇文章教你如何用访问日志把抓取量算清楚,再通过 robots.txt 声明、Nginx 里的 UA(User-Agent,爬虫自报的身份字符串)限速和缓存策略,把带宽(单位时间内可传输的数据量)压回可控范围。文中命令可以直接在服务器上执行,不需要额外的商业分析工具。
先把账算清楚:三类请求必须分开统计
一份常见的 access.log 里混着三种完全不同的访问。搜索引擎蜘蛛抓的是 HTML 和少量静态资源,单次请求小、频率稳定;训练爬虫往往按整站批量拉取,单次请求不大但总量惊人;真实用户则由页面带动几十个 CSS、JavaScript 和图片请求。把三者混在一起看,你会得到“流量涨了但不知道涨在哪里”的结论,也就无法决定该限速谁、该缓存谁。
先按天汇总出口字节数,把异常日期圈出来。Nginx 默认 combined 格式里,第十个字段就是响应字节数:
awk '{gsub(/\[/,"",$(4)); split($(4),a,":"); b[a[1]]+=$(10)}
     END {for (d in b) printf "%s %.2f GB\n", d, b[d]/1073741824}' \
     /var/log/nginx/access.log | sort -k2 -nr | head -7
某天流量比平常高出一截,基本可以确认被批量抓取。再按 UA 聚合,看是谁在拉:
awk -F'"' '{k=$(6); sub(/\/[0-9.]+.*/,"",k); if (k=="") k="-"; c[k]++}
     END {for (k in c) print c[k], k}' /var/log/nginx/access.log | sort -rn | head -10
输出里出现 GPTBot、ClaudeBot、CCBot、Bytespider 这类名字时,说明训练抓取已经开始。真正的判断依据是占比而不是名字:按每天三万次抓取、平均每次 128 KB 估算,一天就是约 3.7 GB,一个月超过 100 GB;如果站点图片没做压缩,这个数字还会翻倍。这个量级足以让共享主机上的站点触发流量告警,也足以让按月计费的独服(独立物理服务器)账单变得难看。
日志里的证据链:UA 可以伪造,来源要交叉验证
UA 字符串没有任何强制约束,一条 curl -A “GPTBot” 的请求就能把自己伪装成训练爬虫,反过来也一样,真实爬虫也可能借用通用 UA。所以仅凭 UA 做黑名单,既拦不准也容易误伤。比较稳妥的做法是同时核对三项信息:反向 DNS 解析出的域名、来源 IP 是否落在官方公布的地址段、以及请求节奏是否符合爬虫特征。
请求节奏是最容易观察的信号:真实用户会在页面停留几秒,抓取程序则并发、连续、不带 Referer 地扫全站。
awk '{print $(1)}' /var/log/nginx/access.log | sort | uniq -c | sort -rn | head -20
grep -c '\" 429 ' /var/log/nginx/access.log
grep -c '\" 403 ' /var/log/nginx/access.log
同一 IP 在几分钟内产生上千次请求,且几乎不带 Referer,这类流量无论 UA 写的是什么,都应该进入限速名单。反过来,如果某个 IP 每天固定只抓几十个页面、间隔均匀,多半是搜索引擎的常规收录,压得太狠会直接影响自然流量。
robots.txt 能声明什么,挡不住什么
robots.txt 在 2022 年被收录为 RFC 9309,定位是“请求你不要抓”,遵守与否由爬虫方决定。对合规的主流爬虫,它仍是最低成本、见效最快的声明方式,按用途分组写清楚比一句 Disallow: / 更有意义:
User-agent: *
Allow: /
Disallow: /search
Disallow: /*?s=

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
这里有几个容易搞混的点。Google-Extended 管的只是 Gemini 训练用途,不影响 Googlebot 的搜索收录;GPTBot 对应 OpenAI 的训练抓取,CCBot 对应 Common Crawl 的公开语料,两者被允许后会进入下游多个数据集,收紧这两个 token 的效果通常比封杀十几个小爬虫更明显。
另一个误区是把 robots.txt 当作访问控制,甚至让服务器对它返回 403,以为这样爬虫就读不到规则。协议里没有这层含义:4xx 状态会被解释为“没有任何限制”,等于给出最宽松的许可;只有 5xx 才被视为“暂时不可用”。真要拦截,必须落在 Web 服务器或应用层。
在 Nginx 层做 UA 配额:429 比 403 更合适
拦截放在 Nginx 最省资源,请求还没进 PHP 就被挡住。用 map 把训练爬虫标记出来,给它们单独的限速桶,普通用户走空 key、不计数:
map $http_user_agent $train_bot {
    default              "";
    "~*GPTBot"           $binary_remote_addr;
    "~*ClaudeBot"        $binary_remote_addr;
    "~*CCBot"            $binary_remote_addr;
    "~*Bytespider"       $binary_remote_addr;
}

limit_req_zone  $train_bot zone=trainbot:10m rate=20r/m;
limit_conn_zone $train_bot zone=trainconn:10m;

server {
    limit_req        zone=trainbot burst=10 nodelay;
    limit_req_status 429;
    limit_conn       trainconn 4;
    add_header       Retry-After 600 always;
}
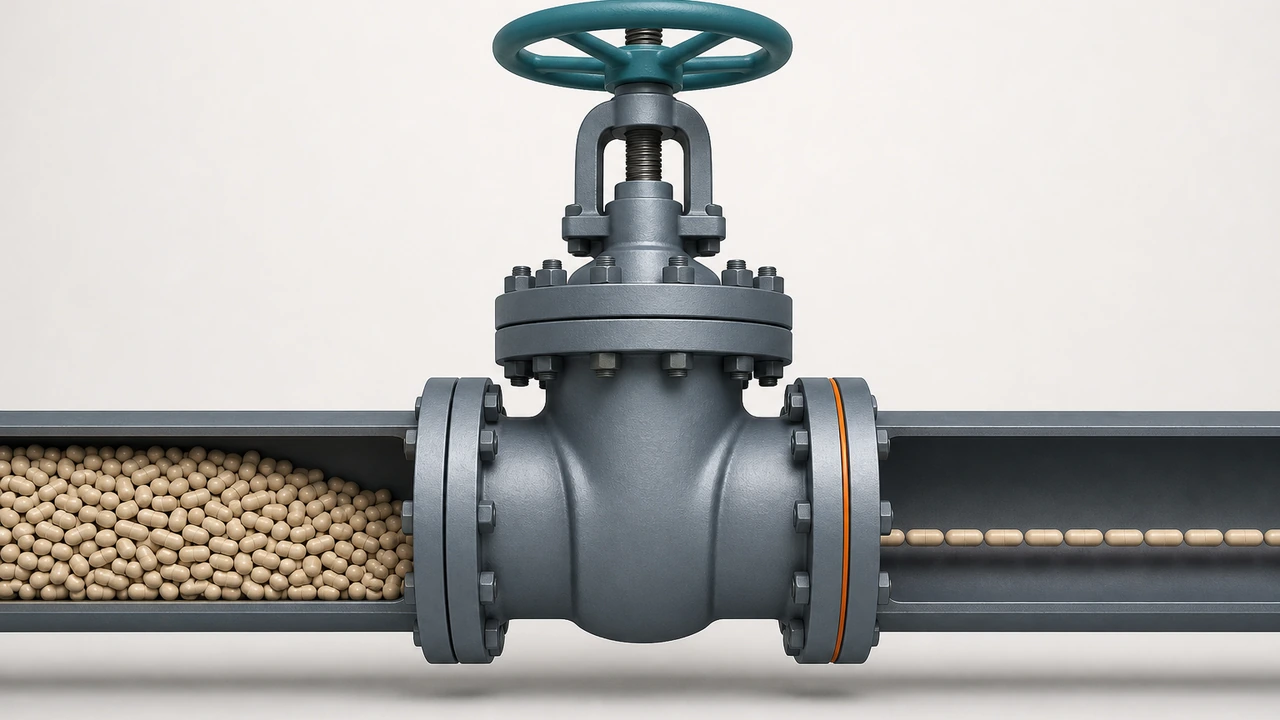
rate=20r/m 表示每个 IP 每分钟二十个请求,burst=10 允许十个瞬时突发。整站两万个页面按这个速率抓完一轮约需十七小时,对训练语料影响有限,对站点则是数量级的流量下降。搜索引擎蜘蛛不在名单里,收录节奏完全不受影响。
状态码要选对。返回 403 时,不少爬虫会持续重试,甚至轮换 IP 继续抓;返回 429 并附上 Retry-After,等于明确告诉对方“稍后再来”,合规爬虫通常会退避。注意 limit_req_status 的默认值是 503,必须显式改成 429,否则日志里会出现大量看起来像服务故障的记录。限速的更多写法可以参考站内的 Nginx 限速配置实践,如果站点前面还有一层反向代理,需要确认限速使用的是真实客户端地址而不是代理地址,相关配置见 Nginx 反向代理与负载均衡。
缓存与回源:把重复抓取的代价降下来
限速解决的是“抓得太快”,缓存解决的是“每抓一次都回源”。训练爬虫大部分请求不带 Cookie、也不看登录态,它们要的就是公开页面的完整 HTML,这类请求天然适合命中 CDN(内容分发网络,把静态内容缓存在离用户更近的边缘节点)或服务器本地的反向代理缓存。
先给静态资源一个长期缓存,再把 HTML 的缓存时间设成十分钟级别,既能吸收批量抓取,又不会让文章更新长期不生效:
location ~* \.(css|js|jpg|png|webp|woff2)$ {
    expires 180d;
    add_header Cache-Control "public, immutable";
}

location ~* \.html$ {
    expires 10m;
    add_header Cache-Control "public, max-age=600";
}
缓存是否生效,要看日志格式里的 $upstream_cache_status,统计 HIT 与 MISS 比例:
log_format  cache  '$remote_addr - $upstream_cache_status [$time_local] '
                    '"$request" $status $body_bytes_sent "$http_user_agent"';

awk '{print $(3)}' /var/log/nginx/access.log | sort | uniq -c | sort -rn
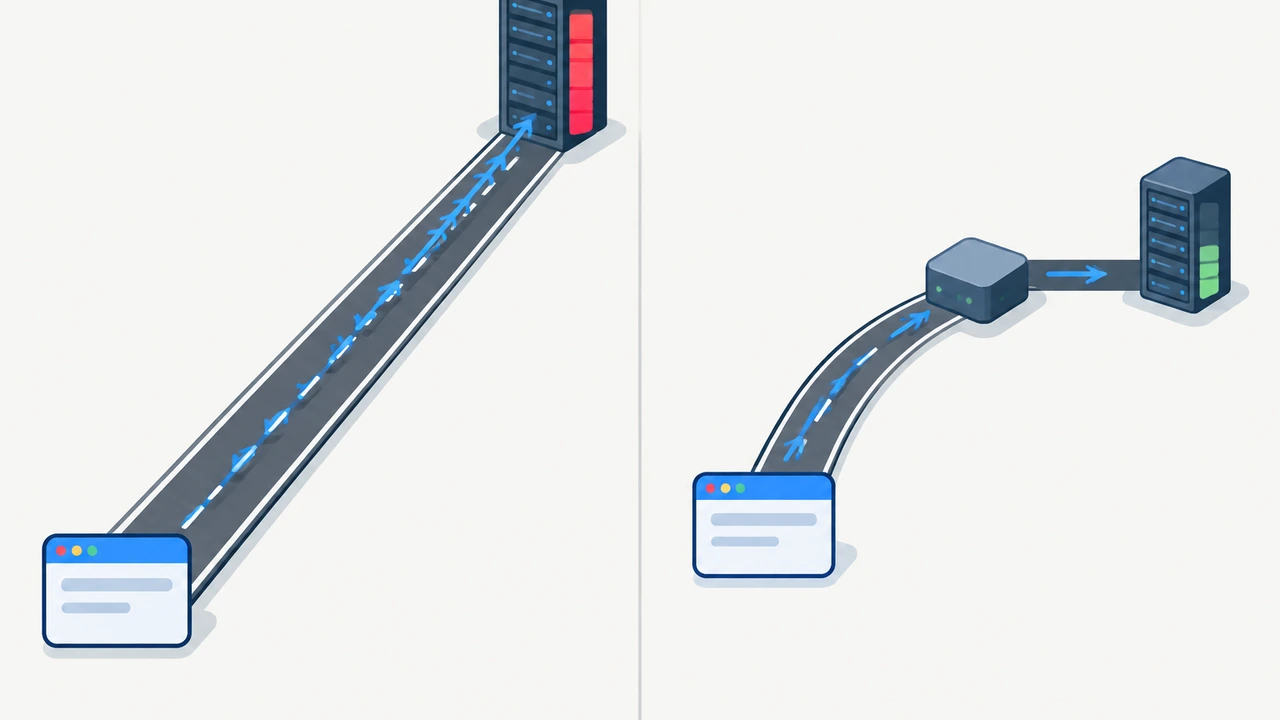
命中率从三成提到八成,意味着同样的抓取量下回源请求少了近七成,数据库和 PHP 进程的压力同步下降。什么时候该让 CDN 承担抓取、什么时候必须回源,站内这两篇讲得更细:重媒体场景下的 CDN 与源站分工、多层缓存架构的取舍。
治理效果的核对指标
改完配置别只看流量曲线,四个数字才能说明问题:
- 训练爬虫的字节占比:按 UA 汇总,多数内容站治理前在 25%–40% 之间,压到 10% 以下才算真正见效
- 429 比例:稳定在抓取总量的 5%–15% 说明限速规则命中了;接近零通常是 UA 匹配写错,超过一半则说明档位过严
- 缓存命中率与回源比:命中率提升后,TTFB(首字节时间)优化 里提到的 P95 指标应同步下降
- 搜索引擎蜘蛛的成功率:Googlebot、Bingbot 的 200 比例要保持在 99% 以上,低于这个数就是误伤
四个容易踩空的细节
- 反向 DNS 校验不要放在每个请求上:解析一次要几毫秒,只在限速触发后记录并核实
- 限速键要区分协议版本:$binary_remote_addr 对 IPv4 是 4 字节、IPv6 是 16 字节,10m 共享内存按十万级地址规划足够
- 日志也要轮转:7 天原始日志足够定位问题,未压缩的 access.log 单日就能涨到几百 MB
- 统计口径要覆盖所有域名:图片走独立域名时,这部分流量不会出现在主站日志里;跨区域访问还需要看 DNS(域名解析系统,把域名翻译成 IP 地址的服务)解析记录,相关做法见 跨境 DNS 优化
如果你的站点跑在独服(独立物理服务器)上,限速和缓存都由自己掌控,改完配置 reload 就能验证;如果是云服务器(可弹性伸缩的虚拟机实例),记得把带宽告警和抓取量统计一起看,突发流量的计费方式往往和固定带宽不同。在 Hostease 的 VPS(虚拟专用服务器)上,Nginx 的站点配置由 root 统一管理,上面这套 map、limit_req 和缓存规则可以直接写进 /etc/nginx/conf.d 下的站点文件,reload 之后立刻生效。
总结:把抓取治理变成每月一次的例行动作
抓取量治理不是一次性任务:模型在更新,爬虫在换 IP,UA 字符串随时会变,今天有效的黑名单三个月后大概率漏掉一半流量。省事的做法是把三件事固化成流程,每月跑一次按 UA 的字节汇总,每季度复核 robots.txt 补齐新出现的训练爬虫 token,每次调整档位后用 429 比例和搜索引擎成功率互相校验。
如果你需要一个明确的起点,建议先只做两件事:按 UA 汇总一次访问日志,算出训练爬虫的占比;再给这几个 UA 加上 20r/m 的限速桶。这两步不动架构、回滚成本几乎为零,却能把流量结构看清楚,也为后续要不要上 CDN、要不要调整主机规格提供依据。