早上网站突然集体变慢甚至打不开,登录后台一看 CPU 和内存都很空闲,但带宽监控曲线已经顶到了上限——这是最典型的”带宽打满”场景。而更让人头疼的是另一类问题:白天一切正常,每天固定在凌晨出现流量异常高峰,等你上班登录时痕迹已经过去。本文教你如何用 vnstat 和 nload 解决这类间歇性的凌晨流量异常:先用 vnstat 回看按小时的历史趋势,把异常起点精确锁定到具体时间窗,再用 nload 实时值守抓到流量的”现行”,最后结合连接数定位到具体进程和来源方向,帮助你把盲目重启式的排障变成有证据的闭环排查。
带宽打满时最先要做的事
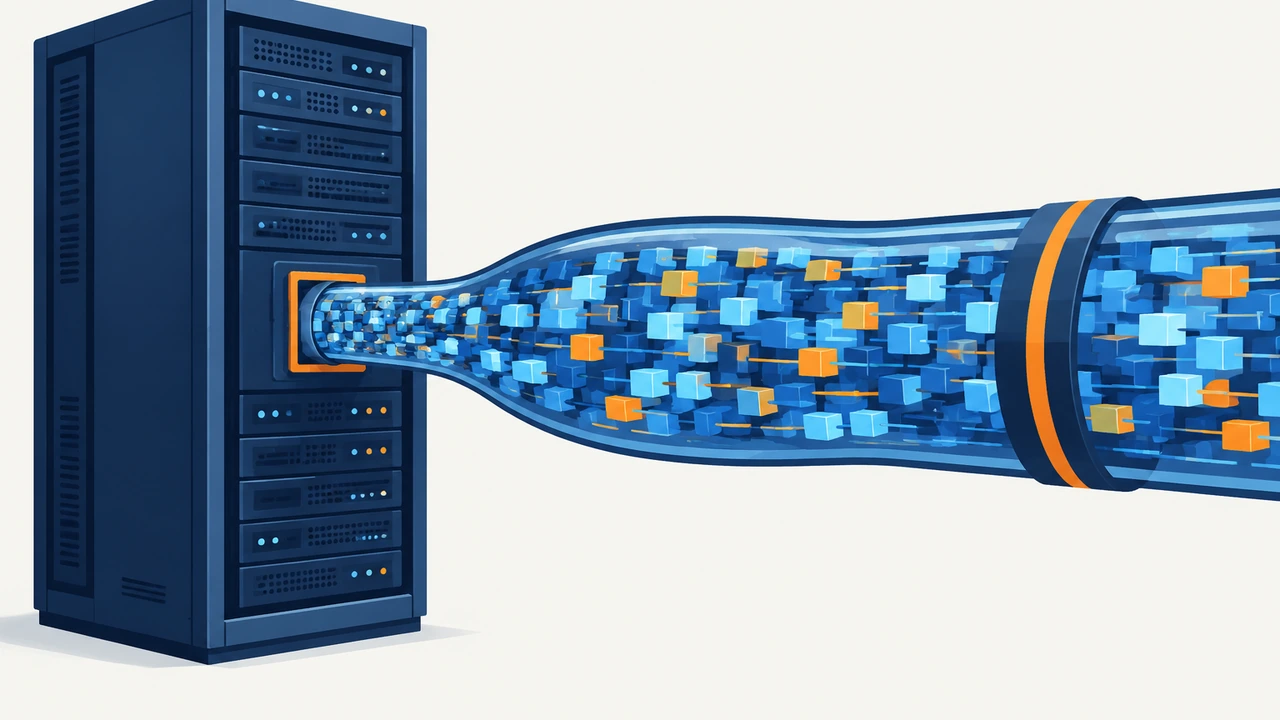
带宽和 CPU、内存不同,它是一个”出口总量”指标。服务器上任何一个进程向外发数据,都要经过网卡排队;当发送队列被塞满,所有请求的响应都会变慢——数据库慢查询、页面白屏、SSH 敲命令都卡,看起来像服务器整体故障,实际只是出方向的管道被占满了。
遇到这种情况,很多人的第一反应是重启服务器。重启确实能瞬间清空流量,但如果是被攻击或者程序失控,几分钟内带宽会再次被打满,问题只是被推迟了。核心结论是:先确认”什么时候开始异常”和”现在是谁在发流量”,再决定处置动作。
vnstat 和 nload 正好对应这两个问题。vnstat 负责回答”历史流量趋势如何”,它按天、按小时记录网卡进出流量,即使进程已经退出,历史记录仍然保留;nload 负责回答”此刻哪个网卡在跑流量、进和出各占多少”,实时刷新、一目了然。两个工具都很轻量,不会给已经高负载的服务器增加额外压力。
用 vnstat 回看流量历史,锁定异常时间窗
vnstat 的价值在于”事后回溯”,这也是它和实时监控工具最本质的区别。很多流量异常是间歇性的:凌晨三点被刷、某个定时任务周期性外发,等你收到告警登录时高峰可能已经过去。这时实时工具什么都看不到,只有历史数据能还原真相——而”异常发生在几点”这个信息,直接决定了你后续要在什么时间上线值守。
安装很简单:
# Debian / Ubuntu
apt install vnstat

# CentOS / AlmaLinux / Rocky Linux
yum install vnstat
安装后 vnstat 会以系统服务方式在后台持续记录。常用查看方式有三种:
vnstat                  # 按天汇总最近几天的进出流量
vnstat -h               # 按小时细分最近 24 小时
vnstat -d               # 按天细分每个自然日
重点看 vnstat -h 的输出。正常业务流量的曲线有明显规律:白天高、凌晨低,出方向(out)和入方向(in)比例稳定。如果某天凌晨两三点突然出现一根”流量柱”,出方向是平时同时段的几十倍,那异常起点就锁定在这个时间窗。某外贸站长就遇到过这种情况:网站每天凌晨卡顿半小时,用 vnstat -h 对比三天数据后发现,异常时段的出方向流量从平时的 2GB 飙到 40GB,进一步排查确认是一个被入侵的定时任务在向外部地址批量外发数据。
如果服务器有多块网卡(比如公网网卡加内网网卡),用 vnstat --iflist 先列出网卡,再用 vnstat -i eth0 -h 指定查看,避免把内网备份流量误判成公网异常。
历史趋势确认后,下一步就是按锁定的时间窗抓”现行”——这正好是 nload 的用武之地。
用 nload 在异常时段实时值守,抓住流量现行
nload 解决的是”此刻谁在跑流量”的问题。和 vnstat 的事后回溯互补,nload 提供的是实时画面:它实时绘制每块网卡的进、出流量曲线,并给出当前速率、平均速率、最小值、最大值四组数字,视觉上一眼就能看出流量方向。实战中的做法是:在 vnstat 锁定的异常时段(比如凌晨两点到三点)提前挂上 nload,异常一出现就能当场看到。
安装后直接运行:
# Debian / Ubuntu
apt install nload

# CentOS / AlmaLinux / Rocky Linux
yum install nload
nload            # 监控默认网卡
nload eth0       # 指定网卡
界面分上下两栏:上栏是入方向(Incoming),下栏是出方向(Outgoing)。排查带宽打满时,重点看出方向的 Curr(当前速率)是否顶到了套餐带宽上限。比如一台 30Mbps 带宽的服务器,出方向 Curr 长期停在 29Mbps 以上,就说明出方向被打满;用左右方向键可以切换网卡,逐块确认是公网口还是内网口在跑量。
在 nload 里还应该关注两个细节。第一是流量的持续性:正常业务的高峰是有波动的,用户访问是脉冲式的;如果出方向曲线是一条持续不变的直线,不随昼夜变化,大概率不是真实用户在产生流量,而是某个程序在持续外发,或者是攻击流量。第二是入方向和出方向的比例:正常 Web 服务的出方向是入方向的数倍(返回页面给用户),如果反过来入方向远大于出方向,则要考虑是不是正在被大流量请求打进来,比如被恶意抓取或 DDoS(分布式拒绝服务攻击)。
从网卡到进程:定位流量的最终来源
nload 告诉你”哪块网卡在跑流量”,但还差最后一步:确认是哪个进程在发。这一步用系统自带的工具就够:
# 找出连接数最多的进程,按连接数排序
ss -antp | awk '{print $6}' | sort | uniq -c | sort -rn | head

# 实时观察各进程的网络吞吐
iftop -i eth0 -nP
ss 命令的输出能直接看到进程名和 PID。常见几种结论对应不同处理方式:如果异常连接全部指向同一个外部 IP 段且状态为 ESTABLISHED,用防火墙直接封禁该网段;如果进程是 Web 服务本身,检查访问日志里是否有同一 IP 的高频请求,判断是否被恶意爬取;如果是一个你完全不认识的进程,先 kill 停掉,再用 crontab -l 和 systemctl list-timers 检查有没有被植入的定时任务,防止它自动重启卷土重来。之前我们写过一篇服务器入侵检测基线排查,里面 AIDE 比对文件完整性的思路,正好可以用来确认这类可疑进程对应的文件有没有被篡改。
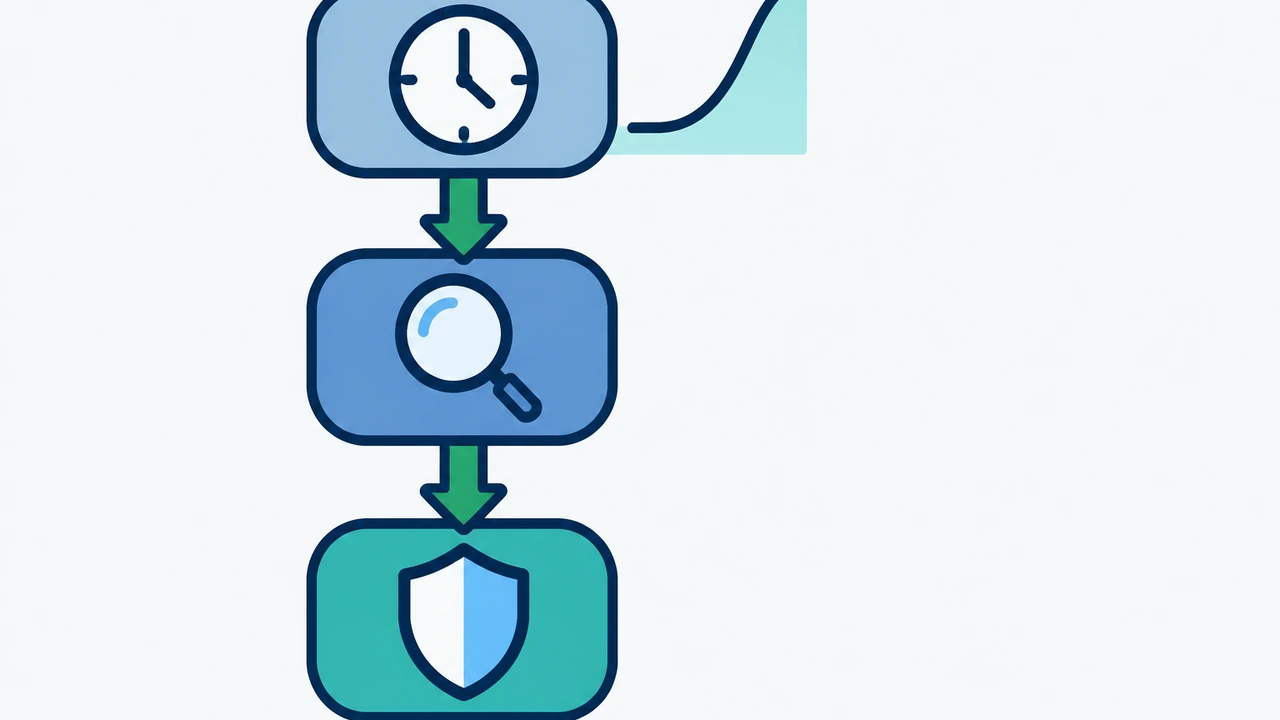
处理完成后回到 vnstat 验证效果:次日再看 vnstat -h,如果异常时段的流量柱恢复到正常水平,说明根因已经解决;如果还在,说明处置只挡住了表象,需要回到进程层继续排查。这个”历史锁窗 → 定时值守抓现行 → 进程定位 → 事后验证”的闭环,比单纯重启服务器可靠得多——尤其是凌晨才发作的间歇性异常,没有 vnstat 的历史数据,你连该几点起来值守都不知道。
总结与下一步建议
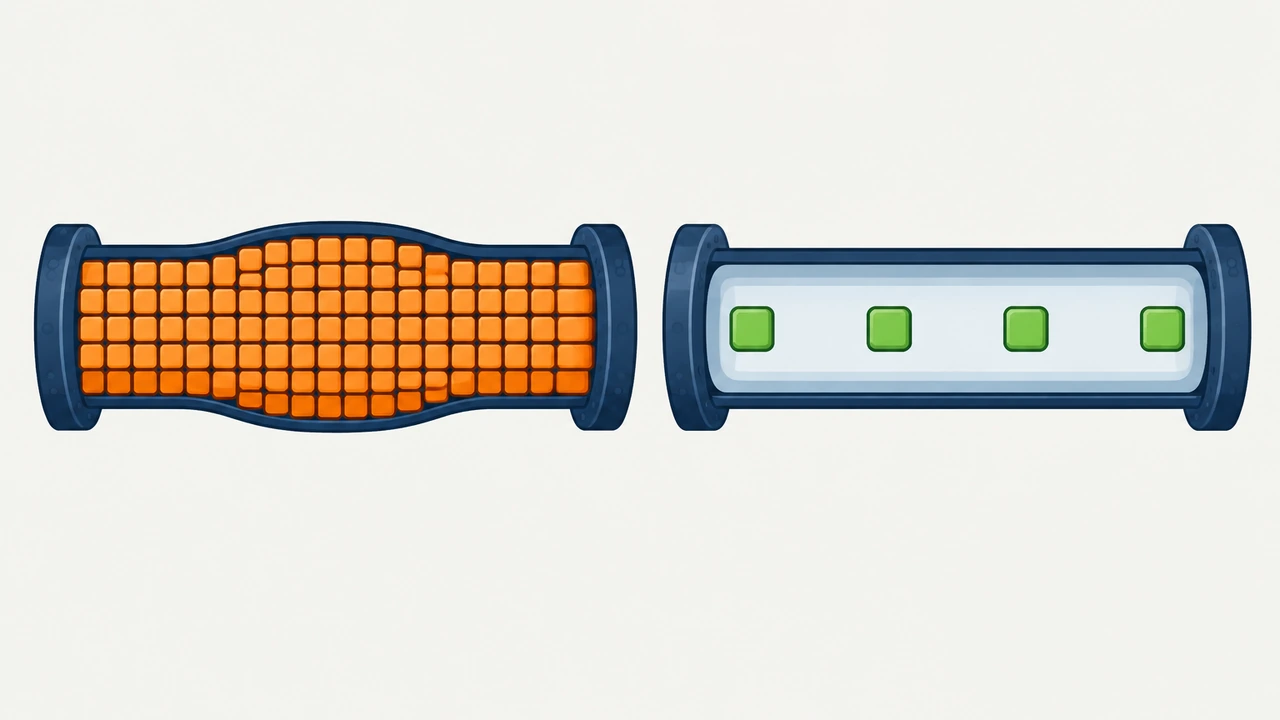
带宽打满的排查并不需要复杂的监控体系,vnstat 和 nload 这两个几 MB 的小工具,配合系统自带的 ss 和访问日志,就能覆盖”异常发生在几点、现在谁在发、最后怎么处理”的完整链路。建议你现在就在服务器上把 vnstat 装好——它的历史记录是从安装那一刻开始积累的,等出问题再装,前面的数据就永远补不回来了。
如果你需要一台带宽充足、且提供流量监控面板的主机环境来减少这类排查,可以考虑 Hostease 的独立服务器,独享带宽配合实时流量图表,异常流量在控制台就能直接看到。关于服务器性能排查的其他专题,可以延伸阅读服务器栏目里的磁盘 IO 与 CPU 负载系列教程;如果你的业务跑在 VPS 主机(虚拟专用服务器)上,同样适用本文的排查方法,遇到持续被打满且无法定位来源的情况,建议及时联系主机商协助从上层网络封堵。