网站访问量没有明显增长,CPU 占用和流量却一路飙升,访问日志里塞满了各种奇怪的 User-Agent?这多半是恶意爬虫在作怪。本文教你如何用 Nginx 自带的 User-Agent 规则和频率限制(limit_req)功能,把恶意爬虫挡在门外,同时不影响搜索引擎的正常收录。全文包含可以直接复制的配置示例、验证命令和常见误区排查,十分钟左右就能为你的站点加上一道实用的防线。无论网站跑在虚拟主机还是独立服务器上,这套思路都适用。
恶意爬虫到底带来哪些问题
爬虫本身是中立的:搜索引擎靠它发现新页面,监控服务靠它检测可用性。真正需要防范的是那些不遵守 robots.txt、高强度抓取、只为采集内容或寻找漏洞的恶意爬虫。它们的危害通常体现在三个方面。
一是资源消耗。一个典型的外贸企业站,正常用户每分钟只会产生几十个请求,而我们见过不少案例,单个恶意 IP 每秒能打出 20 个以上请求,一台小型 VPS(虚拟专用服务器)的连接数和带宽(服务器对外的数据传输能力)很容易就这样被吃光,直接拖慢真实用户的加载速度。
二是内容风险。恶意爬虫往往以采集为目的,整站镜像你的原创文章,不仅稀释原创权益,还可能让搜索引擎判定你的站点是”复制方”,反过来影响排名。
三是安全探测。很多爬虫会自动扫描 wp-login.php、.env、备份文件等敏感路径,为后续攻击踩点。如果你想系统地了解服务器层面的排查思路,可以参考我们整理的服务器配置与优化专题。
下面两个步骤,就是针对这三类问题的直接应对。
第一步:用 User-Agent 规则拦截已知恶意爬虫
大部分恶意爬虫懒得伪装,User-Agent 里会直接暴露身份,例如 SEO 工具型爬虫(SemrushBot、AhrefsBot、MJ12bot)、通用脚本库(python-requests、Scrapy、Go-http-client)。对于明确不需要的爬虫,用 Nginx 的 map 指令集中定义黑名单,是最干净的做法:
# 放在 http {} 层,与 server {} 平级
map $http_user_agent $bad_bot {
    default           0;
    ~*SemrushBot      1;
    ~*AhrefsBot       1;
    ~*MJ12bot         1;
    ~*DotBot          1;
    ~*python-requests 1;
    ~*Scrapy          1;
    ~*Go-http-client  1;
    ~*sqlite          1;
}

# 放在 server {} 或 location {} 内
if ($bad_bot) {
    return 403;
}
几点说明:~* 表示不区分大小写的正则匹配;map 只能在 http 层定义,但可以在多个 server 中复用变量,便于多站点统一维护。返回码推荐用 403;如果确认这些请求毫无价值,也可以用 Nginx 特有的 return 444,它会直接关闭连接、不返回任何内容,比 403 更省资源。默认的 default 0 意味着”白名单优先”:没有命中黑名单的请求一律放行,这样规则扩容时不容易误伤正常流量。
哪些 UA 该拦、哪些不该拦,可以先看数据再动手。下面这条命令统计最近 10000 行日志中出现频率最高的 User-Agent:
tail -n 10000 /var/log/nginx/access.log \
  | awk -F'"' '{print $6}' | sort | uniq -c | sort -rn | head -20
经验上,某个 UA 的请求占比超过 20%、且来源 IP 高度分散时,基本可以判定为采集行为;而 Googlebot、Bingbot 这类搜索引擎爬虫,即使抓取量大也应保留——它们带来的是收录和流量。如果不确定某个 UA 是否属于搜索引擎,可以用反向 DNS 验证来源 IP 是否真的属于官方网段,避免爬虫伪装成搜索引擎身份绕过规则。
第二步:用 limit_req 控制请求频率
User-Agent 黑名单解决的是”已知敌人”,但更隐蔽的恶意爬虫会使用随机 UA 甚至真实浏览器 UA。这时候频率限制(rate limiting)就是更可靠的防线:不管对方自称是谁,请求超过正常人类的浏览速度,就限流。
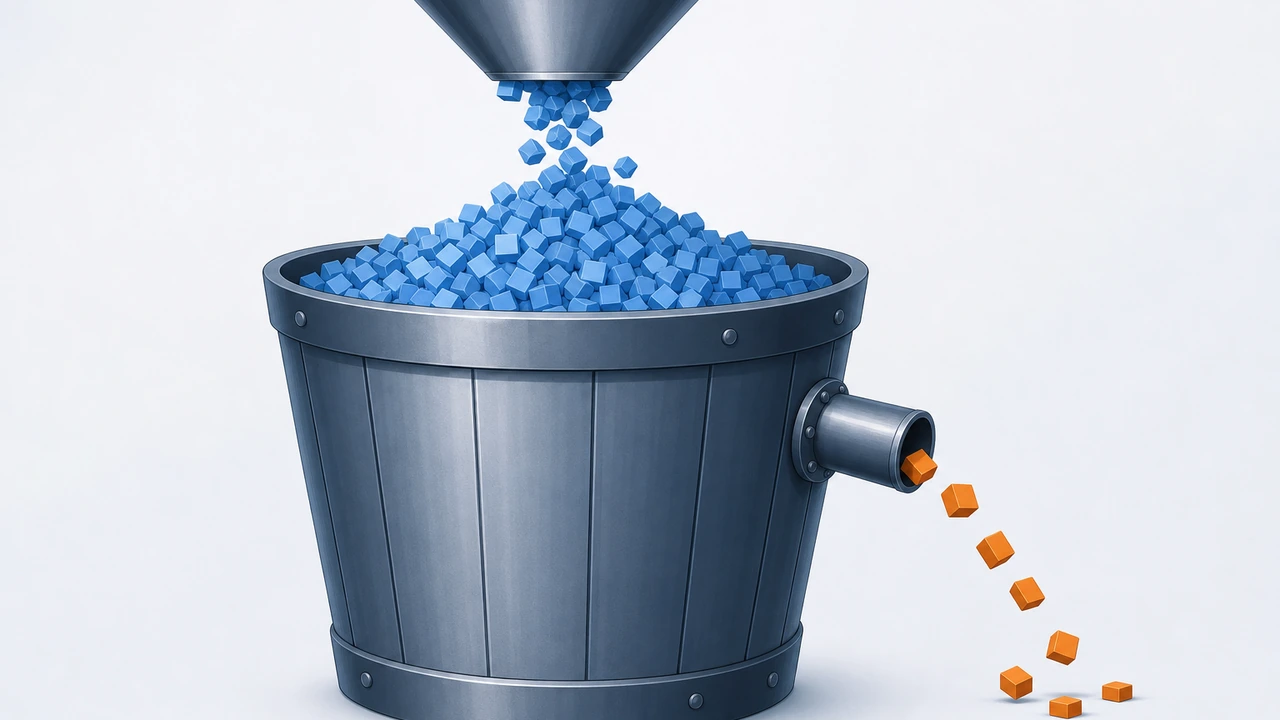
Nginx 通过 limit_req_zone 和 limit_req 两条指令实现漏桶算法限流:
# http {} 层:定义限流区域
# $binary_remote_addr:按客户端 IP 限流(比字符串形式的 $remote_addr 更省内存)
# zone=one:10m:分配 10MB 共享内存,约可跟踪 16 万个 IP
# rate=2r/s:允许每个 IP 每秒 2 个请求
limit_req_zone $binary_remote_addr zone=one:10m rate=2r/s;

# server {} 或 location {} 内:应用限流
location / {
    limit_req zone=one burst=5 nodelay;
    # burst=5:允许瞬时突发 5 个排队请求
    # nodelay:突发请求立即处理,不强制间隔
    limit_req_status 429;
}
参数怎么选?我们建议的基准是:内容页 rate=2r/s 起步,配合 burst=5,足以覆盖真人快速点击页面的场景;登录页、搜索接口这类容易被脚本瞄准的位置,可以单独设置更严格的区域,例如 rate=1r/s。设好后用 nginx -t 检查语法、nginx -s reload 平滑重载,再用 ab -n 20 -c 5 https://yourdomain.com/ 之类的压测工具验证 429 状态码是否如期返回。
对大多数中小站点而言,一台配置合理的 Hostease VPS 跑这套配置绰绰有余;如果流量进一步增长,再把限流阈值和 burst 值按实际监控数据上调即可。
两种手段如何配合:先精准拦截,再兜底限流
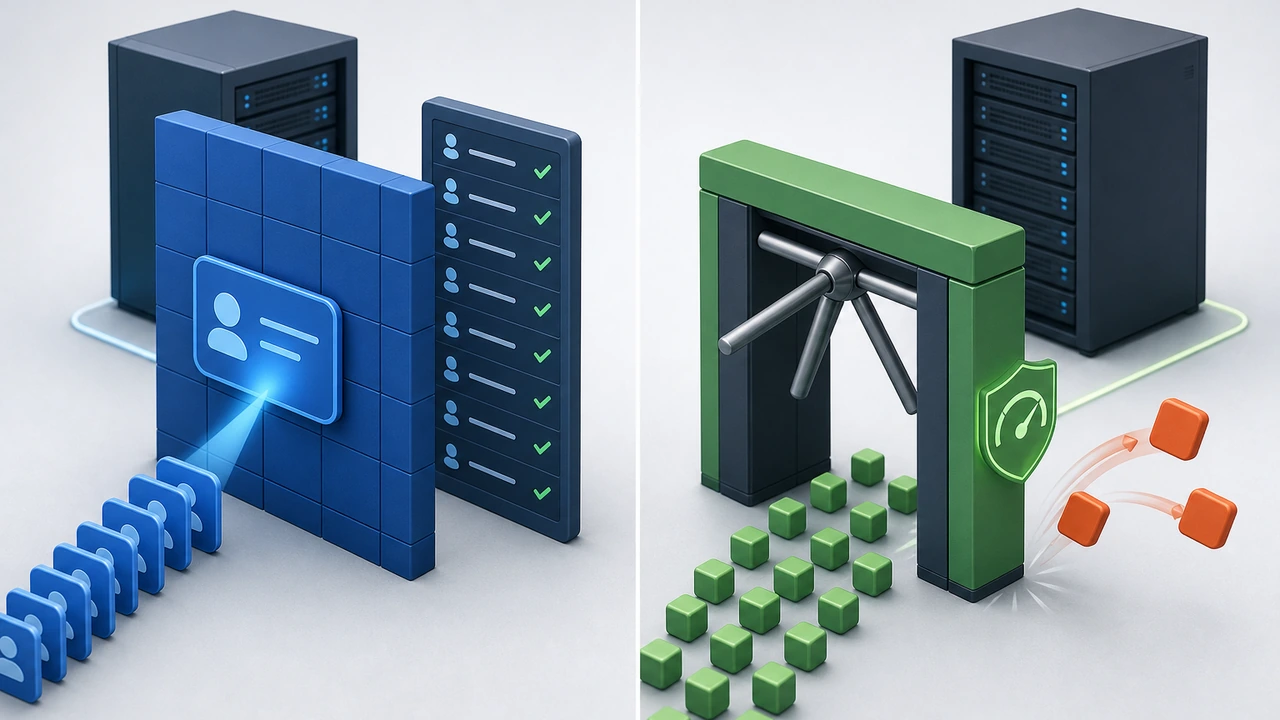
User-Agent 拦截和频率限制不是二选一,而是分工明确的两道闸门。用一张对比表说清它们的差异:
| 维度 | User-Agent 黑名单 | limit_req 频率限制 |
|---|---|---|
| 拦截对象 | 已知恶意爬虫身份 | 超速的任何请求 |
| 误伤风险 | 较低(按身份精准匹配) | 中等(真人高频操作也会触发) |
| 维护成本 | 需定期更新 UA 列表 | 一次配置长期有效 |
| 防伪造能力 | 弱(UA 可随意伪装) | 强(不看身份只看行为) |
| 适用位置 | server 层全局拦截 | location 层按路径精细控制 |
落地时建议按”先精准、后兜底”的顺序组合:先用 map 黑名单清掉那些不需要谈判的爬虫,再对剩余流量套上频率限制。举个例子,某站点上线限流后观察到,每天仍有约 3% 的请求被 429 拒绝,其中绝大多数来自采集脚本;而正常用户的请求因为 burst 缓冲的存在几乎不受影响——这就是两道闸门各司其职的理想状态。
需要注意验证方式:User-Agent 规则生效时日志里出现的是 403,频率限制触发时是 429。上线后各观察一到两天,如果 403 或 429 占比异常偏高,优先检查规则是否写得太宽,而不是直接调大阈值。
常见误区与排查方法
配置上线只是第一步,真正的坑往往在细节里。根据我们处理客户工单的经验,以下三类问题最常见。
第一类是误伤搜索引擎。有站长把 Googlebot 一并写进黑名单(本意是拦一个假冒的采集器),结果三天内收录量掉了四成。排查方法是查日志中 403 记录的来源 IP,并做反向 DNS 验证;确认误伤后立即从 map 中移除对应条目并 reload。
第二类是限流过紧导致页面资源加载失败。一个页面通常要并行请求 CSS、JS 和图片,如果对全部路径一刀切 rate=1r/s 且不给 burst,静态资源就会批量 429。解决办法是把静态资源单独放行到一个更宽松的 location 块,或者只对 HTML 页面套严格限流:
# 静态资源:宽松限流,避免页面加载被误杀
location ~* \.(css|js|jpg|png|webp|svg)$ {
    limit_req zone=one burst=20 nodelay;
}

# 动态页面:严格限流
location / {
    limit_req zone=one burst=5 nodelay;
}
第三类是改了配置却不生效。九成原因是忘了 nginx -t 验证后执行 nginx -s reload,或者改的是另一个 server 块(站点有多个配置文件时尤其常见)。可以用 nginx -T | grep -A3 limit_req 确认当前实际加载的配置内容。如果你在用 CDN(内容分发网络),还要注意:限流看到的是 CDN 节点 IP 而非真实访客 IP,可以在 Nginx 中配置 real_ip 模块还原真实来源(原理是把请求头里的真实 IP 写回 Nginx 的来源地址变量),否则限流会”一误伤全站”。
每改一处配置,都先在测试环境或低峰期验证,再推广到生产,这个习惯能帮你避开绝大部分事故。
总结与行动建议
回顾一下整套防线的搭建逻辑:先用 User-Agent 黑名单精准拦截已知恶意爬虫(403),再用 limit_req 频率限制兜底拦下超速请求(429),最后通过日志中的状态码占比持续验证规则是否恰当。两道闸门配合,既不动用任何付费插件,也不需要改动应用代码,标准 Nginx 就能完成。
如果你正准备动手,建议按这个顺序推进:先备份当前 nginx.conf,再逐段添加上文配置,每次修改后执行 nginx -t 验证并 reload;上线后连续观察三天的 403/429 占比,把误伤条目清出去,把明显漏掉的采集 UA 补进黑名单。整个过程通常不超过半小时。
如果你需要一台稳定的服务器来承载这套配置,可以考虑 Hostease 的 WordPress 主机 或 虚拟主机 方案,配套的技术支持可以协助排查限流规则的误伤问题;关于页面加载速度这类配套优化,也可以延伸阅读我们的网站性能优化指南。防爬虫是持续运营的功课,先把基础配置做扎实,再按流量变化逐步加码,你的站点就能在采集潮中稳住性能和排名。