一次大促开始 10 分钟后数据库 CPU 被打满,业务却几乎没有真实流量增长——这是很多团队第一次真正见识缓存失效的破坏力:本来由 Redis(一种基于内存的键值缓存数据库)扛住的查询,因为一批缓存键同时失效或被恶意请求绕过,瞬间全部压回数据库。要解决”如何让缓存层在异常流量下依然稳得住”这个问题,需要先分清穿透和雪崩这两种故障形态。
本文会带你逐一处理三类问题:先讲清缓存穿透(查询根本不存在的数据,请求绕过缓存直打数据库)的识别与拦截,再讲缓存雪崩(大量缓存键同一时间失效,请求集中回源)的预防设计,最后给出一套热点数据的缓存策略组合,包含可以直接落地的配置和代码。
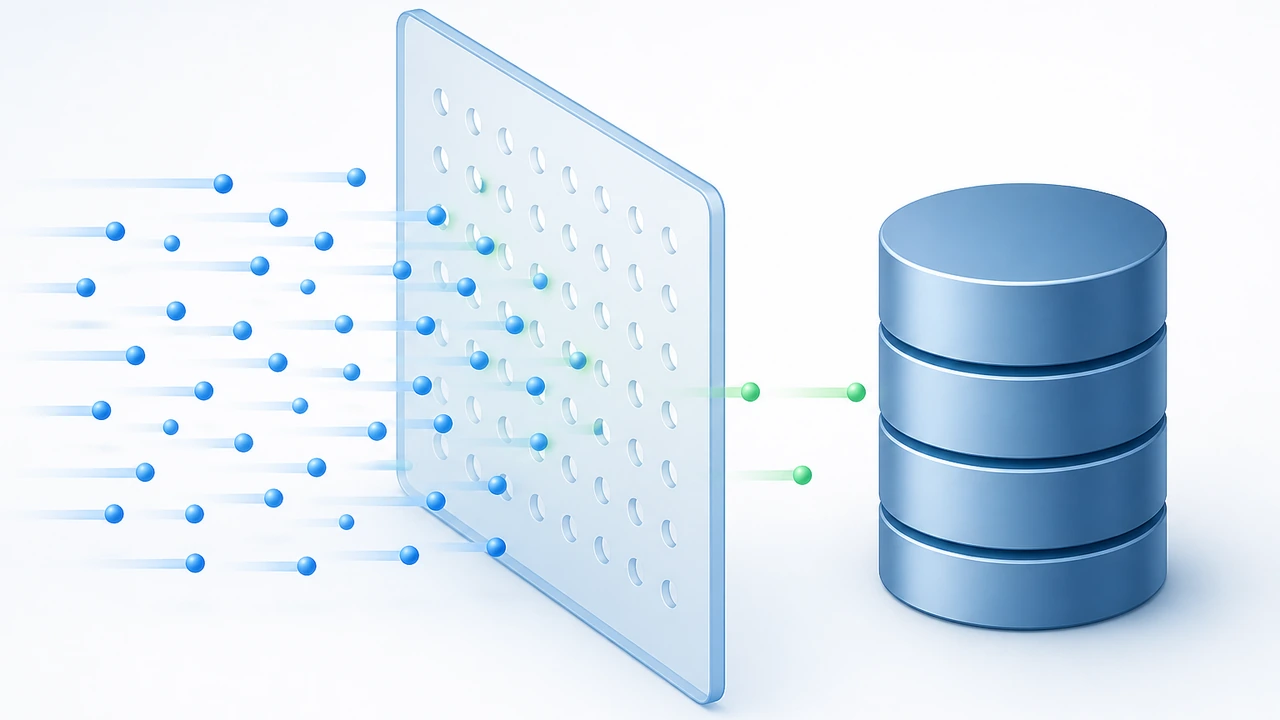
分清两种故障:穿透和雪崩不是一回事
这两种故障经常被混为一谈,但成因和防护手段完全不同。缓存穿透的典型场景是:攻击者伪造大量数据库里根本不存在的 ID 反复请求,比如用随机数去查 user?id=999999999。这些键在缓存里永远不会有值,于是每一次请求都穿透缓存层直接砸到数据库——单个请求无害,放大到每秒上万次就是灾难。
缓存雪崩则相反:问题不出在”不存在的键”,而出在”存在的键同时消失”。最常见的诱因是给整批缓存键设置了完全相同的过期时间,比如凌晨统一写入了 8 小时 TTL(Time To Live,缓存键的存活时长)的缓存,8 小时后这批键在同一秒内集体过期,所有流量同时涌向数据库。缓存实例宕机也会触发同类效应。
两种形态有一个直观的对比:穿透是”少数恶意流量持续直穿”,雪崩是”正常流量在某一个时间点集中回源”。下面的示意图可以帮你快速建立直觉:
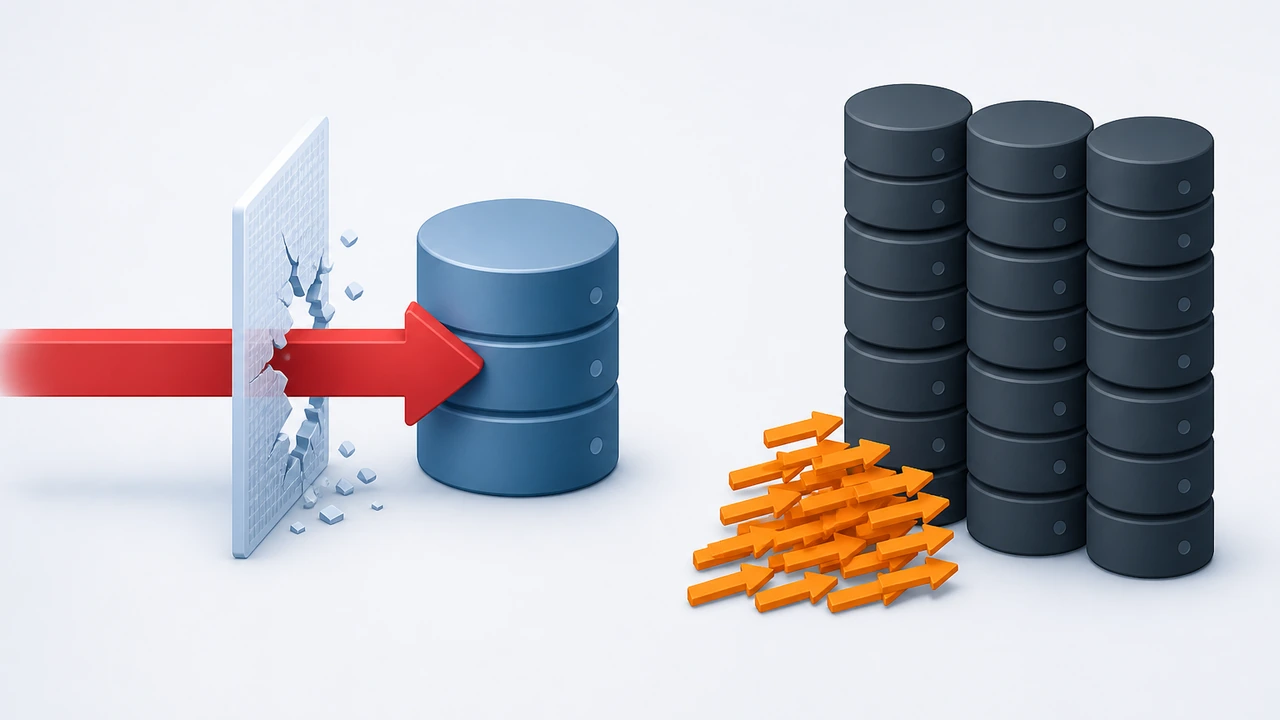
区分清楚这一点很重要,因为防护策略完全是两套思路:穿透要在”请求进入数据库之前”做拦截,雪崩要在”缓存键的失效时间分布”上做文章。
穿透防护:校验、空值缓存、布隆过滤器三层组合
识别穿透并不难:观察数据库的慢查询日志,如果大量查询的 ID 在业务表里根本不存在,或者同一类无效参数每秒出现几十次,基本可以断定正在被穿透。防护的核心思路是让无效请求在到达数据库之前就被拦下来,实际落地通常三层配合。
第一层是参数校验,成本最低。ID 类参数先验证格式,比如用户 ID 必须是正整数且不超过已有最大值,格式都不对的请求直接返回,连缓存都不用查。这一层能挡掉大部分粗糙的攻击脚本,代价只是几行代码。
第二层是空值缓存,解决”格式合法但数据不存在”的请求。查询数据库确认不存在后,把空结果也写入缓存,并给一个较短的 TTL,这样同一个无效键的后续请求会被缓存直接消化:
def get_user(user_id):
    key = f"user:{user_id}"
    val = redis.get(key)
    if val is not None:
        return None if val == "" else deserialize(val)  # 空字符串代表已确认不存在
    user = db.query_user(user_id)
    if user is None:
        redis.set(key, "", ex=60)   # 空值缓存 60 秒,防止反复回源
        return None
    redis.set(key, serialize(user), ex=3600)
    return user
第三层是布隆过滤器(一种用极小内存判断”键是否可能存在”的概率结构),适合键空间巨大且无效请求占比高的场景。把全部合法 ID 预先写入过滤器,请求先问过滤器:如果回答”不存在”,直接拒绝;如果回答”可能存在”,再走正常查询。布隆过滤器有极低的误判率,但”不存在”的判断是绝对可靠的,所以拦截无效流量的效果是确定的。一亿个键的过滤器通常只需要一两百 MB 内存,成本远低于被打穿的数据库。
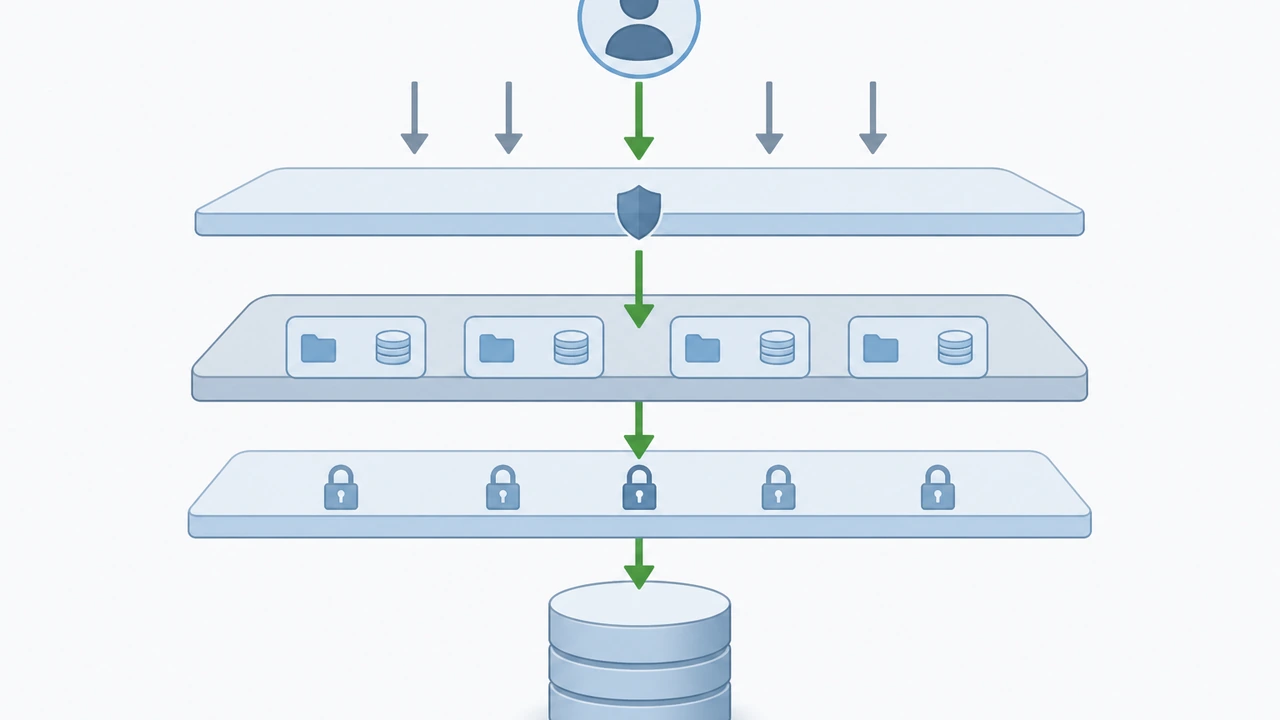
三层不必同时上马:小规模系统用校验加空值缓存通常就够了;只有当无效流量规模明显、或者键空间大到空值缓存也存不过来时,才值得引入布隆过滤器。
雪崩防护:把过期时间打散,把回源并发压低
理解了雪崩的成因是”同时失效”,防护思路就清楚了:让失效时间尽量分散,让回源过程尽量温和。
最有效的一招是过期时间加随机偏移。不要给同一批键写死相同的 TTL,而是在基础时长上叠加一个随机量,让失效点在时间轴上摊开:
import random

def cache_with_jitter(key, value, base_ttl=3600):
    ttl = base_ttl + random.randint(0, 600)  # 在基础 1 小时上随机加 0-10 分钟
    redis.set(key, value, ex=ttl)
只改这一行,原来”整点集体过期”的缓存键就会分布在 60-70 分钟的区间里陆续失效,数据库承受的回源压力从瞬时尖峰变成平缓的背景流量。我们建议把随机偏移量控制在基础 TTL 的 10% 左右:太小起不到打散作用,太大则可能让部分数据陈旧时间超出业务容忍度。
第二招是互斥锁,防止”一个热点键失效,成百上千个请求同时回源重建”。键失效时只允许一个请求去查数据库并回写缓存,其余请求短暂等待后重新读缓存:
def get_hot(key, rebuild_fn, lock_ttl=10):
    val = redis.get(key)
    if val is not None:
        return deserialize(val)
    lock = redis.set(f"lock:{key}", 1, nx=True, ex=lock_ttl)  # 只有拿到锁的请求回源
    if lock:
        data = rebuild_fn()
        redis.set(key, serialize(data), ex=3600 + random.randint(0, 300))
        redis.delete(f"lock:{key}")
        return data
    time.sleep(0.05)
    return get_hot(key, rebuild_fn)  # 没拿到锁的请求稍后重试读缓存
第三招是缓存高可用与降级预案。雪崩最坏的情形是缓存实例整体不可用,因此生产环境至少要部署主从加自动故障转移;同时给数据库侧准备限流兜底——即便缓存完全失效,数据库也只接收自己扛得住的并发量,宁可部分请求排队,也不能让数据库被压垮后全站不可用。限流与告警的具体联动做法,可以参考这篇 Nginx 限流与 CC 攻击防护实践。
热点数据的策略组合与监控指标
前面的手段解决了”不被打穿”,热点数据还要解决”一直有得用”。一个经过多个项目验证的组合策略是这样的:核心热点键(首页、爆款商品、配置项)设置永不过期或超长 TTL,由后台任务定时主动刷新,彻底回避”失效瞬间”这个风险点;普通数据用随机化 TTL 加互斥锁兜底;边缘静态内容则交给多层缓存,把响应速度再往上抬一档。多级缓存(本地进程缓存 + Redis + CDN(内容分发网络,把静态资源缓存到离用户更近的节点))的架构设计,我们在多层缓存架构实践里有完整的展开。
策略上线后必须用指标验证效果,重点关注三个数字:
- 缓存命中率:健康业务通常应保持在 90% 以上,跌破 80% 说明失效策略或键设计有问题
- 数据库 QPS 曲线:观察是否存在与缓存过期周期同步的规律性尖峰,有尖峰就是雪崩前兆
- 慢查询中无效键占比:占比上升是穿透攻击最直接的信号
命中率突然下跌配合数据库 QPS 跳升,基本可以立刻定位为雪崩事件;慢查询里出现大量不存在的 ID,则指向穿透。这两个信号建议接入告警,触发阈值不用复杂:命中率环比下降 10 个百分点、或数据库 QPS 超过日常峰值 2 倍时通知值班即可。Redis 数据的持久化与恢复能力同样要纳入检查,具体操作见 Redis 持久化与数据恢复实践。
总结:一套可以直接落地的防护清单
回到开头的问题:如何让缓存层在异常流量下依然稳得住?核心结论是按故障形态对症下药——穿透靠”进库前拦截”(参数校验、空值缓存、布隆过滤器),雪崩靠”失效时间打散”(随机 TTL、互斥锁、高可用兜底),热点数据靠”主动刷新 + 多级缓存”保持常热。
如果你需要把这套方案落到自己的系统,建议按这个顺序动手:先检查现有缓存键是否存在统一 TTL 的雪崩隐患,今天就可以加上随机偏移;本周内给空值查询补上短 TTL 空值缓存;再把命中率和数据库 QPS 的告警接进值班群。之后随着流量增长,再评估是否需要布隆过滤器和多级缓存。对于正在规划服务器部署的团队,Hostease 的云服务器(由云平台提供的弹性虚拟主机)支持独立内存与自定义环境,可以直接承载自建 Redis 集群,配合服务器运维专栏里的缓存与数据库实践文章,把数据层的稳定性系统地做扎实。