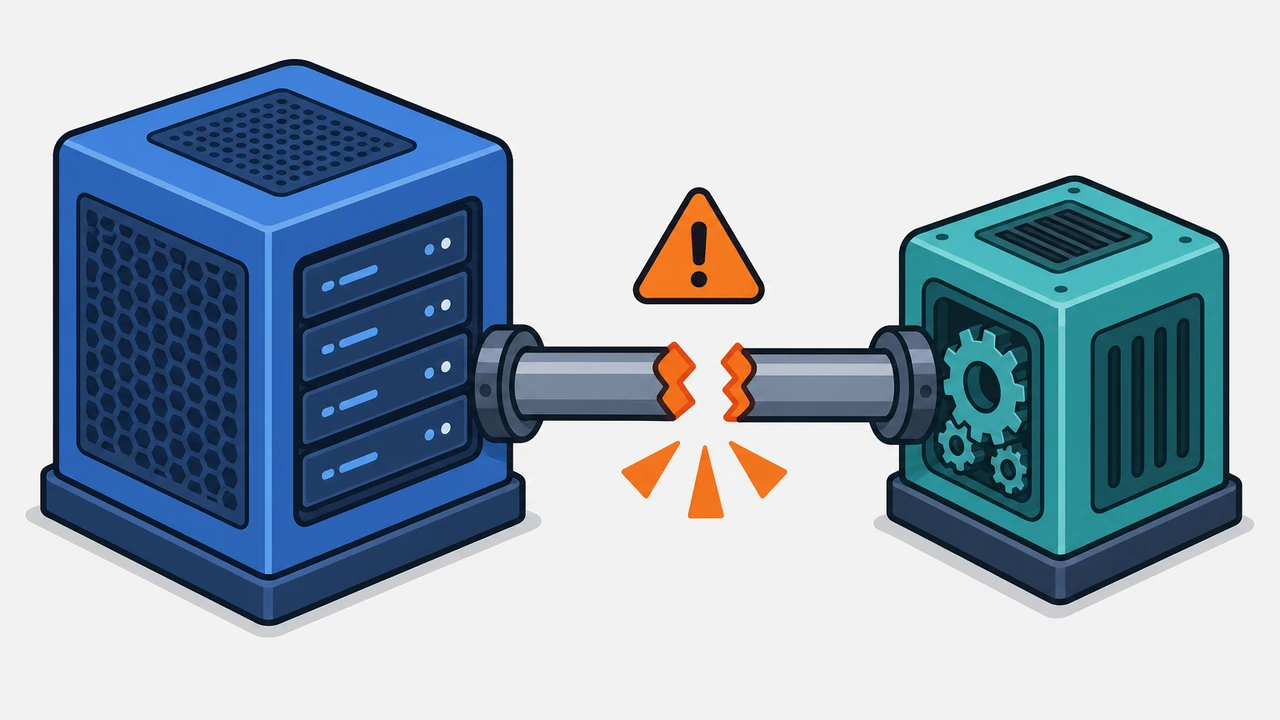
WordPress 搬家刚结束,域名解析已经切换,你打开网站准备确认成果,迎面而来的却是一行冷冰冰的 502 Bad Gateway。这大概是迁移之后最让人崩溃的时刻:数据明明都在,后台也许还能登录,前台却完全打不开。这篇文章会帮助你解决这个问题的全链路:从 Nginx 错误日志入手,分清 upstream 超时与连接失败两种完全不同的故障,再一步步完成 PHP-FPM 进程池调优与 Nginx 超时配置,最后核对搬家场景里最容易漏掉的数据库与缓存检查点。无论你是把站点从旧虚拟主机迁到 VPS(虚拟专用服务器),还是在两台独立服务器之间迁移,这套排查路径都同样适用。
502 的本质:Nginx 与 PHP-FPM 的通信断裂
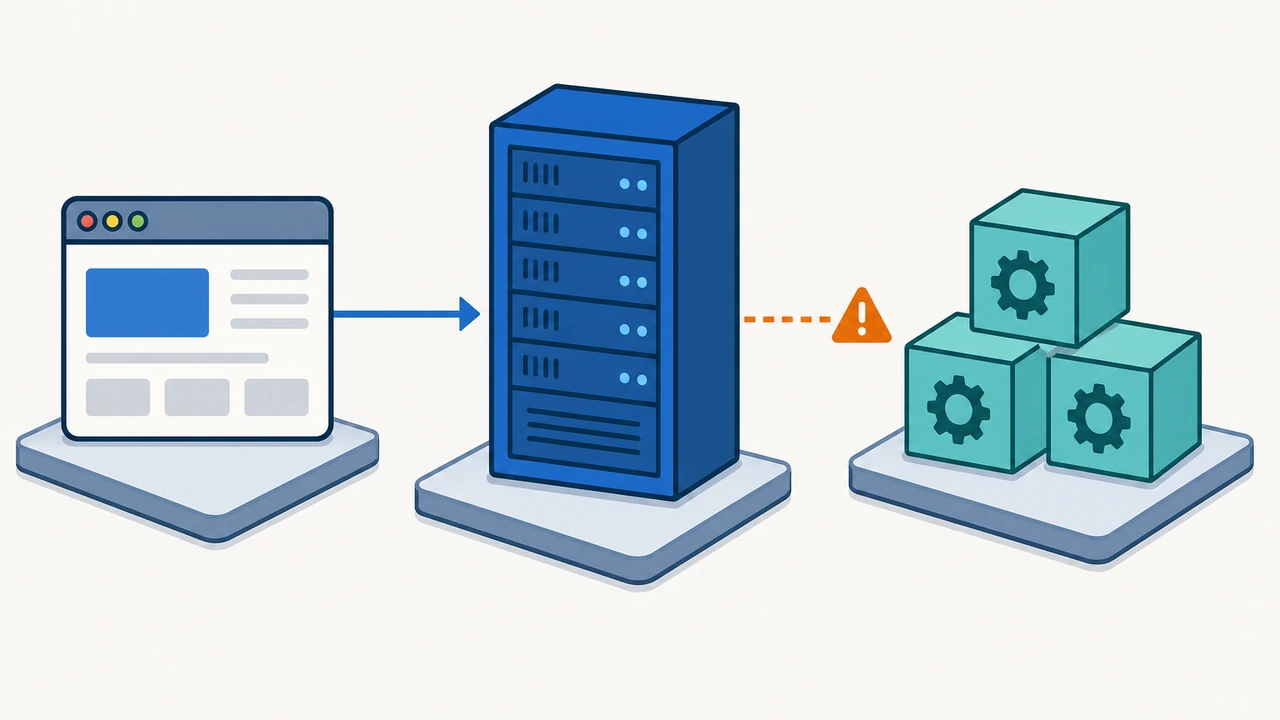
要理解 502,先要弄清楚一个动态页面在你服务器上的完整旅程。浏览器发出的请求首先到达 Nginx:静态文件(图片、CSS、JS)由它直接返回,而 PHP 页面则会被转发给 PHP-FPM 进程池执行,执行完毕后再由 Nginx 把结果送回浏览器。在这个链路里,Nginx 是前台接待,PHP-FPM 是后台车间,两者通过 socket 或 TCP 端口通信。
所谓 502 Bad Gateway,含义非常具体:Nginx 作为网关,没有从它的上游(upstream,也就是 PHP-FPM)拿到有效响应。要么是 PHP-FPM 根本没应答——进程没启动、监听地址不对;要么是应答太慢,Nginx 等不到结果就放弃了。搬家之所以高发 502,正是因为迁移过程几乎集中了所有诱因:新服务器 PHP 版本不同导致 socket 路径变化、配置文件里的路径没有同步更新、新环境内存规格不同造成进程数不足、数据库连接信息还指向旧主机。
在动手改任何配置之前,建议先花两分钟阅读我们整理的 WordPress 运维专题,那里有大量同类型故障的处理经验,能帮你建立整体判断框架,避免头痛医头。
第一步:让错误日志说话
猜测是排查的大敌,日志才是事实。出现 502 后第一个动作永远是看 Nginx 的错误日志,CentOS 与 Debian 系默认路径略有差异:
tail -n 100 /var/log/nginx/error.log
你会看到两类关键信息。第一类形如 connect() to unix:/run/php/php8.1-fpm.sock failed (2: No such file or directory),这是连接失败——Nginx 找不到 PHP-FPM 的 socket 文件,说明服务未启动或监听路径不匹配。第二类形如 upstream timed out (110: Connection timed out) while reading response header,这才是真正的 upstream 超时——PHP-FPM 在运行,但执行太慢,Nginx 默认只等 60 秒就放弃了。
两类错误的修复方向完全不同:前者查服务与路径,后者查性能与资源。如果你的站点在搬家前从未超时、搬家后频繁超时,通常指向第二类,也就是本文的重点。另外提一句,如果你的旧主机本身就有性能瓶颈,可以在我们另一篇 TTFB 首字节时间优化指南 里找到迁移前的性能基线评估方法。
第二步:处理连接失败型 502
面对 No such file or directory,按顺序执行三个检查。先确认 PHP-FPM 服务状态:
systemctl status php8.1-fpm
systemctl enable --now php8.1-fpm
再核对监听地址是否一致。打开 /etc/php/8.1/fpm/pool.d/www.conf 查看 listen = 一行,与 Nginx 站点配置里 fastcgi_pass 指向的路径(或 127.0.0.1:9000 端口)逐字符比对——搬家时旧服务器是 PHP 7.4、新服务器是 8.1,socket 路径里的版本号不同,是这类 502 最常见的根因。最后确认权限:socket 文件的属主需要与 Nginx 的运行用户(通常是 www-data 或 nginx)匹配,listen.owner 与 listen.group 两个参数就是为此准备的。三个检查做完,连接失败型 502 基本都能当场解决。
第三步:PHP-FPM 进程池调优
确认服务在运行、502 依然间歇性出现后,问题多半落在资源分配上。PHP-FPM 的进程管理有三个核心参数:pm(进程管理模式)、pm.max_children(最大子进程数)、pm.max_requests(进程重启阈值)。搬家后最容易踩的坑是:配置文件从旧服务器原样搬来,但新旧机器内存规格不同,旧参数在新环境里要么浪费、要么不足。
pm.max_children 的估算公式很直接:可用内存除以单个进程平均占用。先看实际占用:
ps --no-headers -o "rss,cmd" -C php-fpm8.1 | awk '{sum+=$1; n++} END {printf "%d 个进程, 平均 %.1f MB\n", n, sum/n/1024}'
假设一台 2 GB 内存的 VPS,系统与其他服务占 400 MB,剩余约 1.6 GB 可用;单个 php-fpm 进程平均 60 MB,那么 pm.max_children = 1600 / 60 ≈ 26,保守取 24 留出余量。把这个数字写进 pool 配置并重启服务:
pm = dynamic
pm.max_children = 24
pm.start_servers = 6
pm.min_spare_servers = 4
pm.max_spare_servers = 12
pm.max_requests = 500
pm.max_requests = 500 让每个子进程处理 500 个请求后自动重启,能有效回收内存泄漏,对插件质量参差不齐的 WordPress 站点尤其有用。如果调整后日志里出现 server reached pm.max_children setting,说明并发需求超过了进程上限,要么继续上调(前提是内存允许),要么就该考虑升级主机规格了。
进程数不是越大越好。内存耗尽时系统会触发 OOM(内存溢出终止机制)直接杀掉 php-fpm 进程,Nginx 立刻收到连接拒绝,502 反而更凶猛。真正稳定的做法是让进程数匹配真实流量,这与我们在 服务器配置与优化专题 中反复强调的容量规划思路一致。
第四步:双向对齐超时与缓冲参数
upstream 超时的修复需要 Nginx 与 PHP-FPM 两侧同时动手,只改一边往往会顾此失彼。Nginx 侧在站点配置的 location 块中设置:
location ~ \.php$ {
    fastcgi_pass unix:/run/php/php8.1-fpm.sock;
    fastcgi_read_timeout 300;
    fastcgi_connect_timeout 60;
    fastcgi_send_timeout 120;
}
fastcgi_read_timeout 默认 60 秒,WordPress 后台的导出、更新、部分重型插件页面经常超过这个时长,300 秒是兼顾可用性与故障暴露的常见取值。PHP-FPM 侧则要确认 request_terminate_timeout = 300,且数值大于或等于 Nginx 侧——如果 PHP-FPM 先杀进程,Nginx 记录的是 connection reset;如果 Nginx 先放弃,PHP 侧还在空跑。两边对齐后,慢请求要么成功返回,要么在统一的时间点被切断并留下清晰日志。
缓冲区是另一个隐性来源。当页面较大(例如含大量表格的报表页)而 fastcgi_buffer 偏小时,日志会出现 upstream sent too big header,同样以 502 呈现。在 http 或 server 块中加入 fastcgi_buffer_size 32k 与 fastcgi_buffers 8 32k 可以解决多数场景。改完执行 nginx -t 验证语法,再 systemctl reload nginx 平滑生效,不需要断开现有连接。
第五步:搬家场景专属的三个检查点
通用调优之外,迁移本身还会引入三类容易被忽略的 502 诱因,建议逐一核对。
wp-config.php 中的 DB_HOST 是否已指向新数据库地址。如果旧主机已停机而配置还指向旧地址,每个页面渲染都会等待数据库连接超时,在 Nginx 眼里就是标准的 upstream timed out——这是搬家后最经典也最冤的 502,因为它与性能无关,纯粹是配置遗漏。
新服务器的 DNS(域名解析服务,负责把域名翻译成服务器 IP 地址)解析与 hosts 记录是否干净。若站点使用了外部的对象存储、邮件或反垃圾服务,这些域名在新环境的解析失败同样会让 PHP 卡在等待阶段。用 dig 或 curl -v 逐一验证外部依赖的可达性,比反复重启服务有效得多。
Redis 或 Memcached 的连接配置是否同步迁移。搬家后插件仍在尝试连接旧缓存地址的场景屡见不鲜:object-cache.php 会被一并复制过来,但新服务器上并没有对应的缓存服务,或地址已经变化。临时将 wp-content/object-cache.php 改名移除,如果 502 立刻消失,问题就锁定在缓存层。
完成上述检查后,用一段时间的错误日志观察收尾:
tail -f /var/log/nginx/error.log | grep --line-buffered "upstream"
持续观察半小时无新增超时记录,再配合浏览器无痕模式多刷新几个重型页面,才能确认修复真正落地。
总结与下一步建议
回顾整个排查链条:先用错误日志区分连接失败与 upstream 超时,前者核对服务状态、socket 路径与权限,后者从 PHP-FPM 进程池的内存估算入手,再双向对齐 Nginx 与 PHP-FPM 的超时参数,最后补上 DB_HOST、DNS、缓存这三个搬家专属检查点。每一步都有明确的日志证据支撑,避免陷入”重启试试”的循环。
如果你反复调整后 502 仍间歇出现,或日志频繁出现 pm.max_children 告警,说明当前主机资源已经无法支撑站点流量,建议考虑升级到更高配置的 Hostease VPS 主机,或交由 WordPress 专用主机 托管环境处理性能与运维细节。迁移与排障的经验也可以沉淀成规范流程,我们之前的 WordPress 迁移实践文章里有更完整的分阶段操作清单,配合本文使用效果更好。
配置调优没有一劳永逸,流量增长、插件变更都会让昨天的参数变成明天的瓶颈。建议每季度复查一次进程平均内存与错误日志趋势,把 502 消灭在发生之前。