在独立服务器的所有硬件中,机械磁盘是故障率最高的部件之一。一块磁盘从出现第一个坏道到彻底失效,可能是几周,也可能只有几天。如果你等到网站打不开、数据库报错才发现问题,恢复成本会成倍放大。本文教你如何用 smartctl 这款开源工具读取磁盘的 SMART(硬盘自监测分析报告技术)数据,在坏道扩散之前拿到预警信号,并给出一份可执行的磁盘更换判断标准,帮助把突发故障变成可控的计划内维护。
无论是自行管理的物理服务器,还是 Hostease 独立服务器,只要拥有 root 权限,都可以直接使用本文的方法。在开始之前,建议先通过 IPMI 或服务商后台确认机器的磁盘数量与阵列配置,因为 RAID(独立冗余磁盘阵列)卡下的虚拟盘和直通的物理盘,在 smartctl 中的查询方式略有差别。
smartctl 是什么:先拿到工具再谈巡检
smartctl 是 smartmontools 软件包中的命令行工具,能够直接读取磁盘固件记录的 SMART 属性。SMART 是内置于磁盘固件的自监测机制,会持续记录磁头、盘片、电机等部件的运行状态。安装非常简单,Debian 和 Ubuntu 执行:
apt install -y smartmontools
CentOS 与其他使用 dnf 的发行版执行:
dnf install -y smartmontools
安装完成后,先用一条最短的命令确认磁盘整体健康状态:
smartctl -H /dev/sda
输出中的 SMART overall-health self-assessment test result 一行是核心结论:PASSED 表示磁盘自检通过,FAILED! 则意味着磁盘已经判定自身即将失效,必须立即安排更换。要看完整的属性列表,把 -H 换成 -A;要一次看全部信息(包括型号、序列号、温度和错误日志),使用 smartctl -a /dev/sda。需要注意,如果服务器使用了 RAID 卡,系统可能只看到虚拟盘,此时需要加 --device=cciss,N 或 sat+ 等参数穿透阵列卡查询成员盘,具体以 RAID 卡型号为准。
五个必须盯住的关键 SMART 指标
smartctl -A 会输出几十行属性,但绝大多数与坏道预警无关。机械盘上真正值得每天盯住的,是下面这五个指标,这也是判断磁盘是否正在恶化的核心依据:
- Reallocated_Sector_Ct(05,重分配扇区数):磁盘把损坏扇区的数据搬到备用扇区的次数。原始值大于 0 说明盘面已经出现物理坏道,数值持续增长是最危险的信号。
- Current_Pending_Sector(197,待定扇区数):等待重映射的不稳定扇区。这个值不为 0 且增长,说明坏道正在活跃产生,随时可能丢数据。
- Offline_Uncorrectable(198,离线不可修复扇区数):离线自检时无法修复的错误扇区,大于 0 通常意味着盘片物理损伤。
- Power_On_Hours(09,累计通电时间):机械盘设计寿命一般为 5 年约 43800 小时,超过 3 万小时就应提高巡检频率。
- Temperature_Celsius(194,温度):持续高于 45 摄氏度会加速磁头和盘片老化,是坏道的间接推手。
看指标时要养成记录基线的习惯:第一次巡检时把每块盘的 05、197、198 原始值记下来,之后对比才有意义。单次快照里 raw 值为 0 固然是好迹象,但真正的预警来自数值随时间的增长趋势,这一点在后面的判断标准中会反复用到。对 NVMe 固态盘,属性结构不同,重点看 smartctl -a /dev/nvme0 输出中的 percentage_used(已消耗寿命百分比)与 media_errors(介质错误计数)两个字段即可。
坏道预警:从指标数字到更换决策
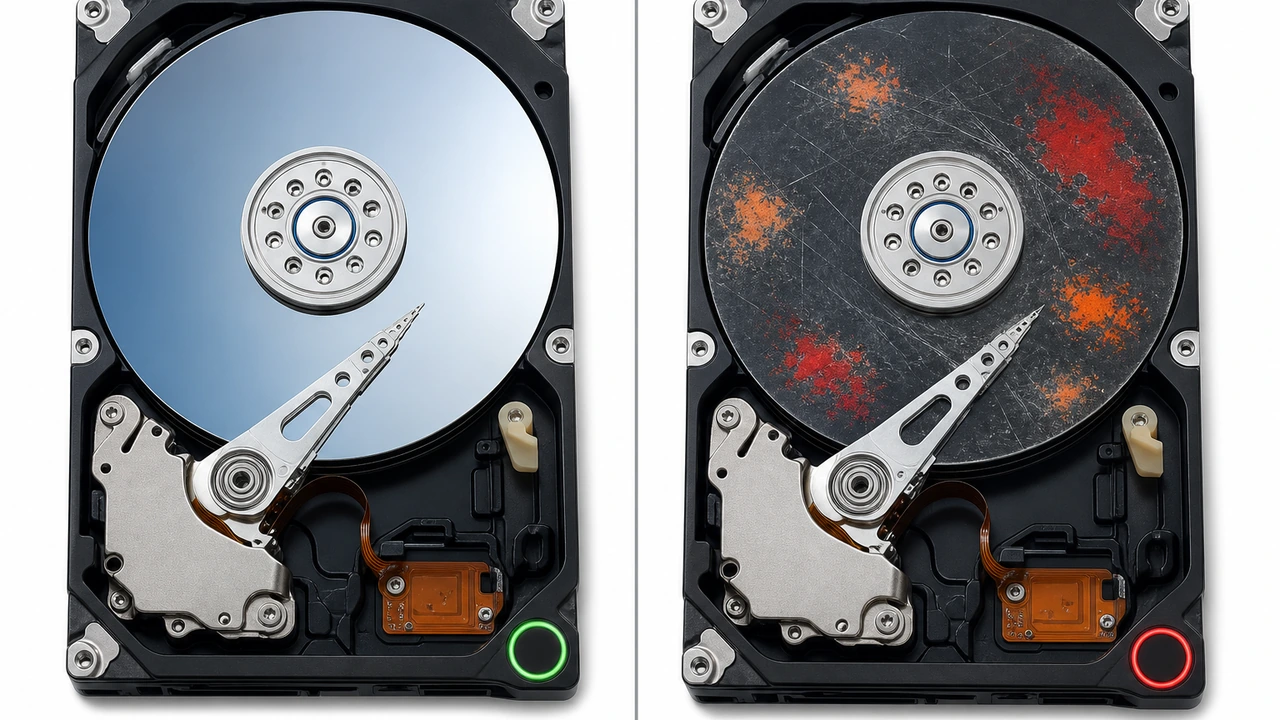
有了指标,下一步是把它翻译成”要不要换盘”的决策。以下标准综合了各家磁盘厂商的白皮书与大量运维实践,按紧急程度从高到低排列:
- 立即更换:
smartctl -H结果为FAILED!;或 197、198 的 raw 值不为 0 且在数次巡检间持续增长。这说明坏道正在活跃扩散,RAID 阵列随时可能因二次损坏而崩溃。 - 两周内计划更换:05 的 raw 值大于 0 且缓慢增长,同时伴随 197 偶发性非零。坏道已有扩散迹象,应趁数据仍完整时安排换盘窗口。
- 加强监控:05 的 raw 值为一个稳定的小数字(如 1-10),长期不增长。这是磁盘早期自愈留下的痕迹,可以继续服役,但巡检频率应提高到每天一次。
- 按寿命规划:通电时间超过 4 万小时但上述指标全部正常。建议列入年度换盘预算,避免多块盘同时到达寿命终点。
判断之外还要主动施压:执行 smartctl -t short /dev/sda 触发约两分钟的短自检,用 smartctl -l selftest /dev/sda 查看结果;每月安排一次 smartctl -t long 深度扫描。自检直接读取盘片全表面,比被动等待 SMART 计数更能提前暴露潜在坏道。换盘决策永远不要只看单一指标,把健康结论、增长趋势、自检结果和机箱内同批次磁盘的表现放在一起权衡,结论才可靠。
把巡检自动化:用 smartd 代替人工盯梢
手动巡检最大的问题是”忙起来就忘了”。smartmontools 自带的 smartd 守护进程可以彻底解决这个问题。编辑 /etc/smartd.conf,用一行配置覆盖所有磁盘:
DEVICESCAN -H -l error -l selftest -m root -M daily
这行配置让 smartd 每 30 分钟轮询一次所有磁盘的总体健康与错误日志,一旦任一项从 PASSED 恶化,立即给 root 邮箱发信,且恶化期间每天提醒一次。改完配置后启用服务:
systemctl enable --now smartd
如果希望把巡检数据接入现有的监控体系,可以写一个简单的定时脚本,把 05、197、198 的 raw 值输出为监控系统能抓取的格式。一个可用的最小示例:
#!/bin/bash
for d in /dev/sd?; do
  echo -n "$d reallocated="
  smartctl -A "$d" | awk '/Reallocated_Sector_Ct/{print $10}'
done
配合 cron 每小时执行,输出接入 Zabbix 或 Prometheus 的文本采集器即可实现趋势告警。巡检自动化只是运维体系的一环,磁盘健康与整机负载、网络质量共同决定业务稳定性,这些内容与 服务器运维实践中的其他监控项可以统一规划,而 性能优化指南则适合作为巡检之后的下一步读物。
换盘前的准备与总结建议
一旦决定更换磁盘,先做好三件事再动手:第一,确认备份可用,用实际恢复演练验证过的备份才算数;第二,记录 RAID 阵列当前状态,例如执行 cat /proc/mdstat 与 mdadm --detail /dev/md0 留底;第三,向服务商或机房确认热插拔支持与备件到位时间,避免拆盘后长时间降级运行。换盘后第一时间重建阵列,并把新盘纳入 smartd 监控,重新建立指标基线。
总结一下:磁盘故障不可预测,但坏道扩散有迹可循。建议为每台独立服务器建立”基线记录 + 每周比对 + smartd 实时告警”的三层巡检体系;05、197、198 三项指标任何一项持续增长,就应当启动换盘评估,而不是等到阵列降级再被动应对。如果你的业务还没有到独享物理硬件的规模,也可以考虑先用 Hostease VPS(虚拟专用服务器) 承载,把底层硬件巡检交给服务商,把精力集中在应用层;待流量与数据量上来后再迁移到独立服务器。无论选择哪种形态,把磁盘健康巡检写进日常运维清单,都是成本最低的可靠性投资。