图解美国 VPS 回程线路诊断与 TCP 参数优化的核心概念
问题场景:为什么美国 VPS 访问速度慢
如果你运营面向国内用户的网站或应用,选择美国 VPS(虚拟专用服务器)时经常会遇到 ping 值不高但实际访问速度很慢的问题。这种现象的核心原因往往不是去程线路,而是回程线路质量和TCP 参数配置。
本文教你如何诊断回程线路问题,并通过 TCP 参数优化来改善访问速度。
理解网络延迟的构成
去程与回程的差异
当你从国内访问美国 VPS 时,数据包需要完成一个往返旅程:去程是国内客户端到美国 VPS,回程是美国 VPS 到国内客户端。
大多数情况下,去程线路经过优化(如 CN2 GIA、CUVIP 等),ping 值可以控制在 120-150ms。但回程线路往往走公共互联网,可能绕道欧洲或东南亚,导致实际延迟达到 200-300ms 甚至更高。
延迟的组成要素
总延迟 = 物理传播延迟 + 路由跳数延迟 + 拥塞排队延迟 + TCP 握手延迟
- 物理传播延迟:光在光纤中的传播速度决定,无法优化
- 路由跳数延迟:经过的路由器数量,每跳增加 1-5ms
- 拥塞排队延迟:链路拥塞时数据包排队等待,波动最大
- TCP 握手延迟:建立连接所需的三次握手时间
我们建议的做法是:先测量各环节延迟,再针对性优化。
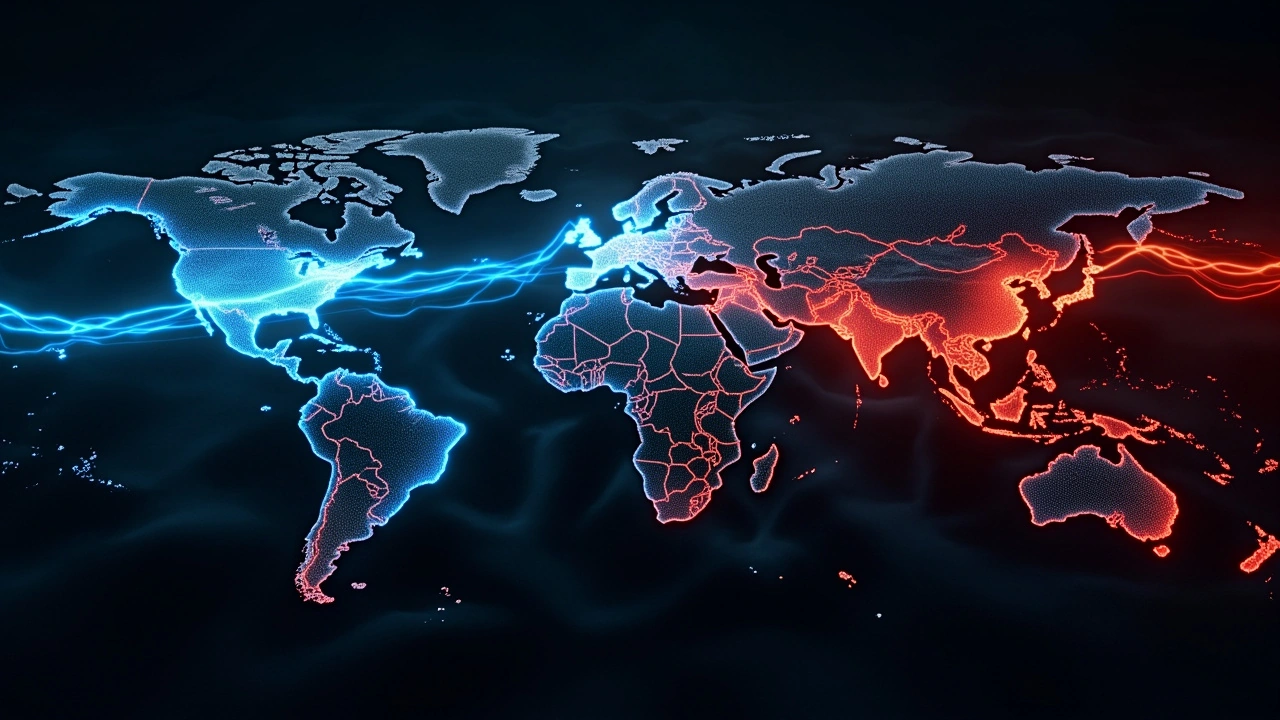
去程线路优化但回程绕道导致实际延迟增加
第一步:诊断回程线路质量
使用 MTR 测试路由路径
MTR(My Traceroute)结合了 ping 和 traceroute 的功能,可以显示每一跳的延迟和丢包率。
apt-get install mtr -y
mtr -rwC 100 -c 100 目标 IP
识别问题节点的方法:
- 丢包率突增:某一跳丢包超过 5%,说明该节点拥塞
- 延迟跳变:相邻两跳延迟增加超过 50ms,说明绕路或拥塞
- 持续高延迟:从某跳开始后续所有节点延迟都高,说明该跳是瓶颈
使用 BestTrace 识别线路类型
wget https://cdn.ipip.net/17mon/besttrace4linux.zip
unzip besttrace4linux.zip
chmod +x besttrace
./besttrace 目标 IP
线路类型判断:
- CN2 GIA:显示”电信 CN2″
- 169 线路:显示”Level3″、”NTT”等,走公共互联网
- CUVIP:显示”联通 CUII”
如果回程走 169 线路,延迟和丢包都会比较明显。
使用 TCPing 测试实际连接延迟
tcping -t 目标 IP 80
tcping -t 目标 IP 443
如果 ping 延迟 150ms,TCPing 延迟 200ms+,说明 TCP 握手或 TLS 握手有额外开销。
第二步:优化 TCP 参数
修改 TCP 拥塞控制算法
查看当前算法:
sysctl net.ipv4.tcp_congestion_control
常见算法对比:
| 算法 | 适用场景 | 特点 |
|---|---|---|
| cubic | 默认算法 | 高速网络表现好 |
| bbr | 推荐 | 适合高延迟、有丢包的链路 |
| reno | 传统算法 | 保守,适合稳定网络 |
启用 BBR 算法(推荐):
echo "net.core.default_qdisc=fq" >> /etc/sysctl.conf
echo "net.ipv4.tcp_congestion_control=bbr" >> /etc/sysctl.conf
sysctl -p
BBR 通过持续测量网络传输能力和往返时间来优化发送速率,特别适合跨洋高延迟链路。实际测试中,BBR 可以将吞吐量提升 20-50%。
调整 TCP 缓冲区大小
net.ipv4.tcp_rmem = 4096 87380 67108864
net.ipv4.tcp_wmem = 4096 65536 67108864
net.core.rmem_max = 67108864
net.core.wmem_max = 67108864
net.ipv4.tcp_window_scaling = 1
net.ipv4.tcp_sack = 1
sysctl -p
优化 TCP 连接复用
启用 TCP Fast Open:
echo "net.ipv4.tcp_fastopen = 3" >> /etc/sysctl.conf
sysctl -p
TCP Fast Open 允许在三次握手期间发送数据,可以减少一个往返时间的延迟。
第三步:应用层优化建议
启用 HTTP/2
HTTP/2 的多路复用特性可以减少连接建立次数。
server {
    listen 443 ssl http2;
    server_name example.com;
}
配置 CDN 加速
CDN(内容分发网络)可以将静态资源缓存到离用户更近的节点。更多关于 CDN 优化的内容,可以参考我们的 跨境业务 DNS 解析慢优化:权威 DNS、TTL 与多线路服务器调度。如果你的 VPS 还存在 CPU 或内存的性能瓶颈,可以参考 电商网站服务器 CPU 打满排查:Nginx、PHP-FPM 与 MySQL 联调 做综合排查。
CDN 选型建议:Cloudflare(免费套餐,全球节点多)、阿里云 CDN(国内节点多)。
优化 SSL 握手
SSL(安全套接层)握手是 HTTPS 延迟的重要来源。
ssl_protocols TLSv1.2 TLSv1.3;
ssl_session_cache shared:SSL:10m;
第四步:持续监控
优化完成后,建立监控基线并设置告警。磁盘 IO 的持续抖动同样会加剧响应延迟,建议同步参考 VPS 服务器磁盘 IO 抖动处理:存储基线测试与主机性能治理 建立完整的性能基线:
- 延迟告警:ping 值持续超过 200ms
- 丢包告警:丢包率超过 5%
使用监控工具(如 Uptime Robot、Pingdom)持续追踪延迟、丢包率和响应时间。
常见问题解答
Q1:优化后延迟没有明显改善,怎么办?
可能原因:物理距离限制(中美约 120-140ms)、运营商互联拥塞、VPS 性能不足。
建议:考虑更换到香港、日本、新加坡等更近地区。
Q2:BBR 算法有什么副作用吗?
BBR 可能在拥塞时占用过多网络资源,且需要 Linux 4.9+ 内核。建议先在测试环境验证。
Q3:如何判断是否需要更换 VPS 服务商?
如果出现以下情况,建议考虑更换:回程持续走 169 线路、高峰期丢包率超过 10%、延迟持续超过 300ms。
你可以选择提供 CN2 GIA、CUVIP 等优化线路的服务商。更多关于 VPS 配置的信息,可以查看我们的 VPS 主机页面。
总结
美国 VPS 延迟高的核心原因是回程线路质量和 TCP 参数配置。
关键步骤:
1. 使用 MTR、BestTrace 诊断回程瓶颈
2. 启用 BBR、调整 TCP 缓冲区
3. 配置 CDN、优化 SSL 握手
4. 持续监控延迟和丢包率
立即行动:在 VPS 上执行 MTR 测试,根据结果应用 TCP 优化配置,一周后复查效果。
通过系统化诊断和优化,你可以显著改善访问速度。