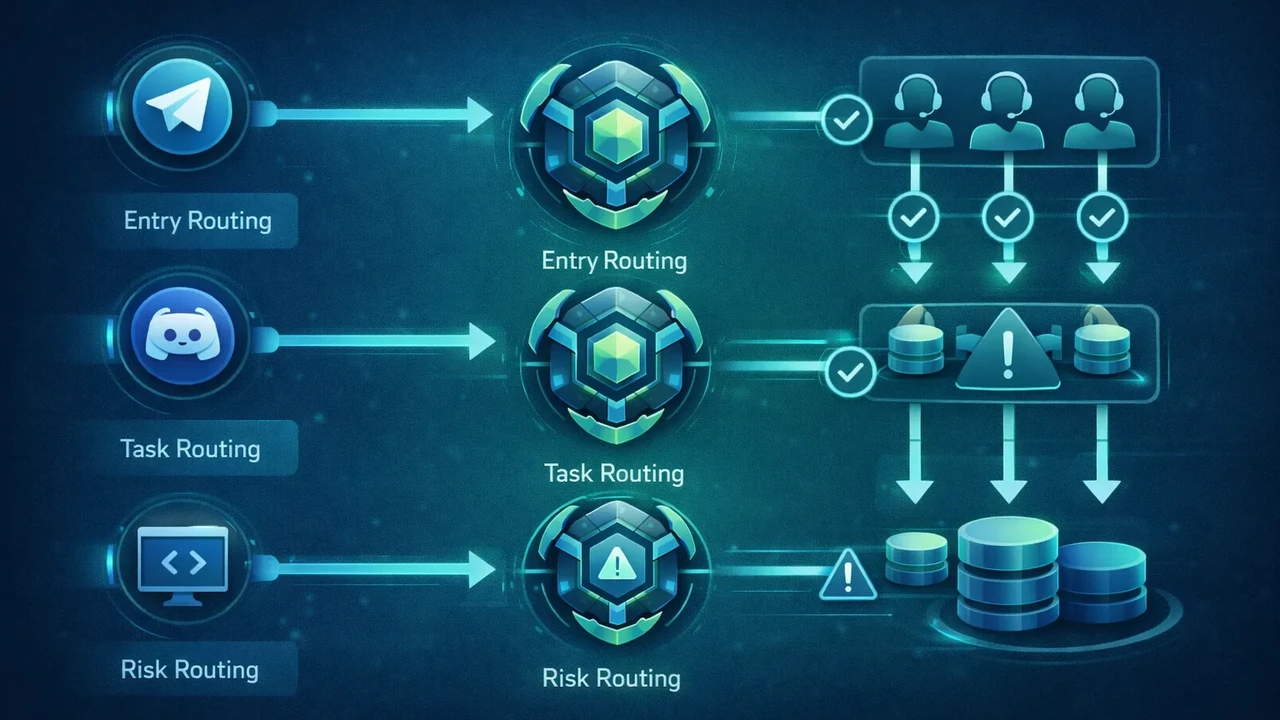
当 Telegram、Discord 和 Web 入口都能触发同一个 AI Agent(人工智能代理)时,团队真正要解决的不是“如何接上渠道”,而是“每条消息如何留痕、确认和回传”。这篇指南把 OpenClaw Channels 拆成一份复核清单:入口变多以后,哪些请求应该自动处理,哪些必须人工确认,哪些日志要保留下来,才能让消息流进入可审计的工作流,而不是把原本清晰的协作链路冲散。
很多团队第一次接 Channels,会把它当成一个“聊天机器人入口”。这种理解不算错,但不够完整。Channels 更像一层入口路由:它负责把外部消息送进 Agent,再由后面的工具、权限和执行策略决定结果。只要这层路由没有设计好,Telegram 的即时消息、Discord 的频道讨论和 Web 的审阅入口就会互相干扰,最后变成“能触发,但不好维护”。
如果你的场景已经涉及长期在线服务,建议先把运行环境、日志目录和恢复方式单独规划。相关基础设施思路可以参考 Hostease 的 服务器内容 与 VPS(虚拟专用服务器)相关文章,先把承载节点想清楚,再决定把多少消息入口交给 Channels。
先定位故障:入口问题、路由问题,还是执行问题
Channels 出问题时,最容易被误判的是“入口连不上”。实际排查时,应先把链路拆成三段:第一段是消息入口是否收到请求,第二段是路由规则是否把请求送到正确 Agent,第三段是 Agent 是否调用了正确工具并返回结果。只有分段看,才能知道该改登录配置、改路由规则,还是改后面的执行策略。
一个简单的判断方式是记录 3 个时间点:消息进入渠道的时间、OpenClaw 收到事件的时间、Agent 输出结果的时间。如果第一个时间点存在、第二个没有,问题多半在渠道绑定或回调;如果第二个存在、第三个没有,重点就要转向 Agent 权限、工具调用或任务队列。这个拆法比直接重启服务更可靠,也便于后续复盘。
在团队实践中,我们建议把每个入口都先绑定一个低风险测试任务,例如“返回当前工作区名称”或“整理最近 10 条通知摘要”。测试任务不访问敏感文件、不触发发布动作,只验证消息是否能走完整链路。等 3 个入口都通过同一套测试后,再逐步放开更复杂的任务。
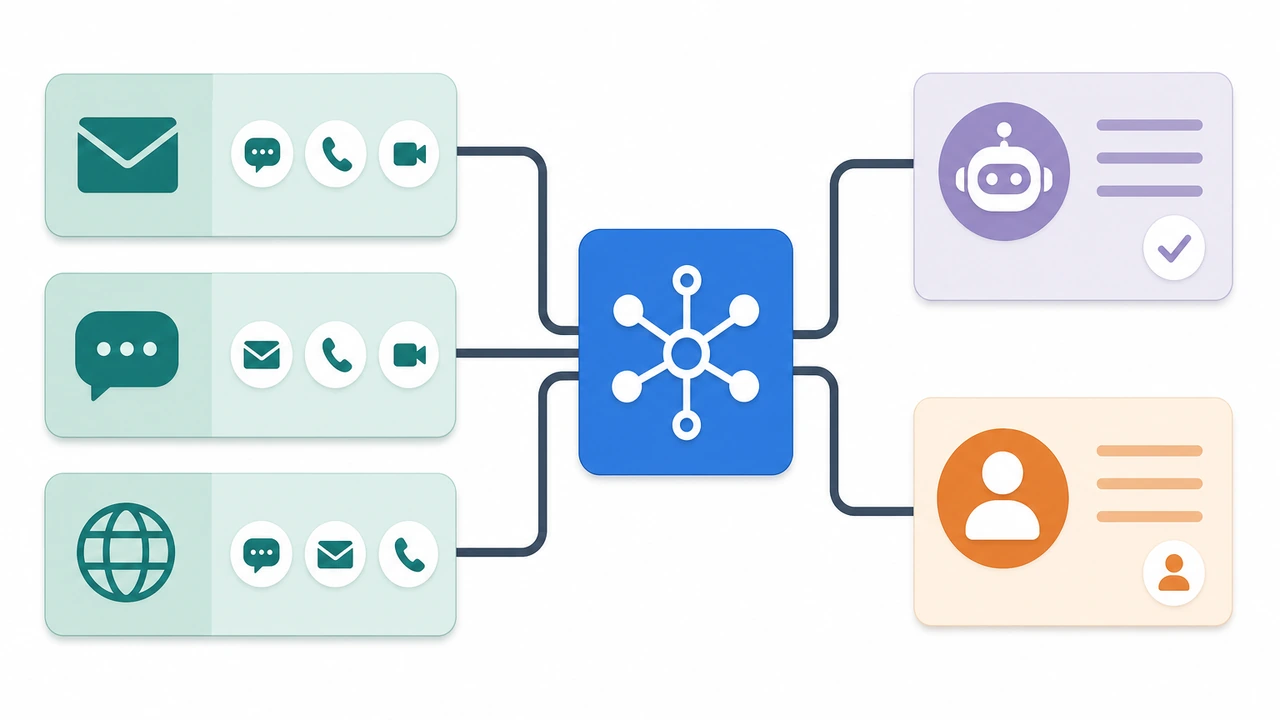
Telegram、Discord 与 Web 入口不要承担同一种职责
Telegram 适合短指令和即时提醒
Telegram 更适合“短、快、低上下文”的任务,例如提醒某个构建失败、返回一条状态摘要、接收固定格式的巡检结果。它的优势是触达快,但短消息也容易缺上下文。因此,Telegram 入口不要默认承接需要长时间推理、多人讨论或高风险写入的任务。如果想让这类通知流从监控系统自动推送过来,可以参考 Webhook 告警接入实战:服务器监控推送到即时通讯 中的配置思路,先把告警格式固定下来,再交给 Agent 处理。
Discord 适合频道协作和共享上下文
Discord 更像团队讨论空间。它适合把某类事件推到固定频道,让多人看到同一份结果,再决定是否继续处理。比如内容团队可以把“待审核摘要”推到一个频道,运维团队可以把“异常日志摘要”推到另一个频道。频道能保留上下文,但也意味着路由规则必须更明确,避免一个 Agent 被多个频道同时拉扯。
Web 入口适合审阅、确认和复核
Web 入口通常不追求最快,而是追求可视化和可确认。对于需要人工点选、查看长结果或做二次确认的流程,Web 入口比聊天窗口更稳。尤其是涉及内容发布、配置变更、工单回复这类动作时,Web 入口可以作为“确认层”,把自动化和最终决策分开。
如果你还在梳理站点内容或自动化入口的关系,可以顺带参考 WordPress 相关文章 中关于内容工作流的做法,把“消息触发”和“内容处理”拆开看。这样设计出来的 Channels,不会因为入口方便就把所有权限都堆到同一个地方。
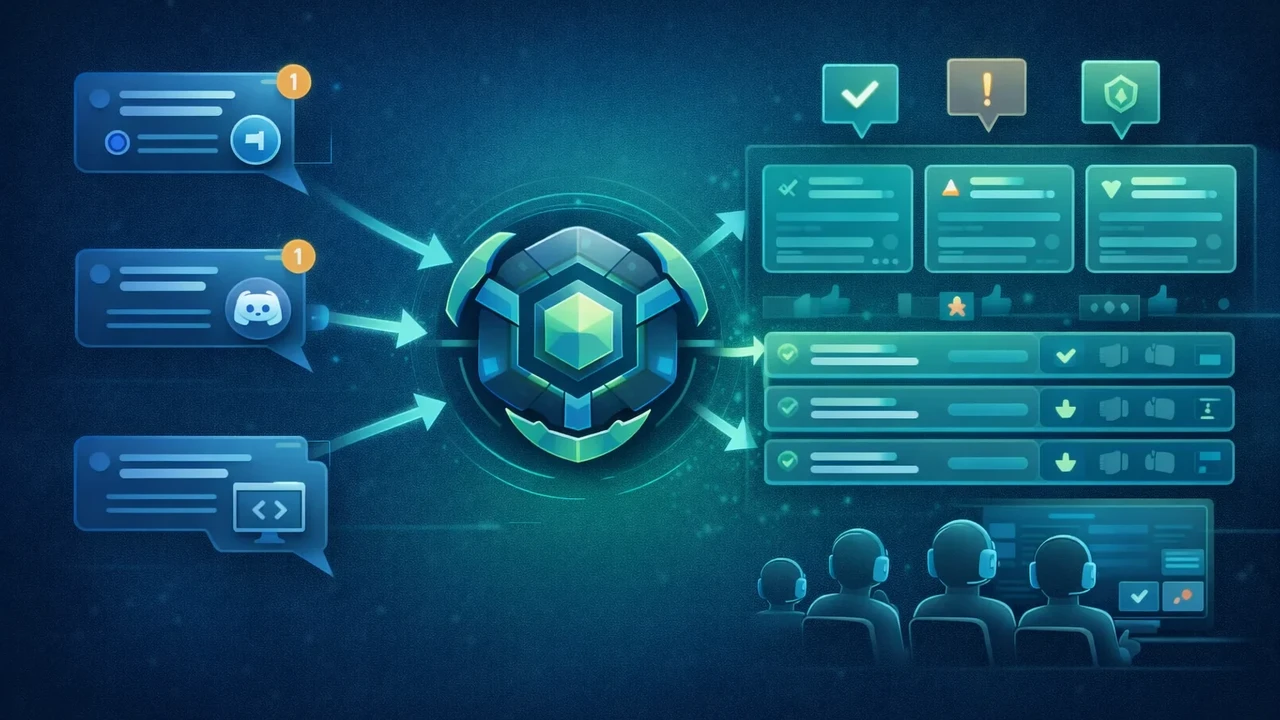
三层路由比单一路由更好维护
稳定的 Channels 路由通常不是“一条消息进来,直接交给某个 Agent”。更稳的做法是先按入口分流,再按任务分流,最后按风险分流。这样即使某一层需要调整,也不会影响全部入口。
- 入口层:把 Telegram、Discord、Web 分别记录来源,日志中至少保留 channel、user、timestamp 这 3 个字段。
- 任务层:把通知、资料整理、状态查询、执行动作分成不同任务类型,不让一个 Agent 同时承担所有职责。
- 风险层:低风险查询可以自动回复;涉及写文件、改配置、发布内容的动作必须进入人工确认。
这三层看起来多了一步,但能减少后期返工。比如 Telegram 入口只允许查询,Discord 入口允许生成摘要,Web 入口才允许确认执行。这样即使聊天频道被误触发,也不会直接影响生产环境。
对于需要长期运行的 Channels 节点,运行环境也要和本地开发环境分开。你可以把开发测试留在本机,把稳定服务放到 [VPS](https://cn.hostease.com/vps/)([虚拟专用服务器](https://cn.hostease.com/vps/))或[独立服务器](https://cn.hostease.com/dedicated-server/)上,并为日志、备份和重启策略预留空间。关于页面性能和承载链路的基础优化,也可以延伸阅读 TTFB 与主机优化指南,其中的分层排查思路同样适用于消息入口服务。
排障时重点看 4 个信号
当 Channels 偶发失败时,不要先凭感觉改配置。更可靠的做法是围绕 4 个信号收集证据:入口是否收到、路由是否命中、Agent 是否执行、结果是否回传。每个信号都应该能在日志里找到对应记录。
- 入口事件:是否有 message_id 或 request_id,能否对应到具体渠道。
- 路由命中:是否记录了 route_name、agent_name 和匹配规则,避免只看到“已处理”。
- 执行结果:是否能区分成功、超时、权限拒绝和工具异常,便于定位责任边界。
- 回传状态:是否明确写出 reply_sent=true 或失败原因,避免用户以为 Agent 没响应。
如果这 4 个信号都没有,Channels 就很难进入团队流程;一旦出问题,只能靠人回忆。反过来,只要这些信号齐全,哪怕第一次配置不完美,也能用日志逐步收敛。要是告警信号本身还没建好,可以从 Prometheus 指标告警规则配置:服务器预警实战 里挑两三条关键规则先接进来,让每个入口都有可观测的输入源。
不要把渠道当成权限系统
一个常见误区是:认为“来自某个频道的消息就天然可信”。渠道只能说明消息从哪里来,不能说明它可以做什么。权限应该落在 Agent、工具和执行策略上,而不是落在 Telegram 群、Discord 频道或某个网页按钮上。
更稳的策略是把动作分成三类:只读查询、可回滚修改、不可轻易回滚的生产动作。只读查询可以自动处理;可回滚修改需要记录变更前后的差异;不可轻易回滚的动作必须要求人工确认,并把确认人、确认时间和执行结果写入日志。这样设计以后,Channels 才不会因为入口便利而扩大风险。对于无人值守的自动化任务,失败兜底可以参考 Bash trap 错误处理:服务器自动化任务容错实战 中的思路,确保脚本中断时也能留下可追溯的记录。
对于内容团队来说,这一点尤其关键。草稿生成、素材整理可以自动化,但发布、更新线上文章、删除资源这类动作应该保留在明确的审核流程里。Channels 可以负责提醒和汇总,不应该绕过审查链路。
结语:先让一个入口跑稳,再扩展更多渠道
OpenClaw Channels 的价值不在于一次接入多少平台,而在于帮助团队把 AI Agent(人工智能代理)放进真实工作流。建议从一个低风险入口开始:先定义消息类型,再定义路由规则,再定义人工确认点。等日志能完整复盘、失败能快速定位,再增加第二个入口。
如果你需要把 Channels 放到长期运行环境中,可以考虑先准备稳定的服务器或 VPS(虚拟[专用服务器](https://cn.hostease.com/dedicated-server/))节点,并把日志、备份、重启策略一起纳入规划。总结起来,入口越多,越要把分流、权限和复核做细;先跑稳一条链路,再扩展更多渠道,通常比一开始追求全自动更可靠。