服务器半夜宕机、CPU 飙满、磁盘写满,往往都是用户先发现而不是运维先发现——问题不在于没有工具,而在于没有一条能提前抓指标、发告警的监控链路。这篇文章教你如何用 node_exporter 与 Prometheus 搭建这条链路:从安装 node_exporter、配置 Prometheus 抓取任务,到用 PromQL 写出第一条 CPU 告警规则,再到接入邮件通知。为什么选这套组合?因为两者都是开源项目,不绑定云厂商,一台 VPS(虚拟专用服务器)到一排独立服务器都能用同一套方法接入。读完全文,你会得到一份可直接复用的抓取与告警配置。
场景:为什么”出了事再看”总是来不及
先看一个典型场景:一台跑着网站的服务器连续三天磁盘使用率缓慢上涨,从 70% 涨到 98%,期间没有任何报错日志,直到某天凌晨日志服务写不进磁盘、数据库停止响应,故障才被发现。如果当时有一条”磁盘使用率超过 85% 持续 10 分钟就告警”的规则,这本来是一条提前三天就能处理的工单。
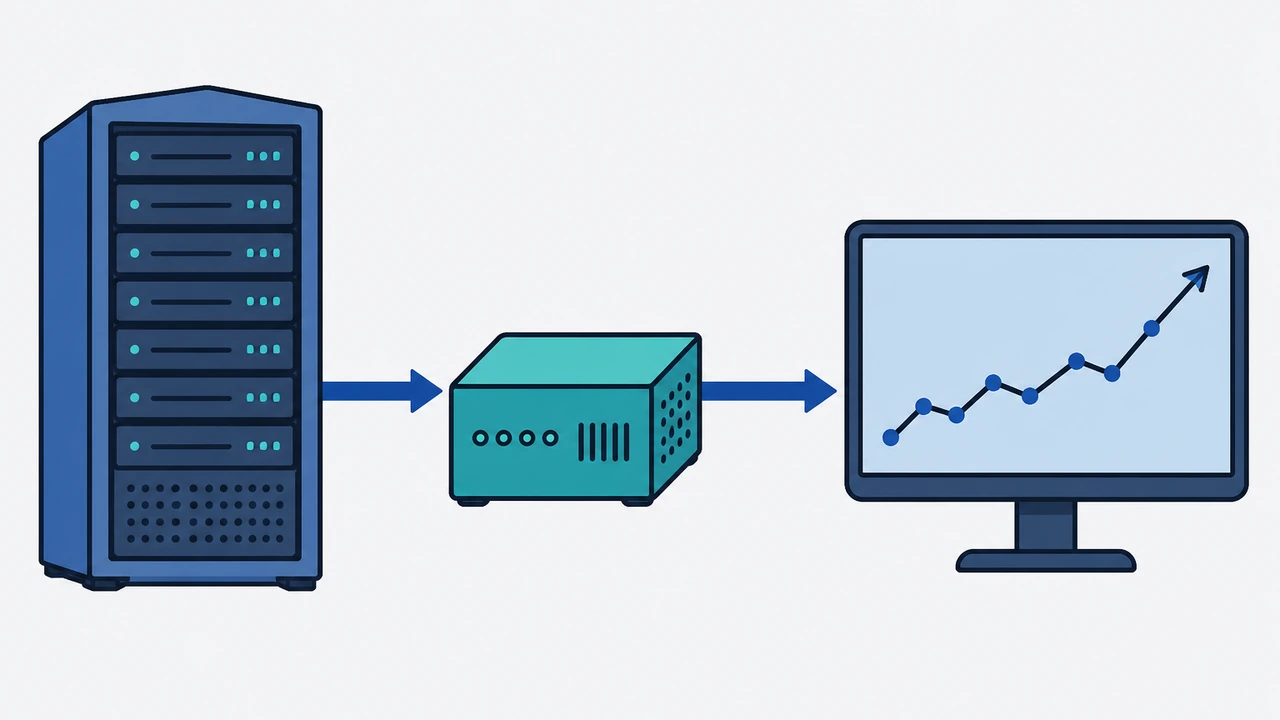
这类问题无法靠人肉解决:一个人最多盯几台机器,而一条 df -h 只能反映执行那一秒的状态。解决思路是把两件事自动化——持续抓取(定时把 CPU、内存、磁盘、网络等指标存下来)和规则告警(对指标持续计算,命中条件就发通知)。node_exporter 负责”暴露指标”,Prometheus 负责”抓取和存储”,Alertmanager 负责”把告警发出去”,三者分工明确,这也是本文的主线。
准备工作与安装 node_exporter
在动手之前,先确认三个前提:一台可 SSH 登录的 Linux 服务器(本文以 root 或具备 sudo 权限的用户操作)、放行本机 9100 端口用于指标暴露、以及一台用于部署 Prometheus 的机器(可以是同一台,生产环境建议分开)。
node_exporter 的安装非常轻量,它是一个静态编译的单文件二进制,不依赖额外运行时。以下命令以 1.8.x 版本窗口为例,实际安装时请以官方下载页发布的最新稳定版为准:
# 下载并解压(版本号以官网最新稳定版为准)
wget https://github.com/prometheus/node_exporter/releases/download/v1.8.2/node_exporter-1.8.2.linux-amd64.tar.gz
tar xvfz node_exporter-1.8.2.linux-amd64.tar.gz
sudo mv node_exporter-1.8.2.linux-amd64/node_exporter /usr/local/bin/

# 创建专用系统用户并注册为 systemd 服务
sudo useradd -rs /sbin/nologin node_exporter
sudo tee /etc/systemd/system/node_exporter.service > /dev/null <<'EOF'
[Unit]
Description=Prometheus Node Exporter
After=network.target

[Service]
User=node_exporter
ExecStart=/usr/local/bin/node_exporter
Restart=on-failure

[Install]
WantedBy=multi-user.target
EOF

sudo systemctl daemon-reload
sudo systemctl enable --now node_exporter
验证服务是否正常,只需确认端口在监听且指标接口能返回数据:
# 端口监听确认
ss -tlnp | grep 9100

# 指标接口抽查(应返回大量 # HELP 开头的文本行)
curl -s http://localhost:9100/metrics | head -20
如果 curl 返回了一堆 # HELP 和 # TYPE 开头的文本,说明 node_exporter 已经在以文本协议暴露指标。返回为空时,先看 journalctl -u node_exporter -n 50 里的服务日志。
安装 Prometheus 并配置抓取任务
有了指标暴露端,接下来让 Prometheus 定时来抓。Prometheus 同样是单文件二进制加一个 YAML 配置文件,解压即可运行:
# 下载并解压(版本号以官网最新稳定版为准)
wget https://github.com/prometheus/prometheus/releases/download/v2.53.0/prometheus-2.53.0.linux-amd64.tar.gz
tar xvfz prometheus-2.53.0.linux-amd64.tar.gz
cd prometheus-2.53.0.linux-amd64
解压后目录里有两个关键文件:prometheus(主程序)和 prometheus.yml(配置文件)。编辑 prometheus.yml,把抓取目标指向服务器的 9100 端口:
global:
  scrape_interval: 15s        # 每 15 秒抓取一次
  evaluation_interval: 15s    # 每 15 秒计算一次告警规则

scrape_configs:
  - job_name: "node"
    static_configs:
      - targets: ["10.0.0.8:9100"]   # 替换为你的服务器 IP
        labels:
          instance: "web-prod-01"     # 起个能认出来的名字
两个参数值得展开说:scrape_interval 决定指标的时间粒度,15 秒是社区最常用的平衡点——抓得太密会增加服务器与存储压力,抓得太稀(比如 5 分钟一次)会漏掉短时尖峰;evaluation_interval 决定告警规则多久算一次,通常与抓取间隔保持一致。
启动后打开 http://<prometheus-ip>:9090/targets,如果 node 这个 target 显示 UP,说明抓取链路已经打通——后面所有图表和告警都以这个状态为前提。
如果你的服务器是对外的 独立服务器 或 VPS,9100 端口建议只对内网或 Prometheus 所在机器放行——node_exporter 本身只读不写,但没必要暴露给全网扫描器。更省心的做法是把监控和业务放在同一台受管服务器上,托管型独立服务器通常支持自主配置防火墙规则,可以直接在服务器管理面板里完成。
看懂 node_exporter 的核心指标
抓取打通之后,先别急着配告警——阈值写错的告警比没有告警更折磨人。node_exporter 暴露的指标有上千个,日常真正常用的是下面几类:
| 指标名称 | 含义 | 典型告警关注点 |
|---|---|---|
node_cpu_seconds_total |
CPU 各状态累计耗时 | 计算使用率,关注持续高于 85% |
node_memory_MemAvailable_bytes |
可用内存 | 低于总内存 10% 时告警 |
node_filesystem_avail_bytes |
文件系统剩余空间 | 低于容量 15% 时预警 |
node_load1 / node_load5 |
1/5 分钟负载均值 | 与 CPU 核数对比判断过载 |
node_network_receive_bytes_total |
网卡收包字节数 | 计算带宽(网络传输容量)用量 |
这些是”计数器”类型的指标,值只会增加不会减少,所以 CPU 使用率这类”百分比”需要用 PromQL(Prometheus 的查询语言)做速率换算。验证表达式最快的方式,是在 Prometheus 自带的 Graph 页面试跑一遍,看曲线是否符合预期。
比如计算 CPU 使用率(排除 idle 状态),在查询框里执行:
100 - (avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100)
内存使用率:
(1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes) * 100
磁盘剩余百分比:
node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"}
  / node_filesystem_size_bytes{fstype!~"tmpfs|overlay"} * 100
在 Graph 页面里,这三条表达式应该画出与 top、free -m、df -h 一致的数值曲线。数值对不上时,优先检查抓取间隔与表达式窗口的匹配——窗口小于抓取间隔两倍时,rate() 算不出有效结果。
写出第一条告警规则并接上通知
查询验证通过的表达式,可以直接升级成告警规则。在 Prometheus 的配置目录下新建 rules/node_alerts.yml:
groups:
  - name: node-alerts
    rules:
      - alert: HighCpuUsage
        expr: 100 - (avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100) > 85
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "实例 {{ $labels.instance }} CPU 使用率过高"
          description: "CPU 使用率已持续 10 分钟高于 85%,当前值 {{ $value | printf \"%.1f\" }}%"

      - alert: LowDiskSpace
        expr: node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"} / node_filesystem_size_bytes{fstype!~"tmpfs|overlay"} * 100 < 15
        for: 10m
        labels:
          severity: critical
        annotations:
          summary: "实例 {{ $labels.instance }} 磁盘空间不足"
          description: "文件系统剩余空间已低于 15%,请尽快清理或扩容"
这里的 for: 10m 是防误报的关键:条件必须连续满足 10 分钟才会真正触发,瞬间的流量尖峰不会吵到任何人。severity 标签用来区分通知等级,warning 可以只进工作群,critical 直接打电话。
规则文件写好后,在 prometheus.yml 里挂载并热加载:
rule_files:
  - "rules/*.yml"
# 语法校验(无输出即通过)
./promtool check rules rules/node_alerts.yml

# 热加载,无需重启进程
curl -X POST http://localhost:9090/-/reload
Prometheus 只负责把告警”算出来”,发通知是 Alertmanager(告警路由与通知组件)的活。最简的邮件配置长这样:
route:
  receiver: "ops-mail"
  group_wait: 30s
  repeat_interval: 4h

receivers:
  - name: "ops-mail"
    email_configs:
      - to: "ops@example.com"
        from: "alert@example.com"
        smarthost: "smtp.example.com:465"
        auth_username: "alert@example.com"
        auth_password: "your-smtp-password"
group_wait: 30s 会把 30 秒内同实例的多条告警合并成一封邮件——磁盘告警往往连带内存、负载一起触发,没有这个合并,一次故障能刷出十几封邮件。重启 Alertmanager 后,可以跑一个 stress-ng --cpu 4 --timeout 900 之类的压测验证告警能否送达邮箱,验证完记得停掉。
如果是托管环境,很多基础指标已由服务商侧代管。虚拟主机 产品通常内置资源用量面板,共享主机场景下不需要自己跑 Prometheus;这套自建方案更适合 VPS 和独立服务器这类拥有完整系统权限的环境。
常见排障:target DOWN 与数据缺失
接入过程里八成的问题集中在两类现象上,排查路径很固定。
target 显示 DOWN。Targets 页面会给出具体错误:connection refused 说明 9100 端口没监听,回服务器看服务状态;context deadline exceeded 是抓取超时,多见于跨公网抓取,改走内网即可;no such host 是 DNS(域名解析)或 IP 写错,先从 Prometheus 机器上 curl 一下 9100 端口验证连通性。
target 是 UP 但查不到数据。先确认查询时间范围,Prometheus 默认只展示最近 1 小时,刚接入的机器要手动拉到”最近 5 分钟”;再核对指标名拼写,node_memory_MemAvailable_bytes 里的 Mem 是大写,写错会返回空结果。
日常运维建议固定三个节奏:每周扫一眼各实例的 CPU 和磁盘曲线趋势;每月用 promtool check rules 复核告警规则,防止指标改名后规则静默失效;每季度把触发过但没实际影响的阈值调高。想深入时,官方文档的 查询基础 章节覆盖了 PromQL 全部运算符,中文社区教程可以作为 服务器运维 实践的补充参考。
总结
这套链路回顾下来只有四步:装 node_exporter 暴露指标、配 Prometheus 抓取、用 PromQL 验证表达式、把验证过的表达式升级为告警并接上通知。之后每新增一台服务器,只需重复第一步和往 static_configs 里加一行 target。
如果你需要更省心的起点,我们建议的做法是:先在一台测试机上把本文流程跑通,确认告警能送达你的邮箱,再推广到生产环境。Hostease 的独立服务器和 VPS 都支持自主管理防火墙规则,可以把 9100 端口限制在监控机网段内。告警接入只是监控的第一步,后续可以考虑接入 Grafana 做可视化看板、用 --collector.systemd 采集服务状态——但先把”故障发生前收到通知”这件事做扎实,再往下走都不迟。