网站商品上千个之后,站内搜索开始又慢又不准:输入一个关键词要等两三秒才出结果,用户搜”无线鼠标”却匹配不到”蓝牙滑鼠”。这类问题的根源在于数据库的 LIKE 模糊查询——它需要逐行扫描全表,数据量越大越慢,而且不理解语义。本文会教你如何用 MeiliSearch(一款开源搜索引擎)改造站内搜索,从部署、数据同步到效果验证完整走一遍,帮助你在生产环境里把搜索响应从秒级降到毫秒级。
为什么 LIKE 查询撑不起站内搜索
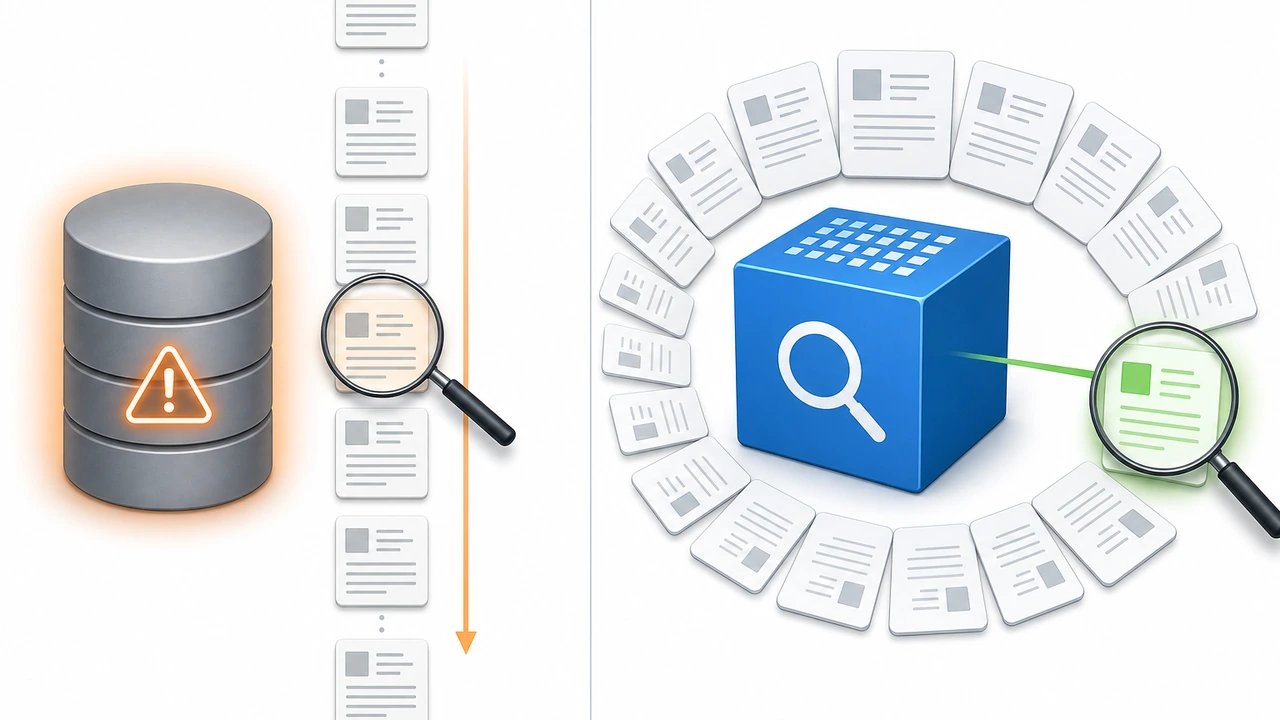
先看一个真实场景。某外贸站用 MySQL 存了 8 万条商品记录,搜索接口是一条典型的模糊查询:
SELECT * FROM products
WHERE title LIKE '%keyword%'
   OR description LIKE '%keyword%'
LIMIT 20;
这条 SQL 在 1 万条数据时响应约 200 毫秒,涨到 8 万条后接近 2 秒。原因有两个:第一,%keyword% 这种前后都带通配符的写法无法使用 B+Tree 索引,数据库只能全表扫描;第二,每新增一个搜索字段,扫描成本就翻一倍。
除了慢,LIKE 还有三个天然缺陷:
- 搜”鼠标”匹配不到”滑鼠”,没有同义词能力
- 用户输错一个字母就零结果,没有容错拼写(typo tolerance)
- 无法按相关性排序,只能按字段或时间排,搜索体验僵硬
这些不是靠加索引、加缓存能解决的——缓存只能挡住重复关键词,长尾搜索依然穿透到数据库。正确的解法是把搜索职责从数据库里拆出来,交给专门的搜索引擎。
MeiliSearch 是什么、凭什么快
MeiliSearch 是一个用 Rust 编写的开源搜索引擎,单二进制文件部署,默认监听 7700 端口,通过 REST API 读写数据。它的核心能力正好对应 LIKE 的四个缺陷:默认开启容错拼写(最多容忍 2 个字符错误)、支持自定义同义词表、内置中文分词、按相关性算法自动排序。
| 对比维度 | 数据库 LIKE 查询 | MeiliSearch |
|---|---|---|
| 8 万条数据响应时间 | 约 2000 毫秒 | 10-30 毫秒 |
| 索引方式 | 全表扫描,无法用索引 | 倒排索引,搜索前预建 |
| 容错拼写 | 不支持 | 默认支持 |
| 中文分词 | 不支持 | 内置支持 |
| 相关性排序 | 不支持 | 内置排序规则 |
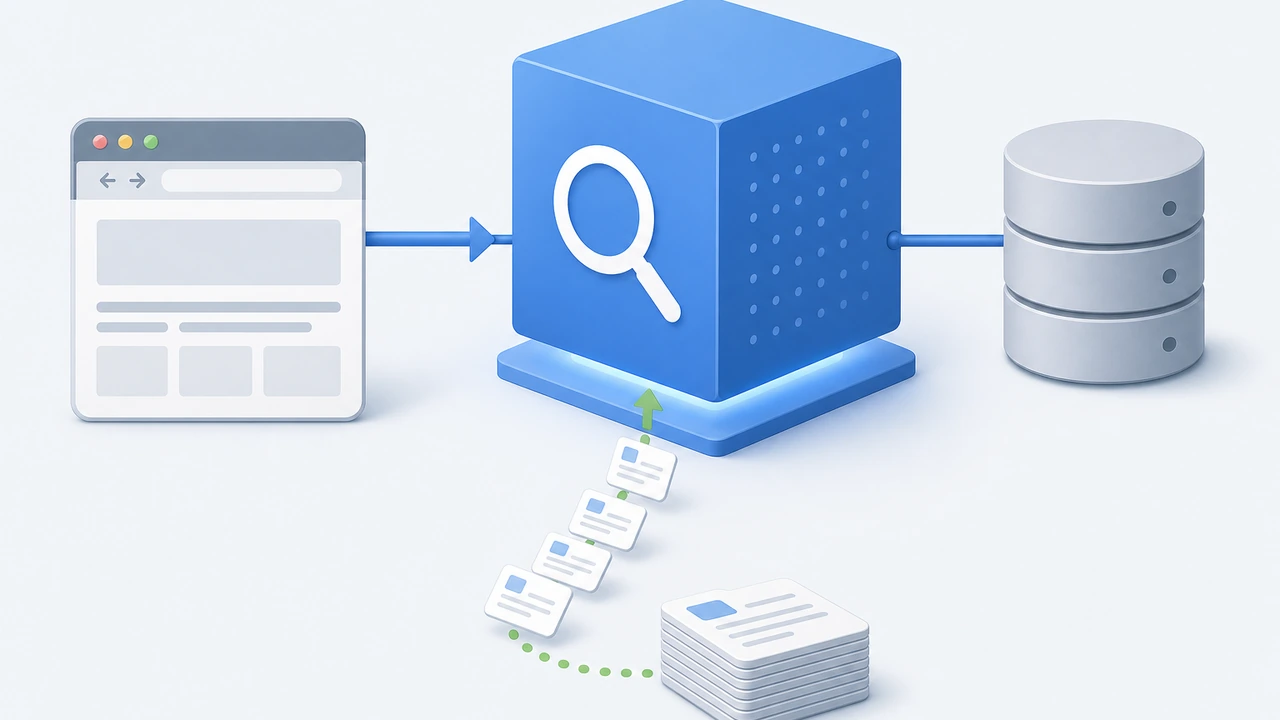
需要注意的是,MeiliSearch 不是数据库的替代品,而是补充:商品、订单这类强事务数据仍然放在 MySQL 里,MeiliSearch 只保存搜索需要的字段(标题、描述、分类、标签),数据变更时同步过去。
部署 MeiliSearch:从安装到第一条搜索
部署过程在 2 核 4GB 的服务器上即可完成。以下步骤以 Linux 服务器为例:
第一步,下载并启动服务:
curl -L https://install.meilisearch.com | sh
export MEILI_MASTER_KEY="你的主密钥至少16位"
./meilisearch --http-addr 127.0.0.1:7700
生产环境必须设置 MEILI_MASTER_KEY,否则任何人都能读写你的搜索数据。同时建议绑定 127.0.0.1 而不是 0.0.0.0,让外部请求统一经过 Nginx 反代,方便加 HTTPS 和访问控制。
第二步,创建索引并设置可搜索字段:
curl -X POST "http://127.0.0.1:7700/indexes" \
  -H "Authorization: Bearer $MEILI_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"uid": "products", "primaryKey": "id"}'

curl -X PUT "http://127.0.0.1:7700/indexes/products/settings" \
  -H "Authorization: Bearer $MEILI_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "searchableAttributes": ["title", "description", "tags"],
    "filterableAttributes": ["category", "price"],
    "synonyms": {"鼠标": ["滑鼠", "mouse"]}
  }'
第三步,批量导入数据并搜索验证:
curl -X POST "http://127.0.0.1:7700/indexes/products/documents" \
  -H "Authorization: Bearer $MEILI_MASTER_KEY" \
  -H "Content-Type: application/x-ndjson" \
  --data-binary @products.jsonl

curl "http://127.0.0.1:7700/indexes/products/search" \
  -H "Authorization: Bearer $MEILI_MASTER_KEY" \
  --data '{"q": "无线鼠标"}'
8 万条记录的导入实测在 30 秒内完成,导入后搜索接口的响应稳定在 10-30 毫秒——对比原来 2 秒的 LIKE 查询,提升了约两个数量级。
数据同步:让搜索结果跟得上业务变化
搜索引擎只在上次同步时才有最新数据,所以同步策略是改造中最关键的一环。按业务对实时性的要求,推荐三种方案:
第一种是定时全量同步,适合数据量小、变更频率低的站点。用 cron 每小时把全量数据导出成 JSONL 再推给 MeiliSearch,实现最简单,代价是搜索结果最多延迟一小时。
第二种是队列增量同步,适合电商这类变更频繁的场景。在商品的增删改代码里发一条消息到队列(Redis、RabbitMQ 都可以),消费者拿到变更后调用 MeiliSearch 的文档接口单条更新。实测单条更新的端到端延迟在 1 秒以内,用户发布新商品后几乎立刻可搜。
第三种是解析数据库日志(CDC),通过订阅 MySQL 的 binlog 捕获变更再写入搜索引擎。这套方案不侵入业务代码,但运维复杂度明显更高,中小站点一般不需要。
无论选哪种,都要在 MeiliSearch 侧开启 updateStatus 监控:每次写文档都会返回一个更新任务 ID,用 GET /tasks/{taskId} 轮询状态,失败时告警重试,避免数据悄悄丢失。
迁移上线与效果验证
切换搜索服务不建议一刀切。稳妥的灰度做法是双写双读:先让 MeiliSearch 与 LIKE 查询并行运行,前端把 10% 的搜索流量切到新引擎,对比两边的结果质量和响应时间;确认无误后逐步放量到 100%,最后移除旧查询代码。
上线后用这组指标做验收:
- 平均响应时间:目标 100 毫秒以内(原 LIKE 方案的 1/10)
- 零结果率:搜不到结果的请求占比,目标从 LIKE 时代的 15% 以上降到 5% 以内
- 搜索转化率:搜索后产生点击或下单的比例,这是最终业务指标
如果服务器资源紧张,也可以把搜索服务与网站一起托管到配置灵活的 VPS(Virtual Private Server,虚拟专用服务器)上,按需扩展内存——MeiliSearch 的内存占用与索引大小正相关,8 万条商品记录的索引实测占用约 300MB。对于不想自己维护服务器环境的站长,Hostease 的虚拟主机方案配合轻量 API 网关也能覆盖中小规模站内搜索场景,具体可以参考虚拟主机方案。
总结与下一步行动
数据库模糊查询撑不起站内搜索,是数据规模增长后的必然问题:LIKE 无法用索引、不理解语义、没有容错,这些短板加索引和缓存都解决不了。MeiliSearch 用倒排索引把搜索响应压到毫秒级,部署成本只有一个二进制文件加一台 2 核 4GB 的服务器。
我们建议的行动顺序是:先在测试环境完成部署和数据导入,用真实商品数据跑通搜索验证;再根据业务变更频率选定同步方案(低频用定时同步,高频用队列增量);最后按 10% 起步灰度切流,用响应时间和零结果率两个指标验收。如果你需要在独立服务器上部署搜索集群或需要配置协助,可以考虑 Hostease 独立服务器,技术支持可以直接协助排查部署问题。更多服务器性能优化内容,可以继续阅读服务器优化专栏与这篇 TTFB 优化指南。