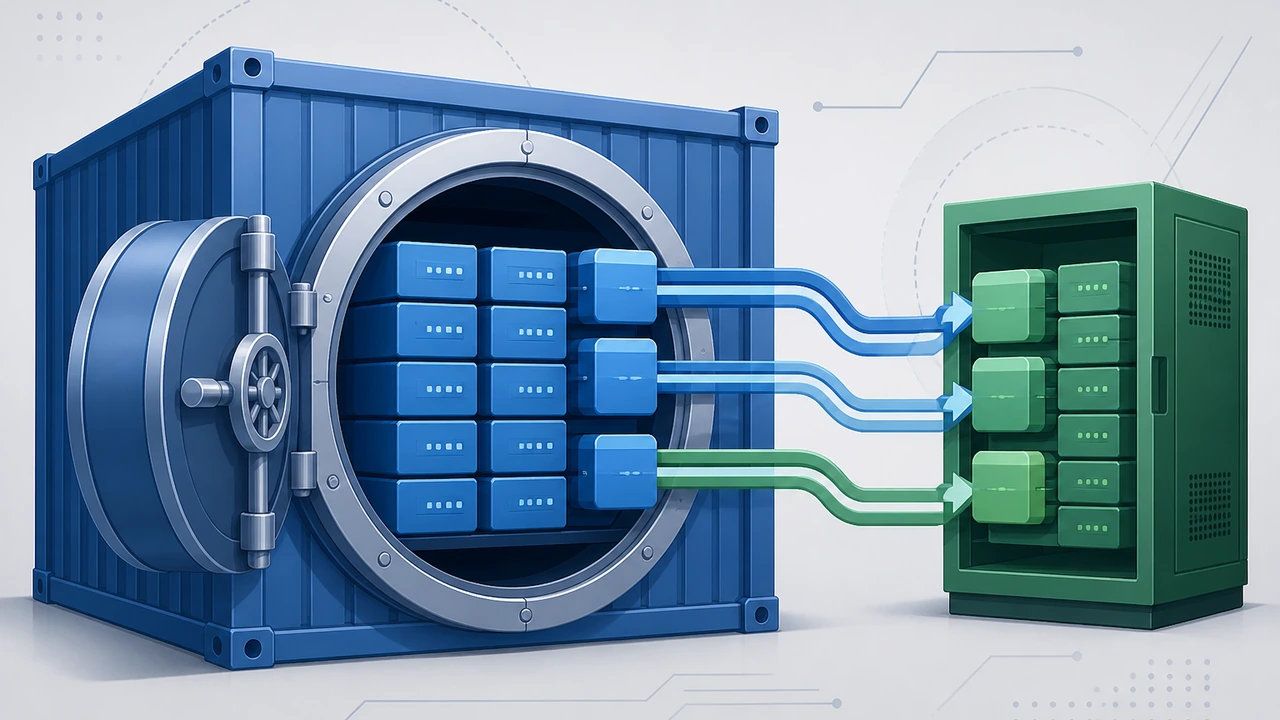
私有镜像仓库备份不是“有空再做”的运维附加项,而是帮助容器发布链路保持连续的基础保障。很多团队把应用镜像、基础镜像、构建产物和回滚版本都放在同一个仓库里,一旦仓库的数据库、对象存储、配置文件或证书损坏,新的服务无法拉取镜像,旧版本也可能无法回退。本文会用一套可落地的指南,说明为什么要拆分备份对象、如何设计恢复顺序,以及怎样通过演练验证私有镜像仓库备份是否真的可用。
先判断:镜像仓库到底承载了哪些发布风险
在容器化环境里,镜像仓库通常位于构建系统、测试环境和生产集群之间。开发提交代码后,流水线会构建镜像、推送到仓库,再由部署系统从仓库拉取指定 tag 或 digest。如果仓库不可用,问题并不只是“管理后台打不开”,而是整条发布链路会被卡住:新版本不能发布,紧急修复不能上线,故障版本也难以及时回滚。
常见风险可以拆成四类:镜像 blob 文件丢失、元数据数据库损坏、仓库配置或密钥丢失、对外访问入口失效。镜像 blob 决定镜像层是否存在,数据库记录项目、标签、扫描状态和用户权限,配置文件保存存储后端、证书、服务地址等关键参数。只备份其中一部分,恢复时就可能出现“文件在,但项目列表为空”或“数据库恢复了,但镜像层无法读取”的尴尬局面。
因此,私有镜像仓库备份的目标不是简单复制一个目录,而是确保“可以在新环境中恢复到可拉取、可推送、可验证”的状态。做这个判断时,可以参考服务器资源和可靠性规划思路,例如 服务器栏目 中关于基础设施选型的内容,把仓库视为发布系统的核心依赖,而不是普通文件服务。
备份对象要完整:镜像层、数据库、配置和证书缺一不可
一个可恢复的镜像仓库备份至少要覆盖四组对象。第一组是镜像存储目录或对象存储桶,它保存实际镜像层;第二组是数据库,它保存项目、仓库、标签、用户、权限和任务状态;第三组是配置文件,包括服务域名、存储驱动、任务队列、日志路径等;第四组是访问凭据,例如 TLS(传输层安全协议)证书、签名密钥、管理员凭据和机器人账号 token。
如果仓库运行在单台云服务器(弹性虚拟服务器)或独立服务器(专用物理服务器)上,还要把系统层面的定时任务、反向代理配置和防火墙规则纳入备份范围。比如 Nginx 反向代理的上传大小限制如果丢失,大镜像推送可能失败;证书链恢复不完整,客户端会在拉取镜像时拒绝连接。类似的上线依赖检查,也可以结合 TTFB 与主机优化指南 的思路,把服务端响应、网络入口和应用配置放在同一张检查表里。
建议用一份清单固定备份对象,避免靠记忆执行:
- 镜像数据:本地 registry 目录或对象存储 bucket,记录容量、路径和同步时间。
- 数据库:PostgreSQL 或 MySQL 导出文件,保存导出命令、字符集和恢复版本。
- 配置密钥:服务配置、TLS(传输层安全协议)证书、签名密钥、机器人账号 token。
- 入口依赖:反向代理配置、防火墙端口、DNS(域名解析系统)记录和健康检查地址。
- 验证样本:至少保留 1 个 200MB 以上业务镜像和 1 个基础镜像用于恢复后拉取测试。
备份频率:按发布节奏而不是按机器目录决定
镜像仓库的变化频率通常高于普通网站文件。一个活跃团队每天可能产生几十个 tag,CI(持续集成)流水线还会推送临时镜像。如果只做每天一次全量备份,下午构建的修复版本可能在晚间故障中丢失。更合理的做法,是按发布节奏设置数据库和镜像层的备份频率:数据库可以每 1 小时或每 4 小时导出一次,镜像层用增量同步保留近 7 天变化,长期归档则保留每周或每月快照。
这里不要只追求“备份越频繁越好”。镜像层体积大,频繁全量复制会占用大量存储和带宽(单位时间可传输的数据量),还可能影响仓库正常推送。实践中可以把策略分为三层:近 24 小时保留高频增量,近 7 天保留每日可恢复点,近 3 个月保留每周归档。对于外贸站点或 SaaS 后台,如果上线频率集中在工作日白天,备份窗口也应避开发布高峰。
下面是一段示例脚本,用来说明备份任务应显式记录数据库、配置和镜像目录。实际路径要按你的部署方式调整,不要直接复制到生产环境执行。
#!/usr/bin/env bash
set -euo pipefail
BACKUP_DIR="/backup/registry/$(date +%F-%H%M)"
mkdir -p "$BACKUP_DIR"

pg_dump -h 127.0.0.1 -U registry registry_db > "$BACKUP_DIR/registry_db.sql"
tar -czf "$BACKUP_DIR/registry_config.tgz" /etc/registry /etc/nginx/conf.d/registry.conf
rsync -a --delete /data/registry/ "$BACKUP_DIR/registry-data/"
sha256sum "$BACKUP_DIR"/* > "$BACKUP_DIR/checksums.txt"
这段脚本的重点不是命令本身,而是思路:每次备份都要留下可核验的校验文件,并把数据库导出、配置归档和镜像层同步放在同一时间点附近。这样恢复时才能判断文件是否完整,而不是等到发布失败后才猜测哪一部分缺失。
恢复顺序:先底座,再数据,最后验证拉取与推送
恢复流程最怕临时拼凑。正确顺序应当是先准备基础环境,再恢复配置和密钥,然后恢复数据库和镜像层,最后用客户端做拉取、推送、权限和回滚验证。如果直接把镜像目录拷回去却没有恢复服务配置,仓库可能启动成功但指向错误存储路径;如果数据库先恢复而对象存储还没同步完成,项目页面能打开,但拉取镜像会报 layer missing。
恢复演练建议至少覆盖以下 4 个动作,并记录实际耗时:
- 新建一台隔离测试服务器,安装同版本仓库服务,记录系统版本和服务版本。
- 恢复配置、证书和数据库后启动服务,确认管理后台、API(应用程序接口)和任务队列正常。
- 拉取指定 digest 的业务镜像,再推送一个测试 tag,验证读写权限没有偏移。
- 将测试环境切换到备用访问域名,检查 DNS(域名解析系统)生效时间和客户端登录流程。
如果你的仓库服务承载生产发布,恢复演练不应只停留在“服务能启动”。更关键的是验证部署系统能否使用原有凭据拉取镜像,以及回滚脚本能否找到历史 tag。很多事故中的真实停机时间,并不是由数据复制决定,而是由权限、证书、域名和客户端缓存问题拖长。
降低单点:备份之外还要考虑入口和存储冗余
备份解决的是“坏了以后能恢复”,但不能完全替代运行时的可用性设计。如果镜像仓库是生产发布的唯一入口,建议至少做三件事:把数据库和镜像层放到可靠存储上,给仓库入口配置健康检查和监控告警,保留一个只读备用仓库或冷备恢复环境。对于访问量较高的业务,还要关注公网带宽(单位时间可传输的数据量)和磁盘 I/O,避免大量节点同时拉取镜像时拖垮仓库。
这类设计要结合成本和团队能力。小团队可以先从“每日恢复演练 + 异地备份 + 备用域名”开始;中大型团队则可以考虑多副本存储、只读缓存节点和分环境镜像隔离。若你正在评估主机资源形态,可以阅读 VPS(虚拟专用服务器)选购指南,把 CPU、内存、磁盘和网络冗余与发布系统需求对应起来。
一个务实的改造顺序是:先保证备份完整,再缩短恢复时间,最后再做运行时冗余。比如先把恢复时间目标定为 2 小时内可完成,再通过自动化脚本把服务部署、数据同步和健康检查串起来。如果团队没有专职运维,Hostease 的服务器类方案可以作为承载仓库、构建节点或备用恢复环境的基础设施选项,但具体架构仍应按镜像体积、发布频率和故障承受时间评估。
验证指标:用 RPO 和 RTO 衡量备份是否合格
判断私有镜像仓库备份是否合格,不能只看“备份任务成功”。更可靠的指标是 RPO(恢复点目标)和 RTO(恢复时间目标)。RPO 回答最多能丢失多久的数据,例如 4 小时内构建的镜像是否可以接受丢失;RTO 回答从故障发生到仓库恢复可用最多允许多久,例如 30 分钟、2 小时或 1 个工作日。
可以把验证表设计成固定格式:每月选择一个备份点,恢复到隔离环境,记录数据包大小、恢复耗时、失败步骤、拉取测试结果和推送测试结果。连续 3 次演练后,团队通常就能看清真正瓶颈:可能是镜像层同步太慢,也可能是证书和机器人账号找不到,还可能是文档缺少关键命令。
最后建议把私有镜像仓库备份纳入发布前检查,而不是只归档在灾备文档里。每次调整仓库版本、存储后端、证书或域名时,都应同步更新备份清单,并在 24 小时内做一次小规模恢复测试。如果你还管理 WordPress 或其他业务站点,也可以参考 WordPress 运维相关内容,把备份、监控、恢复演练整理成统一的运维节奏。总结来说,可靠的镜像仓库不是“从不出问题”,而是在问题发生时仍然知道数据在哪里、服务如何恢复、发布链路怎样重新跑通。