快照做得越勤,数据越安全,账单也越刺眼——这是很多站长第一次收到云服务器(以虚拟化方式提供的弹性计算资源)存储账单时的共同感受。为什么有人每月快照费用不到 10 美元,有人却超过实例本身的价格?差异往往不在数据量,而在策略。这篇指南帮你把快照频率、保留周期和存储类型这三个变量拆开分析,用恢复点目标(RPO,Recovery Point Objective,指发生故障时最多可容忍丢失多少时间内的数据)倒推参数,而不是凭感觉点按钮,最终在数据安全和存储成本之间找到可量化的平衡点。
先想清楚:故障发生时你能接受丢多少数据
快照策略的第一步不是打开控制面板,而是回答一个问题:如果服务器在任意时刻宕机,业务最多能承受丢失多久的数据?这个答案就是 RPO,它是整个策略的锚点,频率和保留周期都应由它推导,而不是反过来。
四类典型业务的 RPO 参考值差异很大:静态企业官网的内容更新频率低,24 小时的 RPO 通常可以接受,甚至用每日离线备份就够了;内容型博客和资讯站一般定在 1-4 小时;电商或订单类业务每笔交易都是真金白银,RPO 需要压到 15-60 分钟;数据库主节点、支付网关这类核心组件则要求接近实时的 5 分钟级保护——但到了这个级别,单靠快照已经不够,还需要binlog(二进制日志,数据库的增量操作记录)配合实现任意时间点恢复。
RPO 定得越紧,快照频率就越高,成本也随之上升。把 24 小时的 RPO 压到 1 小时,意味着快照数量变成 24 倍,虽然单个增量快照只记录变化块,但累计的存储占用和 API 调用依然可观。所以合理的做法是先给不同业务定级,再分层配置,避免用最高标准保护所有资产。关于如何评估云服务器(Cloud Server,弹性伸缩的虚拟计算实例)的整体可靠性指标,可以参考我们之前的服务器运维基础文章进一步了解。
全量还是增量:先算清存储成本这笔账
主流云平台的快照几乎都采用 ROW(Redirect on Write,写时重定向)机制:第一次快照是全量,记录磁盘所有数据块;之后的快照只记录自上一时间点以来发生变化的数据块。理解这个机制,是算清成本账的前提。
增量机制的好处是单个快照体积小、创建速度快。一台系统盘实际占用 40GB 的服务器,日常运行时每小时的数据变化量往往只有几百 MB,意味着每小时增量快照的新增存储远小于全量。但增量结构也有代价:恢复时需要按链条回放所有依赖块,链条越长,恢复耗时越长,任何一环损坏都可能影响整条链的可用性。
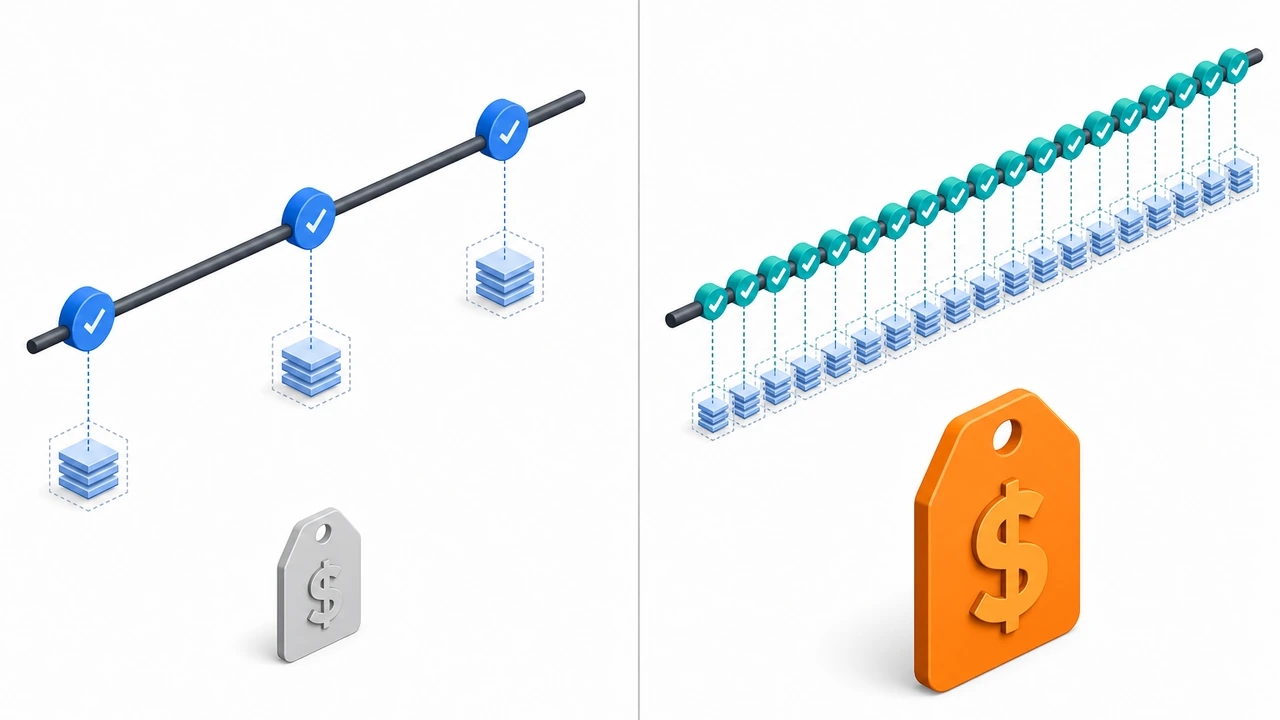
成本估算可以用一个简化模型。以实际占用 100GB 的磁盘为例:仅保留每日 1 个快照、保留 7 天,若每天变化量约 5%,稳态存储约为 100GB 全量加上 7 × 5GB 增量,合计约 135GB;若改为每小时 1 个、保留 7 天,按同样变化量折算增量部分约 35GB,合计也在 135GB 上下——看起来接近,但保留周期拉长到 30 天时,前者增长到约 250GB,后者会突破 400GB。这就是”频率 × 保留周期”的乘数效应:两个参数各翻一倍,成本接近翻两番。
还有一个常被忽略的规则:删除旧快照并不一定释放空间。因为数据块是被多个快照共享的,只有当某个块不再被任何保留中的快照引用时才会真正释放。所以策略上线后要观察实际计费曲线,前几个周期费用逐渐爬升属于正常现象,稳态通常出现在保留周期满一轮之后。
一套可直接套用的分层策略模板
算完成本账,接下来把 RPO 落成具体配置。分层的好处是避免”一刀切”:核心资产获得高频保护,边缘资产用低频策略省下预算。以下模板按业务等级划分,参数可以根据实际变化量微调。
- 核心层(RPO 15-30 分钟):数据库盘、支付与订单服务。每小时 2-4 个快照,保留 2-3 天;数据库另开 binlog 或 WAL(Write-Ahead Log,预写日志)实现分钟级任意时间点恢复,快照只作为整盘兜底
- 重要层(RPO 1-4 小时):业务应用服务器、WordPress 站点。每 1-2 小时 1 个快照,保留 7 天,另加每日 1 个保留 14 天的中期点
- 标准层(RPO 24 小时):静态官网、内部工具、测试环境。每日 1 个快照,保留 7-14 天即可
配置保留策略时优先用平台原生的规则引擎,而不是手动删除。例如 AWS(Amazon Web Services,亚马逊云服务)的 DLM(Data Lifecycle Manager,数据生命周期管理)和阿里云的自动快照策略,都支持”每小时 N 个、保留最近 N 个”的滚动窗口,到期自动清理,避免忘删导致费用失控。
变更窗口要单独考虑。服务器升级内核、批量改配置前,手动打一个带标签的临时快照并延长保留,确认稳定后再删除——这类快照的恢复价值远高于日常时间点,值得为它多花几天存储费。如果你的业务跑在 WordPress(开源内容管理系统)上,升级插件和主题同样适用这个原则,相关风险可以参考这篇WordPress 运维基础文章。
数据盘和系统盘建议分开打快照。系统盘重装即可重建,保留 3-5 个最近快照足够;数据盘才是策略重点,应按上文分层标准配置。把两者混用同一套高频策略,是成本浪费的常见来源。
高频踩坑点与恢复演练
策略配置完成只是上半场,真正决定快照价值的是恢复环节。以下四个坑在日常运维中出现频率最高,每一个都对应真实的数据丢失案例。
- 只创建快照,从不演练恢复:至少每季度选一台非核心服务器做一次完整回滚,记录恢复耗时,验证 RTO(Recovery Time Objective,恢复时间目标)是否达标
- 快照与备份混为一谈:快照通常存放在同区域存储,区域级故障可能连同源盘一起丢失,重要数据需定期导出镜像或同步到异地
- 快照前不做数据一致性处理:数据库写入过程中打的快照可能包含半截事务,MySQL 建议先执行 FLUSH TABLES WITH READ LOCK 或依赖 InnoDB crash recovery,尽量安排在低峰期
- 忽略快照数量上限与配额:多数平台对单盘快照数有上限(常见 256 个),超限会导致新快照创建失败,配额告警要纳入监控
演练时建议用”克隆盘”而不是原地回滚:先把快照恢复成一块新磁盘挂载到临时实例验证数据完整性,确认无误再切换。原地回滚会覆盖当前数据,如果快照本身有问题就没了退路。
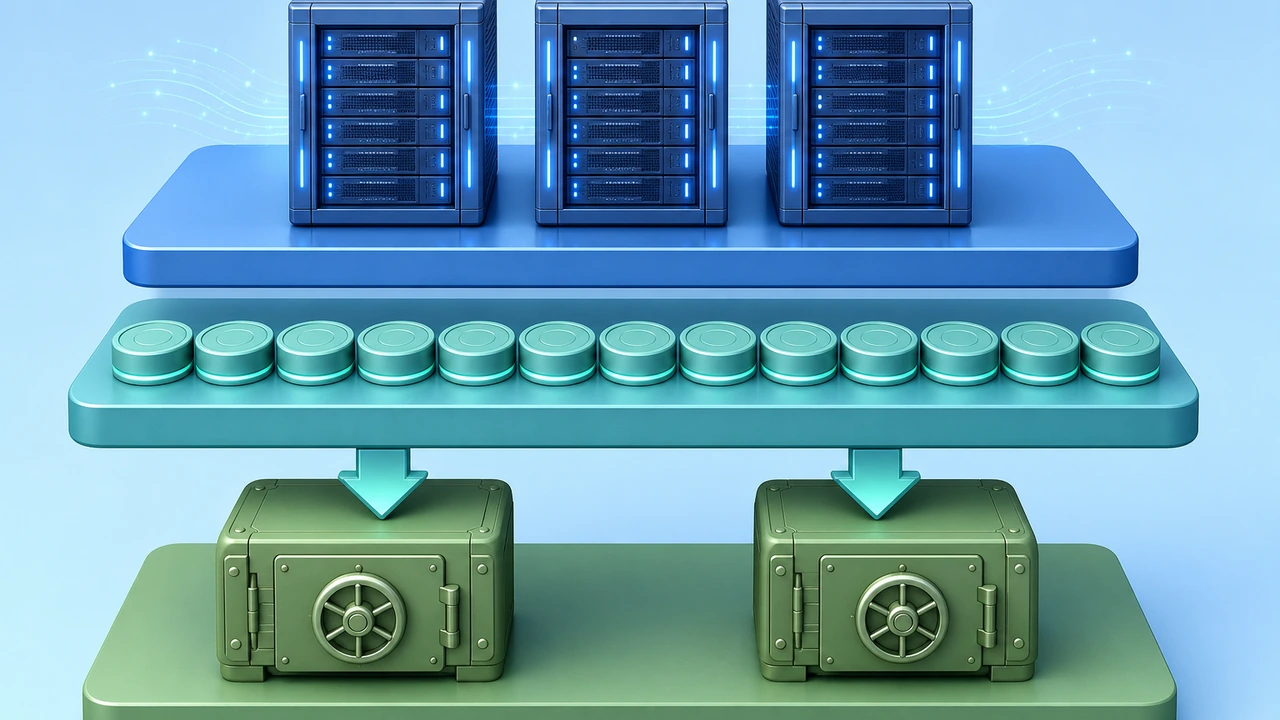
存储类型的选择也会显著影响成本。标准存储适合需要频繁恢复的近期快照;低频或归档存储适合长期保留的合规副本,单价可能只有标准存储的三分之一,但恢复时需要先解冻,耗时从几分钟到数小时不等。合理的做法是近期快照留在标准存储,超过 30 天的合规副本转入低频层。关于存储与整体性能的权衡,这篇网站性能优化指南中有更多实测数据可以参考。
总结:把策略文档化并定期复核
回到最初的问题:快照频率和保留周期不是拍脑袋定的,而是由 RPO 推导、用成本模型验证、靠恢复演练兜底的完整闭环。建议你按这个顺序落地:先给所有云服务器资产按业务等级打标签,再套用上文三层模板生成初始配置,两周后检查实际计费曲线并微调,最后把最终参数写进运维文档,每季度复核一次。
成本优化往往藏在复核里:清理早已下线服务器的遗留快照、把不再需要高频保护的降级到标准层、确认自动清理规则真的在生效——这些动作通常能在不损失保护水平的前提下砍掉 20%-30% 的快照支出(具体比例随数据变化量浮动,价格与配额以各平台官网实时信息为准,截至 2026 年 9 月)。如果你需要一个支持自动快照与镜像导出的执行底座,可以考虑 Hostease 云服务器方案,其控制面板提供快照与备份管理功能;不过无论用什么平台,”RPO 分层 + 定期演练”这套方法论都同样适用。推荐你现在就动手:从最核心的那台数据库服务器开始套用模板,两周后再看计费曲线。