网站访问量逐步攀升,数据库服务器的 CPU 与磁盘 I/O 频繁告警,前端页面响应变慢——这是许多站长在业务扩张期面对的典型瓶颈。大多数 Web 应用呈现“读多写少”的特征,如果将全部查询与写入集中在单一数据库节点上,不仅响应受限,单点故障还会导致全站瘫痪。本指南将帮助你掌握 MySQL 主从复制的搭建方案,从一主一从的 GTID 基础配置、应用侧读写分离实现,到复制延迟的系统排查路径,解决单点数据库的性能瓶颈与可用性难题。
对网站性能而言,数据库查询往往是首屏响应延迟的核心源头。结合首字节时间(TTFB)优化分析可知,剥离只读流量可以让主库专心处理写入事务,从而压低 SQL 查询等待并提升并发承载能力。
主从复制的工作机制:Binlog、Relay Log 与 GTID
在动手配置之前,理清复制背后的数据流转机制,有助于后续快速定位同步异常。
MySQL 的主从复制基于二进制日志(Binlog)与中继日志(Relay Log)协同工作,由三个核心线程驱动:主库事务提交后写入 Binlog,Binlog Dump 线程将日志事件通过网络推送给从库;从库 I/O 线程接收数据并写入本地 Relay Log;随后从库 SQL 线程持续读取 Relay Log 并重放事务,实现数据同步。为保证一致性,推荐使用 ROW 行级日志格式(binlog_format = ROW)。
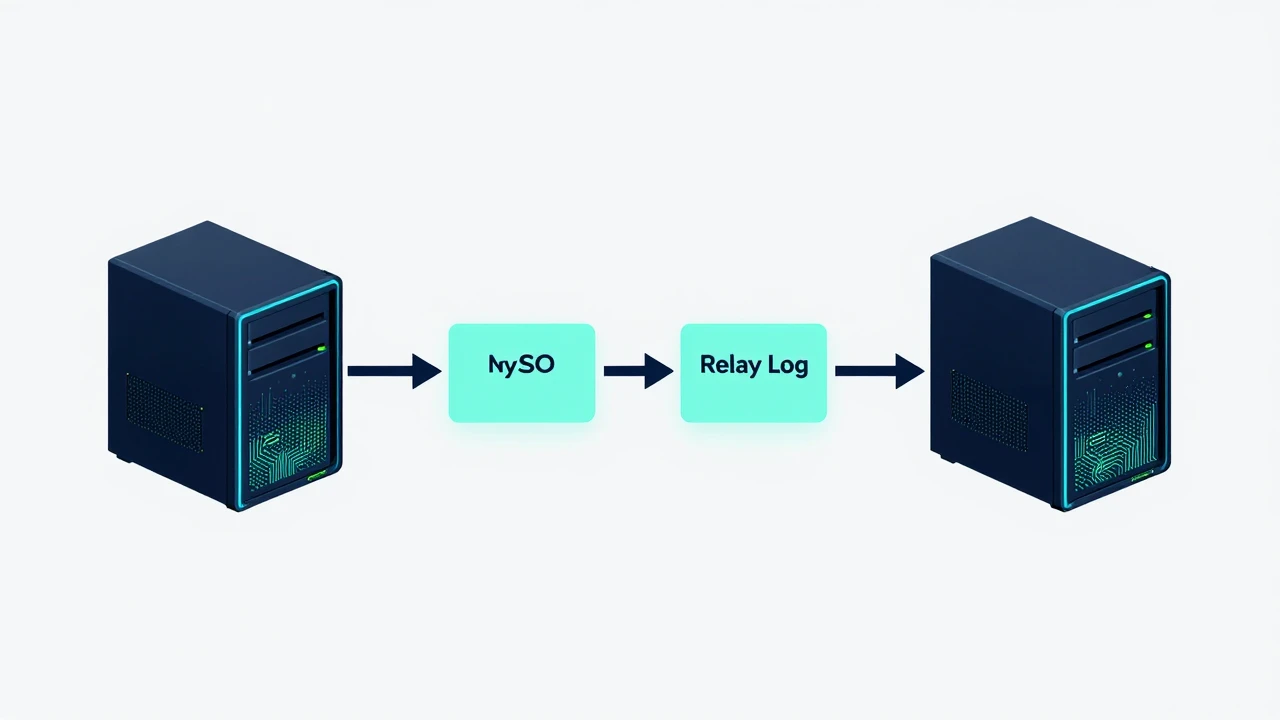
需要明确的是,MySQL 原生主从复制是异步的,存在延迟窗口,不能当作强一致方案。主库提交事务无需等待从库确认即可向客户端返回成功。在高并发或网络抖动时,从库读取可能存在短暂的数据不一致,敏感业务需在应用层针对性规避。
在同步模式上,传统 binlog 位点方式需要手动记录 Log File 与 Position,主从对齐容易出错。现代架构更推荐采用 GTID(全局事务标识符)模式。GTID 为每个事务分配全局唯一标识,从库自动比对已执行集合并拉取缺失日志,极大简化了集群维护与故障切换的复杂度。
最小化环境搭建:一主一从 GTID 复制实操
下面以一台主库(Master)和一台从库(Slave/Replica)的最小化架构为例演示 GTID 复制搭建。两台服务器建议部署在同一局域网通过私有 IP 通信。准备服务器环境时,可参考服务器运维基础中的网络配置指南。
第一步:主库配置与复制账号授权
修改主库配置文件(通常为 /etc/my.cnf,参数配置以官方版本文档为准),在 [mysqld] 段中追加关键参数:
[mysqld]
server-id = 1
log-bin = mysql-bin
binlog_format = ROW
gtid_mode = ON
enforce_gtid_consistency = ON
重启主库服务后登录 MySQL,创建专用于主从复制的账号并授权,限制从库私有 IP 访问:
CREATE USER 'repl_user'@'192.168.1.20' IDENTIFIED BY 'YourSecurePasswordHere';
GRANT REPLICATION SLAVE ON *.* TO 'repl_user'@'192.168.1.20';
FLUSH PRIVILEGES;
第二步:主库数据导出与从库恢复
若主库已有存量业务数据,在开启复制前需导出一致性备份。推荐使用 mysqldump 结合事务与 GTID 导出参数:
mysqldump -u root -p --all-databases --single-transaction --master-data=2 --set-gtid-purged=ON > /backup/master_init.sql
将备份文件传输至从库服务器并在从库全量导入:
mysql -u root -p < /backup/master_init.sql
第三步:从库配置与建立同步关系
修改从库配置文件,分配独立的 server-id 并开启只读保护以防业务误写:
[mysqld]
server-id = 2
relay-log = mysql-relay-bin
gtid_mode = ON
enforce_gtid_consistency = ON
read_only = ON
super_read_only = ON
重启从库服务后登录,执行同步指令(MySQL 8.0 推荐 CHANGE REPLICATION SOURCE TO,5.7 对应 CHANGE MASTER TO,具体语法以官方版本文档为准)。启用 GTID 自动位点无需手动填写 binlog 坐标:
CHANGE REPLICATION SOURCE TO
  SOURCE_HOST = '192.168.1.10',
  SOURCE_PORT = 3306,
  SOURCE_USER = 'repl_user',
  SOURCE_PASSWORD = 'YourSecurePasswordHere',
  SOURCE_AUTO_POSITION = 1;

START REPLICA;
启动后执行 SHOW REPLICA STATUS\G 检查状态,重点确认两项均为 Yes:
- Replica_IO_Running: Yes(通信通畅,顺利接收中继日志)
- Replica_SQL_Running: Yes(从库 SQL 线程正常重放事务)
网站读写分离接入:应用层与代理中间件
主从通道建立后,从库默认不分担业务查询。需在应用架构中引入读写分离机制,将写入请求分发至主库、只读查询路由至从库。
在实际落地中,读写分离通常有以下两种实现路径:
方案一:应用层框架多数据源路由
在 Web 应用内部配置读写双连接池。主流开发框架均支持通过注解或上下文动态切换数据源:只读查询绑定从库连接,写操作与事务绑定主库连接。
以常见建站系统为例,在WordPress 运维中,站长可利用 HyperDB 或 LudicrousDB 模块扩展原生数据库接口,按读写类型与节点权重分配流量,无需改动核心代码。此方式无额外网络跳步,但连接池开销随应用实例数增多而放大。
方案二:数据库中间件代理分流
在 Web 服务与数据库之间部署代理中间件(如 ProxySQL 或 MySQL Router)。应用统一连接中间件虚拟端口,由中间件负责解析 SQL 语法树并完成路由:
- 自动将匹配到的 SELECT 查询分发给从库节点。
- 将 INSERT、UPDATE、DELETE 及显式事务转发至主库。
- 内置连接池复用与节点故障自动隔离能力。
中间件方案对业务代码透明,便于集中管理,但需额外维护代理组件的稳定性。
必须防范的业务陷阱:写后即读一致性
在落地读写分离时,必须防范“写后即读”导致的体验异常。由于主从复制存在异步延迟窗口,若用户在完成个人信息修改或下单支付后页面立即发起查询,若查询落到尚未同步完成的从库,用户就会看到旧数据产生误判。工程上的规避建议是:对于强时效性业务(如资料保存后的首次回显),在应用层通过 Session 或时间戳在写操作后的短时间内强制路由主库,其余常规展示性流量再分流至从库。
复制延迟(Seconds_Behind_Master)成因与排查路径
在实际运行中,从库可能出现同步滞后的情况。执行 SHOW REPLICA STATUS\G 时,Seconds_Behind_Master 参数直观反映了从库当前落后主库的估算秒数。
当 Seconds_Behind_Master 持续非零或大幅波动时,常见成因与系统化排查路径如下:
- 大事务阻塞回放:主库单次执行大批量更新、删除或长耗时 DDL 操作,打包为单个事务传至从库。从库 SQL 线程必须完整重放整个事务,期间阻塞后续所有事务回放。排查时可通过 SHOW PROCESSLIST 观察 SQL 线程状态,解决方案是将大事务拆解为小批次循环提交。
- 单线程回放瓶颈:主库通常拥有多个并发连接并行写入,而从库默认采用单一 SQL 线程串行重放,写入吞吐上升时易出现堆积。解决方式是在从库开启多线程并行复制(调整 replica_parallel_workers 或 5.7 版本的 slave_parallel_workers,以官方版本文档为准)提升回放吞吐。
- 从库硬件规格落后:部分团队为从库配置较低规格硬件,但从库同样需承担查询并发与落盘回放。若从库磁盘 I/O 或内存缓存不足易成为短板,主从硬件配置应保持基准对等。
- 从库慢查询引发锁冲突:从库承载的复杂分析型查询若执行过久,可能长时间持有元数据锁或行锁,导致更新操作处于锁等待状态。应定期分析慢查询日志,完善索引设计,避免全表扫描。
架构演进与服务器选型建议
搭建主从复制是网站由单机走向分布式高可用架构的重要基础。判断是否引入该架构,主要看两个指标:一是读写比特征,查询流量远高于写入且主库负载偏高时,读写分离能有效释放主库压力;二是容灾考量,配置实时从库也是防止单机硬件故障造成服务中断的必备手段。
在基础设施规划层面,主从架构要求至少两台独立的计算节点:
- 对于成长期的中小型业务与个人站长,选择两台处于同一内网的VPS 云主机搭建一主一从集群是兼顾成本与灵活性的方案,依托内网专线可实现稳定同步,且便于根据流量弹性调整计算资源。
- 对于高并发交易、写操作频繁或数据体量较大的核心业务,更推荐将主库部署在硬件资源独享的独立服务器上。独立服务器能够提供专属物理核心与高速 NVMe 存储阵列,杜绝多租户 I/O 争抢,确保写入高吞吐,再配合多台从库承担分布式只读流量,构建高可用数据库底座。
总结与行动建议
MySQL 主从复制将单一数据库的读写负载有效解耦,配合读写分离能够显著提升站点的并发响应能力与容灾韧性,是网站高可用改造的核心技术。
构建数据库高可用体系是一项循序渐进的系统工程。我们建议站长首先在测试环境中完整演练 GTID 配置与数据恢复,确认通道健康后再推进读写分离改造;业务上线前务必梳理写后即读逻辑,避免异步延迟影响终端体验。如果你需要搭建高并发、低延迟的生产数据库环境,可以考虑基于 Hostease 高性能服务器与内网通道构建主从集群,让网站数据库在业务规模扩张时依然稳健从容。